[Kubeflow Pipelines] 머신러닝 플랫폼 엔지니어링: MLflow와 Feast - 4.1.2. 2주차 실습 환경 구성
서종호(가시다)님의 Machine Learning Platform Engineering Study 2주차 학습 내용을 기반으로 합니다.
TL;DR
- 2주차의 MLflow, Feast, Kubeflow Pipelines(KFP)는 S3 호환 객체 저장소와 Kubernetes 클러스터를 공유한다. 세 도구를 쓰기 전에 이 기반을 먼저 세운다
- 책 부록은 Kubeflow 전체와 MinIO를 전제하고, 가시다님은 x86 서버의 k3s에 Kubeflow 전체를 올렸다. 나는 1주차의 kind 클러스터에 파이프라인 기능만 있는 KFP standalone 2.17.3을 올렸고, 여기에는 MinIO 대신 SeaweedFS가 들어 있다. S3 API는 같아서 책 코드의 클라이언트는 그대로 쓴다
- Apple Silicon Mac에서는 세 가지가 달랐다. kind 클러스터 생성 때 매핑하지 않은 NodePort 30008은 socat 컨테이너로 열었고, arm64 이미지가 없는 metadata-writer는 amd64 digest로 고정해 Rosetta로 띄웠으며, MLflow 서버는 AirPlay 수신기가 점유한 5000 대신 5050에 띄웠다
- KFP 설치는 덧셈 두 단계짜리 파이프라인을 한 번 실행해 확인했다. Argo Workflow와 파드가 만들어지고, 로그에 계산 결과가 찍히며, 파이프라인 패키지와 산출물이 SeaweedFS의
mlpipeline버킷에 남는다. SeaweedFS는 버킷 생성과 이 산출물 저장으로, MLflow는 상태 점검과 기본 실험의 아티팩트 위치로 확인했다 - 챕터 폴더에서
uv run을 실행하면 루트 가상 환경이 잡힌다. MLflow UI에 3.17.1이 표시된 뒤 알았고, 이후 챕터 도구는.venv/bin/<명령>으로 실행한다. Feast 온라인 스토어인 Redis는 4.2절 실습에서 구성한다
2주차 실습 환경의 구성
책 4장 도입과 부록의 환경 구성에 대응하는 실습이다. 4장은 소득 구간을 분류하는 이진 분류기를 소재로 MLflow에 실험을 기록하고 Feast에 피처를 등록하며, 5장은 그 모델과 피처로 KFP 추론 파이프라인을 만든다. 세 도구가 공유하는 것은 둘이다. 데이터셋·모델 아티팩트·피처 레지스트리·파이프라인 산출물을 담는 S3 호환 객체 저장소와, KFP와 Redis가 실행될 Kubernetes 클러스터다. 노트북은 이 둘에 닿을 수 있는 곳에서 실행돼야 한다.
책과 스터디 환경의 차이
책은 Kubeflow 전체를 설치한 클러스터의 MinIO를 객체 저장소로 쓰고, MLflow는 로컬에서 실행한다. 가시다님은 x86 서버 한 대의 k3s에 Kubeflow 전체(KFP 2.4.0)를 올리고, MinIO와 Redis를 NodePort로 열고, MLflow와 Jupyter를 서버의 systemd 사용자 서비스로 띄웠다. 내 Mac은 3.1편의 kind 클러스터를 그대로 쓰되, 그 위에 올린 것이 다르다.
| 항목 | 책(부록) | 스터디(가시다님) | 내 Mac |
|---|---|---|---|
| Kubernetes | Kubeflow 1.7 전체 | k3s 1.29, Kubeflow 전체(KFP 2.4.0), Dex 로그인 | kind v1.29.14(arm64), KFP standalone 2.17.3, 단일 사용자 |
| 객체 저장소 | Kubeflow의 MinIO | MinIO, S3 NodePort 30010, 콘솔 30009 | SeaweedFS 4.34(KFP 매니페스트 포함), port-forward로 9000 |
| MLflow | 2.6.0, mlflow ui |
3.0.0 server, 0.0.0.0:5000, systemd |
3.0.0 server, 127.0.0.1:5050, 터미널 실행 |
| 아티팩트 | 로컬 mlruns |
s3://mlflow-artifacts/chapter-4 |
같은 경로, 저장소만 SeaweedFS |
| Redis | 부록 매니페스트 | 네임스페이스 redis, NodePort 30006 |
미구성(4.2절에서) |
| 노트북 | 로컬 venv | 서버 Jupyter :8888, 비밀번호 로그인 |
챕터 .venv의 Jupyter Lab :8888 |
가시다님 환경과 내 Mac의 차이는 대부분 접속 경로에서 생긴다. 서버 환경에서는 NodePort와 LAN IP로 모든 서비스에 닿지만, Docker Desktop의 kind는 노드 IP로 직접 라우팅되지 않아 호스트 포트 매핑이나 kubectl port-forward가 필요하다. 이 차이는 3.3.1편의 포트 연결 방식 비교에서 정리했다.
KFP standalone 설치 자체는 스터디 멤버 김정혁님이 정리한 macOS의 kind K8s에 MLflow 디플로이먼트와 KFP standalone을 올리고 파이프라인을 실행한 기록을 따랐다. 거기에 SeaweedFS 버킷 구성, MLflow 서버, 노트북 환경을 내 실습에 맞게 붙였다.
내 Mac 구성도
구성 요소와 연결 경로를 한 장에 모으면 다음과 같다. 2026-10-29 실측 기준이다.
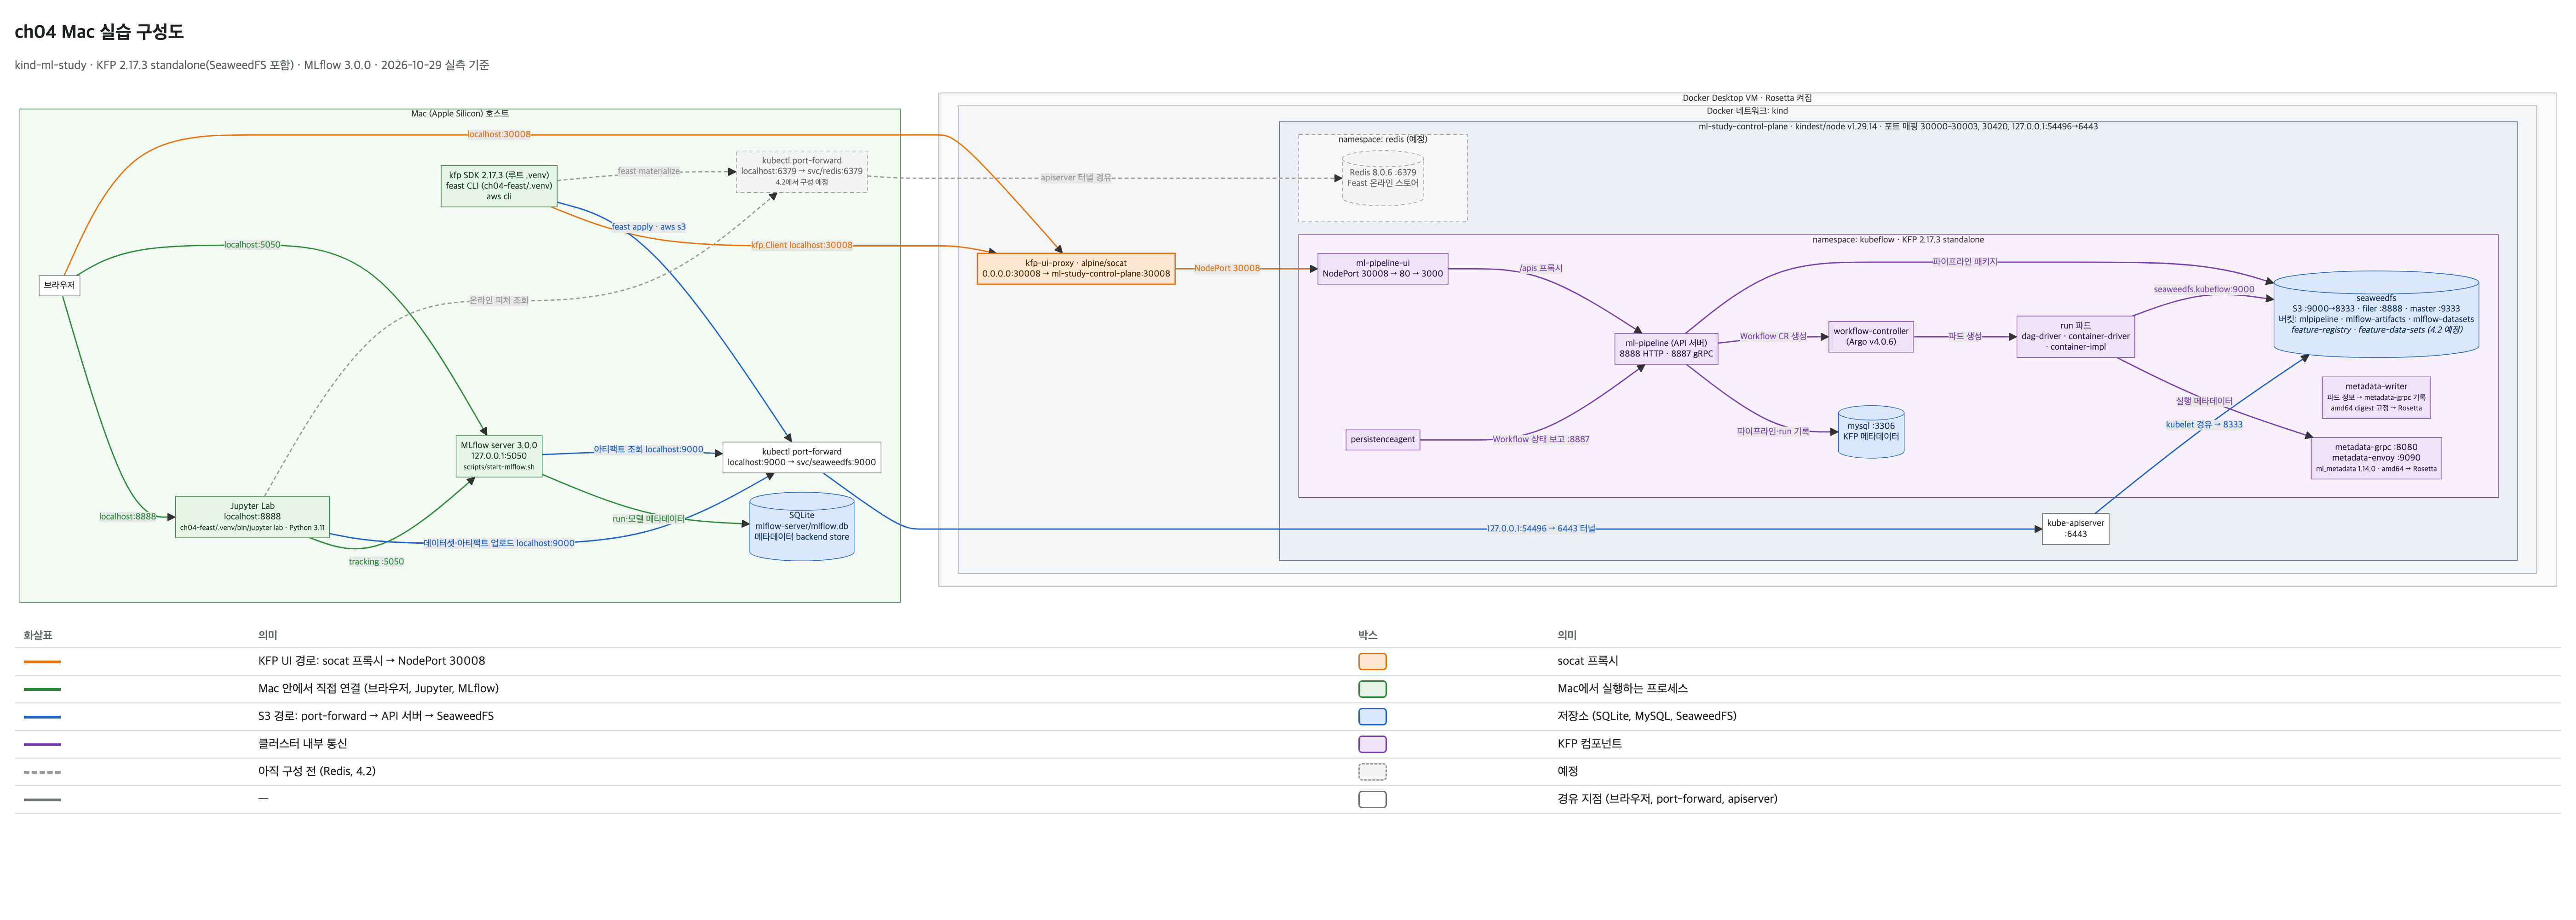
연결 경로는 네 갈래다.
- Mac 안에서 끝나는 직결: 브라우저 → Jupyter, Jupyter → MLflow, MLflow → SQLite
- KFP UI와 API로 가는 경로: 브라우저와 kfp SDK → socat 프록시 → 노드의 NodePort 30008 → UI 파드
- S3로 가는 경로: Jupyter·MLflow·CLI →
localhost:9000→ port-forward → API 서버 → SeaweedFS 파드 - 클러스터 안에서만 도는 KFP 내부 통신
Mac에서 열리는 포트를 정리하면 다음과 같다.
| Mac 주소 | 연결 경로 | 용도 |
|---|---|---|
localhost:8888 |
Mac 프로세스 | Jupyter Lab |
127.0.0.1:5050 |
Mac 프로세스 | MLflow UI와 tracking API |
localhost:30008 |
socat 컨테이너 → 노드 NodePort 30008 → ml-pipeline-ui 파드 |
KFP UI와 API |
localhost:9000 |
kubectl port-forward → API 서버 → seaweedfs 파드 8333 |
S3 API(MLflow, Feast, aws cli) |
127.0.0.1:54496 |
kind가 생성 때 매핑한 포트 → 노드 6443 | kubectl, port-forward 터널 |
30000~30003, 30420 |
kind extraPortMappings |
3장의 Gitea·Argo CD·Prometheus·Grafana·NodePort 실습용 |
localhost:6379 |
아직 없음 | Feast 온라인 스토어 Redis, 4.2절에서 구성 |
구성 요소의 역할
kubeflow 네임스페이스에는 Deployment 14개가 올라간다. 설치 뒤 실측한 목록은 다음과 같다.
kubeflow 네임스페이스의 Deployment, Service, PVC, Secret, ConfigMap (2026-10-29 실측)
# Deployment 14개
kubectl -n kubeflow get deploy
# NAME                              READY   UP-TO-DATE   AVAILABLE
# cache-deployer-deployment         1/1     1            1
# cache-server                      1/1     1            1
# metadata-envoy-deployment         1/1     1            1
# metadata-grpc-deployment          1/1     1            1
# metadata-writer                   1/1     1            1
# ml-pipeline                       1/1     1            1
# ml-pipeline-persistenceagent      1/1     1            1
# ml-pipeline-scheduledworkflow     1/1     1            1
# ml-pipeline-ui                    1/1     1            1
# ml-pipeline-viewer-crd            1/1     1            1
# ml-pipeline-visualizationserver   1/1     1            1
# mysql                             1/1     1            1
# seaweedfs                         1/1     1            1
# workflow-controller               1/1     1            1

# Service 8개 (ml-pipeline-ui만 NodePort로 바꾼 상태)
kubectl -n kubeflow get svc
# NAME                              TYPE        CLUSTER-IP      PORT(S)
# cache-server                      ClusterIP   10.96.39.209    443/TCP
# metadata-envoy-service            ClusterIP   10.96.14.33     9090/TCP
# metadata-grpc-service             ClusterIP   10.96.70.200    8080/TCP
# ml-pipeline                       ClusterIP   10.96.57.76     8888/TCP,8887/TCP
# ml-pipeline-ui                    NodePort    10.96.57.241    80:30008/TCP
# ml-pipeline-visualizationserver   ClusterIP   10.96.81.184    8888/TCP
# mysql                             ClusterIP   10.96.78.240    3306/TCP
# seaweedfs                         ClusterIP   10.96.220.169   8111/TCP,8333/TCP,9000/TCP,9333/TCP,19333/TCP,18888/TCP,8888/TCP

# PVC 2개
kubectl -n kubeflow get pvc
# NAME             STATUS   CAPACITY   ACCESS MODES   STORAGECLASS
# mysql-pv-claim   Bound    20Gi       RWO            standard
# seaweedfs-pvc    Bound    20Gi       RWO            standard

# Secret 3개, ConfigMap 9개 (이름만)
kubectl -n kubeflow get secret,cm -o name
# secret/mlpipeline-minio-artifact
# secret/mysql-secret
# secret/webhook-server-tls
# configmap/kfp-cluster-scoped-params
# configmap/kfp-launcher
# configmap/kube-root-ca.crt
# configmap/kubeflow-pipelines-public
# configmap/metadata-envoy-configmap
# configmap/metadata-grpc-configmap
# configmap/ml-pipeline-ui-configmap
# configmap/pipeline-install-config
# configmap/workflow-controller-configmap
KFP 문서와 매니페스트를 기준으로 역할을 나누면 다음과 같다.
| 구성 요소 | 역할 |
|---|---|
ml-pipeline-ui |
웹 UI. 브라우저의 /apis 요청을 API 서버로 프록시한다 |
ml-pipeline |
API 서버(HTTP 8888, gRPC 8887). 파이프라인·실험·run을 기록하고 파이프라인 패키지를 객체 저장소에 저장한다 |
workflow-controller |
Argo Workflows v4.0.6 컨트롤러. run마다 만들어지는 Workflow 리소스를 파드로 실행한다 |
ml-pipeline-persistenceagent |
Workflow 상태를 API 서버에 보고한다 |
ml-pipeline-scheduledworkflow |
반복 실행(Recurring Run)을 관리한다 |
metadata-grpc-deployment, metadata-envoy-deployment, metadata-writer |
ML Metadata(MLMD) 저장소와 그 앞의 gRPC-web 프록시, 실행 정보를 MLMD에 기록하는 writer |
cache-server, cache-deployer-deployment |
같은 입력의 컴포넌트 실행 결과를 재사용하는 실행 캐시 |
ml-pipeline-viewer-crd, ml-pipeline-visualizationserver |
산출물 뷰어와 시각화 서버 |
mysql |
파이프라인·run·MLMD 메타데이터 저장소 |
seaweedfs |
파이프라인 패키지와 실행 산출물을 담는 S3 호환 객체 저장소 |
Pipelines가 Argo Workflows를 백엔드로 쓰는 층 구조는 GenAI on K8s 11.4에 정리돼 있다.
상태를 담는 저장소는 세 곳으로 갈린다. KFP의 메타데이터는 클러스터 안 MySQL에, MLflow의 실험·run·모델 메타데이터는 Mac의 SQLite 파일에, 파일 산출물은 세 도구 모두 SeaweedFS에 둔다. 클러스터를 지우면 MySQL과 SeaweedFS의 PVC도 같이 사라지지만, Mac의 SQLite는 남는다.
Kubeflow Pipelines standalone 해부
Kubeflow 전체 대신 standalone을 고른 이유
책 부록은 Kubeflow 전체를 설치한다. Kubeflow는 프로그램 하나가 아니라 파이프라인 백엔드, Argo Workflows, 객체 저장소, MySQL, Istio, Knative, Dex, 대시보드 같은 수십 개 컴포넌트의 묶음이고, 컴포넌트마다 자기 이미지를 쓴다. 전체를 올리려면 그 이미지가 모두 받아지고 이 노드에서 돌아야 한다. 3.1편의 실습 가능 여부 판정 기준에서 2주차 점검 대상 이미지를 약 80개로 잡았던 이유가 이것이다.
1주차에 그 점검을 해 보니 전체 설치는 Mac이 아니어도 그대로는 어려웠다. 책이 쓰는 Kubeflow 1.7 이미지 가운데 파이프라인 프런트엔드, argoexec, MinIO, oidc-authservice 같은 일부가 레지스트리에서 내려가 있었다. 여기에 Mac에서는 arm64 이미지가 있는지와 Docker Desktop VM 메모리가 더 걸린다.
그래서 이번 실습에 실제로 필요한 것이 무엇인지로 돌아갔다. 4장은 MLflow와 Feast를 쓰고 5장은 파이프라인을 쓴다. 대시보드, 노트북 서버, 하이퍼파라미터 튜닝, 서빙, 로그인은 쓰지 않는다. KFP standalone은 이 묶음에서 파이프라인 기능만 떼어 낸 구성이다. Deployment 14개, Service 8개, PVC 2개로 끝나고 로그인이나 사용자별 네임스페이스가 없으며, 메모리 요청량(requests)의 합은 약 3.1GiB다. Kubeflow 생태계의 나머지 컴포넌트가 무엇인지는 GenAI on K8s 11.2에 정리돼 있다. 가시다님은 x86 서버라 Kubeflow 전체를 그대로 썼다.
매니페스트 구조
KFP 매니페스트는 kustomize로 배포하며, GitHub 저장소의 경로를 ?ref=<태그>로 직접 가리킬 수 있다. 두 단계로 나뉜다.
| 단계 | 경로 | 내용 |
|---|---|---|
| 1 | manifests/kustomize/cluster-scoped-resources |
네임스페이스 kubeflow, CRD 11개(Argo Workflows 8개, scheduledworkflows·viewers.kubeflow.org, applications.app.k8s.io), 클러스터 범위 권한 |
| 2 | manifests/kustomize/env/platform-agnostic |
Deployment 14, Service 8, PVC 2, ConfigMap 7, Secret 2, NetworkPolicy 1, ServiceAccount 15, Role·RoleBinding 각 11, PriorityClass 1 |
2단계의 숫자는 2.17.3 태그를 kubectl kustomize로 렌더해 센 것이다. 현행 설치 문서의 예시는 env/dev인데, 이 kustomization은 env/platform-agnostic을 그대로 포함한 위에 Google Cloud 콘솔 연동용 Application 컨트롤러와 inverse proxy를 더하고 KFP 이미지 태그를 master로 바꾼 개발용 구성이다. 특정 버전을 고정해 설치하려면 레거시 V1 로컬 배포 문서가 쓰는 env/platform-agnostic 쪽이 맞고, 나도 공유된 정리대로 이쪽을 썼다. 이 kustomization이 SeaweedFS base를 포함한다. 두 문서 모두 kind와 Apple Silicon에 대한 안내는 없다.
적용과 관찰: 설치
버전을 변수로 두고 두 단계를 차례로 적용했다. 아래 ~/ml-study는 실습 저장소 경로를 줄인 표기다.
# 설치할 KFP 버전
~/ml-study$ export PIPELINE_VERSION=2.17.3

# 1단계: 네임스페이스와 CRD, 클러스터 범위 권한
~/ml-study$ kubectl apply -k "github.com/kubeflow/pipelines/manifests/kustomize/cluster-scoped-resources?ref=$PIPELINE_VERSION"

# CRD가 등록될 때까지 대기
~/ml-study$ kubectl wait --for condition=established --timeout=60s crd/applications.app.k8s.io
customresourcedefinition.apiextensions.k8s.io/applications.app.k8s.io condition met

# 2단계: 워크로드
~/ml-study$ kubectl apply -k "github.com/kubeflow/pipelines/manifests/kustomize/env/platform-agnostic?ref=$PIPELINE_VERSION"
적용 직후 파드 하나가 ImagePullBackOff에 머물렀다. 이 사례는 트러블슈팅 사례 1에서 다루고, 아래는 그 조치 뒤의 상태다.
# kubeflow 네임스페이스의 파드와 이미지
kubectl -n kubeflow get pods

# 실행 결과: 14개 모두 Running
# NAME                                               READY   STATUS    RESTARTS
# cache-deployer-deployment-5557d4f9-94j29           1/1     Running   0
# cache-server-689d66bc7c-qxhd8                      1/1     Running   0
# metadata-envoy-deployment-549ffbdc7d-zcxn2         1/1     Running   0
# metadata-grpc-deployment-746dc5f6fb-qbmkk          1/1     Running   0
# metadata-writer-bb8f799f7-jglr8                    1/1     Running   0
# ml-pipeline-79c665b75f-qhs6v                       1/1     Running   0
# ml-pipeline-persistenceagent-57769f6c7-mt6ml       1/1     Running   0
# ml-pipeline-scheduledworkflow-667f66c7ff-lvlxp     1/1     Running   0
# ml-pipeline-ui-66b678b478-76chv                    1/1     Running   0
# ml-pipeline-viewer-crd-7db7bb9dc9-54grv            1/1     Running   0
# ml-pipeline-visualizationserver-6968b954bc-7ttms   1/1     Running   0
# mysql-5956b464b6-2vj8b                             1/1     Running   0
# seaweedfs-5c8559f74-x8p2p                          1/1     Running   0
# workflow-controller-989c9d967-875fk                1/1     Running   0
PVC 두 개는 kind의 기본 StorageClass standard(local-path 프로비저너)로 바인딩됐다. WaitForFirstConsumer 모드라 파드가 배치된 뒤에 볼륨이 만들어진다.
# 영구 볼륨 요청 상태
kubectl -n kubeflow get pvc

# 실행 결과
# NAME             STATUS   CAPACITY   ACCESS MODES   STORAGECLASS
# mysql-pv-claim   Bound    20Gi       RWO            standard
# seaweedfs-pvc    Bound    20Gi       RWO            standard
설치 뒤 노드 컨테이너의 메모리 사용량은 약 4.4GiB였다. 이 값에는 3장에서 올린 Gitea·Argo CD·실습 파드가 포함돼 있고, Docker Desktop VM 상한은 3.1편에서 올린 16GB 그대로다.
arm64에서 다른 두 이미지
KFP 2.17.x 이미지는 대부분 amd64와 arm64를 함께 제공한다. 예외가 둘이다.
| 이미지 | 매니페스트 | arm64 노드에서의 동작 |
|---|---|---|
ghcr.io/kubeflow/kfp-metadata-writer:2.17.3 |
manifest list에 linux/amd64와 빌드 증명(attestation)만 |
플랫폼 항목이 없어 pull 실패 → amd64 digest로 고정 |
gcr.io/tfx-oss-public/ml_metadata_store_server:1.14.0 |
단일 매니페스트(플랫폼 목록 없음) | 그대로 받아져 Rosetta로 실행 |
둘의 차이는 이미지가 manifest list인지 단일 매니페스트인지에서 온다. manifest list를 받을 때 컨테이너 런타임은 노드 아키텍처에 맞는 항목을 고르는데, arm64 항목이 없으면 no match for platform in manifest 오류로 끝난다. 단일 매니페스트 이미지는 고를 목록 자체가 없어 그대로 내려받고, 실행 시점에 Docker Desktop의 Rosetta가 amd64 바이너리를 번역한다. 매니페스트 종류와 다이제스트는 컨테이너 이미지 글과 3.2.2편에 정리돼 있다.
# 레지스트리의 매니페스트에서 플랫폼 항목만 추출(2026-10-29)
docker manifest inspect ghcr.io/kubeflow/kfp-metadata-writer:2.17.3

# 실행 결과 발췌: amd64 항목과 빌드 증명뿐이다
# "platform": { "architecture": "amd64", "os": "linux" }
# "platform": { "architecture": "unknown", "os": "unknown" }

docker manifest inspect ghcr.io/kubeflow/kfp-api-server:2.17.3
# 실행 결과 발췌: arm64 항목이 있다
# "platform": { "architecture": "arm64", "os": "linux" }
# "platform": { "architecture": "amd64", "os": "linux" }
Rosetta는 Docker Desktop 설정 General 탭의 “Use Rosetta for x86_64/amd64 emulation on Apple Silicon” 항목이다. 릴리스 노트에 따르면 4.25.0부터 macOS 14.1 이상에서 기본으로 켜져 있고, 이 Mac(Docker Desktop 4.37.2)에서도 켜져 있었다. 이 설정을 끈 상태는 시험하지 않았다.
KFP 쪽에서도 이 둘을 arm64 지원의 남은 과제로 보고 있다. linux/arm64 지원 umbrella 이슈는 kfp-metadata-writer를 amd64 전용으로 표시하고, ML Metadata 이미지가 amd64 전용이라 공식 arm64 지원은 MLMD를 제거하는 3.0 이후로 둔다고 적는다.
UI 접근 경로: NodePort 30008과 socat 프록시
UI를 브라우저에서 열려면 ml-pipeline-ui Service에 Mac에서 닿아야 한다. 원본 매니페스트의 이 Service는 type이 없는 ClusterIP라, 먼저 NodePort 30008로 바꿨다.
# UI Service를 NodePort 30008로 변경(파드 포트는 3000)
kubectl -n kubeflow patch svc ml-pipeline-ui --type merge -p \
  '{"spec":{"type":"NodePort","ports":[{"port":80,"targetPort":3000,"nodePort":30008}]}}'
그런데 Docker Desktop의 kind에서는 노드의 NodePort가 Mac에 자동으로 열리지 않는다. 1주차에 만든 클러스터는 30000~30003과 30420만 호스트에 매핑했고(3.3.1편의 kind 클러스터 구성 해부), 30008은 없다.
# 노드 컨테이너의 호스트 포트 매핑
docker port ml-study-control-plane

# 실행 결과
# 6443/tcp -> 127.0.0.1:54496
# 30000/tcp -> 0.0.0.0:30000
# 30001/tcp -> 0.0.0.0:30001
# 30002/tcp -> 0.0.0.0:30002
# 30003/tcp -> 0.0.0.0:30003
# 30420/tcp -> 0.0.0.0:30420
kind의 extraPortMappings는 kind create cluster --config로 넘기는 생성 시점 설정이고, kind 설정 문서는 생성 후 매핑을 바꾸는 절차를 제공하지 않는다. 노드 컨테이너의 포트 매핑은 컨테이너를 만들 때 정해진다. 그래서 Mac에서 30008로 들어가는 방법은 셋이다.
| 방법 | 동작 | 제약 |
|---|---|---|
| 클러스터 재생성 | extraPortMappings에 30008을 추가해 다시 만든다 |
3장에서 올린 리소스와 방금 만든 PVC가 함께 사라진다 |
kubectl port-forward svc/ml-pipeline-ui 8080:80 |
API 서버를 거쳐 Service까지 터널을 연다 | 터미널 하나를 계속 점유하고, 세션이 끊기면 다시 열어야 한다. NodePort를 지나지 않는다 |
| 중계 컨테이너 | kind 노드가 붙어 있는 Docker 네트워크 kind에 컨테이너를 하나 띄워 Mac의 30008을 노드의 30008로 TCP 중계한다 |
컨테이너 하나가 더 돈다 |
나는 중계 컨테이너를 골랐다. 백그라운드에서 계속 떠 있고 --restart unless-stopped로 Docker Desktop을 다시 켜도 따라 올라오므로, port-forward처럼 터미널을 지키거나 끊길 때마다 다시 열 필요가 없다. 브라우저와 kfp SDK가 같은 주소 localhost:30008을 쓰고, 요청이 실제 NodePort를 지나므로 Service 설정이 틀리면 바로 드러난다. 재생성은 데이터를 잃는 대가가 컸다.
# kind 네트워크에서 Mac의 30008을 노드의 30008로 중계하는 socat 컨테이너
docker run -d --name kfp-ui-proxy --restart unless-stopped \
  --network kind -p 30008:30008 \
  alpine/socat TCP-LISTEN:30008,fork,reuseaddr TCP:ml-study-control-plane:30008
--network kind로 노드 컨테이너와 같은 네트워크에 붙였으므로 컨테이너 이름 ml-study-control-plane이 그대로 해석된다. -p 30008:30008은 Mac의 30008을 이 컨테이너에 연결하고, socat은 들어온 연결을 노드의 30008로 넘긴다. kind는 v0.8.0부터 기본 브리지 대신 kind라는 전용 네트워크에 노드를 만들며, 로컬 레지스트리 문서도 같은 방식으로 컨테이너를 이 네트워크에 붙인다.
참고: socat
socat(SOcket CAT)은 두 바이트 스트림을 양방향으로 잇는 중계 도구다. 한쪽을 듣고 다른 쪽으로 연결해 데이터를 그대로 넘긴다. 위 명령의 첫 번째 주소
TCP-LISTEN:30008,fork,reuseaddr는 30008에서 TCP 연결을 받되 연결마다 자식 프로세스를 만들어(fork) 여러 연결을 동시에 처리하고, 재시작 때 같은 포트를 바로 다시 쓸 수 있게(reuseaddr) 한다. 두 번째 주소TCP:ml-study-control-plane:30008은 받은 연결을 넘길 목적지다.alpine/socat은 socat만 들어 있는 작은 이미지다.
# 프록시 컨테이너와 노드 컨테이너의 포트
docker ps --format 'table {{.Names}}\t{{.Ports}}'

# 실행 결과 발췌
# kfp-ui-proxy             0.0.0.0:30008->30008/tcp
# ml-study-control-plane   0.0.0.0:30000-30003->30000-30003/tcp, 0.0.0.0:30420->30420/tcp, 127.0.0.1:54496->6443/tcp

# Mac에서 UI 응답 확인
curl -s -o /dev/null -w '%{http_code}\n' localhost:30008/
# 200
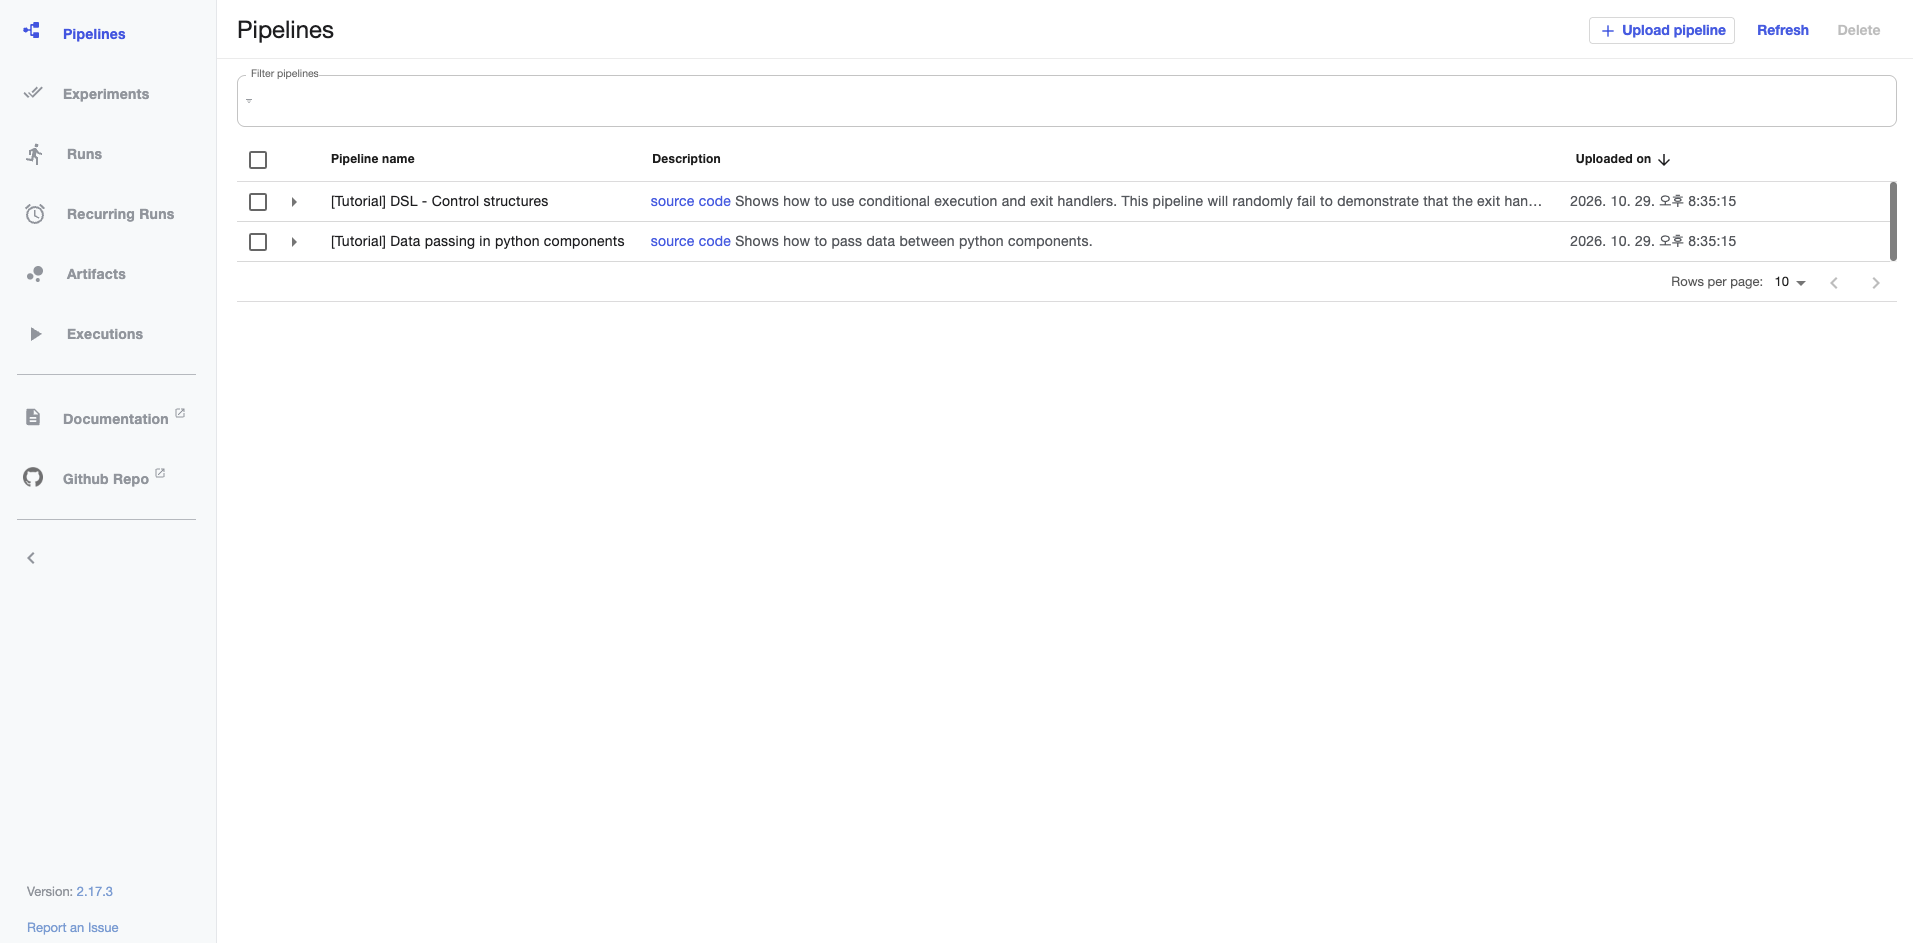
브라우저의 요청은 Mac의 30008 → socat 컨테이너(kind 네트워크 172.18.0.3) → 노드 컨테이너의 30008(NodePort) → kube-proxy → ml-pipeline-ui 파드의 3000으로 간다. kfp SDK도 같은 주소 http://localhost:30008을 쓴다.
객체 저장소: MinIO 대신 SeaweedFS
KFP 2.15부터 기본 저장소가 바뀐 경위
책과 가시다님 환경은 MinIO를 쓰는데 내 클러스터에는 SeaweedFS가 있다. 설치한 KFP 버전 때문이다. KFP 2.15.0 릴리스 노트는 기본 객체 저장소 배포를 MinIO에서 SeaweedFS로 바꿨다고 적고, “MinIO remains fully supported (as is any S3-compliant object store)”라며 기본 배포 구성만 바뀐 것이라고 덧붙인다. 바꾼 이유는 릴리스 노트에 없고, 교체 PR #11965는 CVE 대응과 유지보수성·멀티테넌시를, 2022년에 열린 이슈 #7878은 MinIO의 AGPLv3 전환을 든다.
2.17.3 매니페스트에는 MinIO용 구성이 남아 있지 않다. 2.15의 레거시 MinIO 매니페스트가 가리키는 옛 MinIO 이미지는 Docker Hub에서 denied로 받아지지 않았다(2026-10-29). 그래서 “MinIO를 쓸 것인가”가 아니라 “SeaweedFS로 책 실습이 되는가”가 질문이 됐다. 책 코드가 쓰는 클라이언트는 minio-py, s3fs(Feast), boto3(MLflow)이고 셋 다 S3 API만 호출한다. 서버가 MinIO든 SeaweedFS든 엔드포인트와 자격 증명만 맞으면 된다. 이 글에서 확인한 호출은 버킷 생성과 목록 조회(minio-py), 파이프라인 패키지와 산출물 저장(KFP), MLflow 아티팩트 루트 등록까지다. 데이터셋 업로드와 모델 아티팩트 저장은 4.1절 실습에서 확인한다.
서비스 포트와 S3 호환 경로
SeaweedFS 파드는 weed server 하나로 마스터·볼륨·filer·S3 게이트웨이·IAM을 함께 띄운다. Service에는 포트가 일곱 개 열려 있다.
# seaweedfs Service의 포트 이름과 대상 포트
kubectl -n kubeflow get svc seaweedfs -o jsonpath='{range .spec.ports[*]}{.name}{" "}{.port}{" -> "}{.targetPort}{"\n"}{end}'

# 실행 결과
# http-iam 8111 -> 8111
# http-s3 8333 -> 8333
# http-s3-compat 9000 -> 8333
# http-master 9333 -> 9333
# grpc-master 19333 -> 19333
# grpc-filer 18888 -> 18888
# http-filer 8888 -> 8888

# 파드의 실행 인자
kubectl -n kubeflow get deploy seaweedfs -o jsonpath='{.spec.template.spec.containers[0].args}'
# ["server","-dir=/data","-s3","-iam","-filer","-master.volumePreallocate=false"]
S3 게이트웨이의 실제 포트는 SeaweedFS 기본값 8333이고, 9000은 http-s3-compat라는 이름으로 8333을 가리킨다. Service 매니페스트의 주석은 “legacy port를 기대하는 설정과의 하위 호환”이라고만 적는다. MinIO의 기본 포트가 9000이므로 그 설정을 뜻한다고 읽히지만 주석에 MinIO라는 단어는 없다. KFP 자신도 run의 Workflow에 seaweedfs.kubeflow.svc:9000을 아티팩트 저장소로 넣는다.
자격 증명은 Secret mlpipeline-minio-artifact에 있다. 이름이 MinIO 시절 그대로이고, SeaweedFS 파드는 이 Secret을 환경 변수로 읽어 시작 직후 s3.configure로 관리자 계정을 만들고 mlpipeline 버킷을 생성한다. 값은 KFP 매니페스트에 들어 있는 공개 기본값이지만, 스크립트에서는 Secret에서 읽어 쓴다.
# S3 자격 증명을 Secret에서 읽어 환경 변수로 내보내기
export AWS_ACCESS_KEY_ID=$(kubectl -n kubeflow get secret mlpipeline-minio-artifact -o jsonpath='{.data.accesskey}' | base64 -d)
export AWS_SECRET_ACCESS_KEY=$(kubectl -n kubeflow get secret mlpipeline-minio-artifact -o jsonpath='{.data.secretkey}' | base64 -d)
책 코드가 기대하는 Service 이름 minio-service는 5장 파이프라인의 파드가 클러스터 안에서 쓴다. 그 이름 문제는 5장 실습에서 별칭 Service로 다룬다.
NetworkPolicy가 정하는 배치 조건
매니페스트에는 NetworkPolicy가 하나 들어 있고 대상이 SeaweedFS다. 어디에서 온 트래픽만 받는지가 이후 Redis와 Feast 작업을 어느 네임스페이스에 둘지를 정한다.
# seaweedfs NetworkPolicy의 spec (kubectl -n kubeflow get networkpolicy seaweedfs -o yaml 발췌)
spec:
  podSelector:
    matchExpressions:
      - { key: app, operator: In, values: [seaweedfs] }
  policyTypes: [Ingress]
  ingress:
    # 1) kubeflow-profile 라벨이 있는 네임스페이스의 파드 → 8333
    - from:
        - namespaceSelector:
            matchExpressions:
              - { key: app.kubernetes.io/part-of, operator: In, values: [kubeflow-profile] }
      ports: [{ port: 8333, protocol: TCP }]
    # 2) istio-system 네임스페이스 → 모든 포트
    - from:
        - namespaceSelector:
            matchExpressions:
              - { key: kubernetes.io/metadata.name, operator: In, values: [istio-system] }
    # 3) 같은 네임스페이스(kubeflow)의 모든 파드 → 8333
    - from:
        - podSelector: {}
      ports: [{ port: 8333, protocol: TCP }]
세 규칙 모두 S3 포트 8333 기준이고, 허용 대상은 kubeflow 네임스페이스의 파드, 프로필 라벨이 붙은 네임스페이스, Istio 네임스페이스다. standalone에는 프로필도 Istio도 없으므로 사실상 kubeflow 안의 파드만 S3에 닿는다. kind의 기본 CNI인 kindnet이 이 정책을 실제로 집행한다는 점은 3.3.2편에서 확인했다.
여기서 배치 조건이 나온다. 5장에서 피처 레지스트리를 만드는 Feast Job처럼 S3를 읽어야 하는 파드는 kubeflow 네임스페이스에 두거나 네임스페이스에 라벨을 붙여야 한다. 반면 Redis는 Feast 클라이언트가 접속하는 쪽이지 S3를 읽지 않으므로 별도 네임스페이스여도 된다. Mac에서 port-forward로 들어가는 접속은 이 정책에 막히지 않았다. 이 경로는 API 서버와 kubelet을 거쳐 파드로 들어가며, 이 글에서 쓴 버킷 생성과 MLflow 아티팩트 루트 등록이 모두 이 경로였다.
적용과 관찰: port-forward와 버킷 생성
SeaweedFS에는 MinIO 콘솔 같은 버킷 관리 화면이 없다. 파드 안의 weed shell로 버킷을 확인하고, Mac에서는 port-forward로 S3 API를 열어 클라이언트로 버킷을 만들었다.
# 파드 안에서 버킷 목록 조회 (설치 직후)
echo "s3.bucket.list" | kubectl -n kubeflow exec -i deploy/seaweedfs -- /usr/bin/weed shell
#   mlpipeline    size:16616      chunk:10

# 터미널 A: Mac의 9000을 Service의 9000(→ 파드 8333)에 연결. 실습 내내 켜 둔다
kubectl -n kubeflow port-forward svc/seaweedfs 9000:9000
# Forwarding from 127.0.0.1:9000 -> 8333
책 README는 MLflow용 버킷 mlflow-datasets만 만들라고 하지만, 가시다님 구성처럼 아티팩트 루트도 S3에 두려면 mlflow-artifacts가 더 필요하다. minio-py로 둘을 만들었다. 라이브러리 이름은 MinIO지만 S3 API 클라이언트라 SeaweedFS에도 그대로 쓴다.
# seaweedfs/make_buckets.py: 없는 버킷만 만들고 목록을 출력한다
# 자격 증명은 Secret mlpipeline-minio-artifact의 값을 넣는다
from minio import Minio

c = Minio("localhost:9000", "<accesskey>", "<secretkey>", secure=False)
for b in ("mlflow-artifacts", "mlflow-datasets"):
    c.bucket_exists(b) or c.make_bucket(b)
print([b.name for b in c.list_buckets()])
# 터미널 B: 챕터 가상 환경의 파이썬으로 실행
~/ml-study/chapters/ch04-feast$ .venv/bin/python seaweedfs/make_buckets.py
['mlflow-artifacts', 'mlflow-datasets', 'mlpipeline']
filer에는 파일 브라우저 UI가 있어 버킷 안을 눈으로 볼 수 있다. filer의 8888은 Jupyter 기본 포트와 겹치므로 Mac 쪽 포트를 18888로 바꿔 포워딩했다. 포트가 겹치는 것은 Mac에서 여는 쪽뿐이고, 파드 안의 8888과 Mac의 Jupyter 8888은 서로 다른 네트워크 네임스페이스라 충돌하지 않는다.
# filer UI (Mac 18888 → 파드 8888), 마스터 UI (9333)
kubectl -n kubeflow port-forward deploy/seaweedfs 18888:8888
kubectl -n kubeflow port-forward deploy/seaweedfs 9333:9333
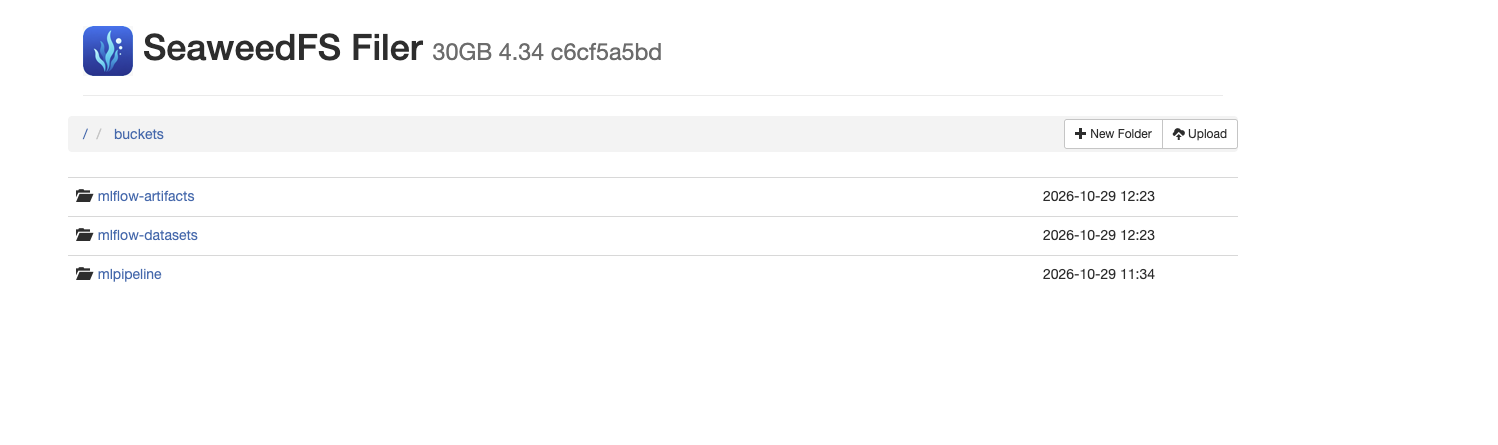
버킷의 용도는 다음과 같이 나눴다. 뒤의 두 개는 4.2절 Feast 실습에서 만든다.
| 버킷 | 쓰는 쪽 | 내용 |
|---|---|---|
mlpipeline |
KFP | 파이프라인 패키지, run의 산출물과 로그 |
mlflow-artifacts |
MLflow 서버 | 실험 아티팩트 루트 s3://mlflow-artifacts/chapter-4 |
mlflow-datasets |
노트북 | 학습·테스트 데이터셋 CSV |
feature-data-sets, feature-registry |
Feast | 피처 parquet 파일과 레지스트리(4.2절) |
Mac 호스트 프로세스: MLflow 서버와 노트북
MLflow 서버의 배치 선택
MLflow 서버를 어디에 두느냐에 따라 노트북과 파드가 닿는 주소가 달라진다. 가시다님은 서버 호스트에서 systemd 사용자 서비스로 0.0.0.0:5000에 띄워 LAN의 Mac에서 접속했다. 김정혁님의 정리는 MLflow를 kind 파드로 올리고 아티팩트까지 PVC에 두는 방식이었다. 나는 Mac 호스트 프로세스로 두고, 메타데이터는 SQLite 파일에, 아티팩트는 SeaweedFS에 저장하도록 했다. MLflow가 backend store와 artifact store를 나누는 구조는 GenAI on K8s 11.3에 정리돼 있다.
이유는 둘이다. 노트북이 같은 Mac에서 돌아 127.0.0.1로 바로 닿고, 아티팩트를 S3에 두면 5장에서 파이프라인 파드가 같은 모델 파일을 클러스터 안에서 읽을 수 있다. 대신 127.0.0.1 바인딩이라 파드가 MLflow API에는 닿지 못한다. 5장 실습은 파드가 모델 레지스트리를 조회해야 하므로 그 전에 바인딩 주소를 다시 정한다.
포트 5050
책과 가시다님은 MLflow 기본 포트 5000을 쓴다. Mac에서는 이 포트를 이미 다른 프로세스가 듣고 있었다.
# 5000 포트를 듣는 프로세스
lsof -nP -iTCP:5000 -sTCP:LISTEN

# 실행 결과 발췌
# COMMAND     USER    NAME
# ControlCe   <user>  TCP *:5000 (LISTEN)
ControlCenter는 macOS의 제어 센터 프로세스이고, 5000을 여는 기능은 AirPlay 수신기다. Apple의 포트 목록은 TCP 5000과 7000을 AirPlay 용도로 적고, Mac 사용 설명서에 따르면 AirPlay 수신기는 macOS 12 이후 지원 기종에서 쓸 수 있으며 시스템 설정의 일반 → AirDrop 및 Handoff(최신 버전에서는 AirDrop 및 연속성)에서 끌 수 있다. 수신 기능을 끄는 대신 MLflow 포트를 5050으로 옮겼다.
start-mlflow.sh 해부
가시다님이 공유한 서버용 기동 스크립트를 Mac에 맞게 세 군데 바꿨다. k3s의 KUBECONFIG 대신 --context kind-ml-study, S3 엔드포인트는 NodePort 30010 대신 port-forward의 9000, 바인딩은 0.0.0.0 대신 127.0.0.1이다.
#!/bin/bash
# scripts/start-mlflow.sh: MLflow 서버(Mac)
# 백엔드는 SQLite, 아티팩트는 s3://mlflow-artifacts/chapter-4 (SeaweedFS)
# 전제: KFP 2.17.3 설치, 버킷 mlflow-artifacts 생성,
#       다른 터미널에서 kubectl -n kubeflow port-forward svc/seaweedfs 9000:9000
# 포트는 5000 대신 5050 (Mac의 5000은 AirPlay 수신기가 사용)
# S3 계정은 kind Secret에서 읽는다 (파일에 값을 쓰지 않는다)
# uv run은 쓰지 않는다: 루트 pyproject.toml 때문에 이 폴더에서도 루트 .venv를 잡는다
set -euo pipefail
cd "$(dirname "$0")/.."
SECRET="kubectl --context kind-ml-study -n kubeflow get secret mlpipeline-minio-artifact"
export AWS_ACCESS_KEY_ID=$($SECRET -o jsonpath='{.data.accesskey}' | base64 -d)
export AWS_SECRET_ACCESS_KEY=$($SECRET -o jsonpath='{.data.secretkey}' | base64 -d)
export MLFLOW_S3_ENDPOINT_URL=http://localhost:9000
mkdir -p mlflow-server
exec .venv/bin/mlflow server --host 127.0.0.1 --port 5050 \
  --backend-store-uri "sqlite:///$PWD/mlflow-server/mlflow.db" \
  --default-artifact-root s3://mlflow-artifacts/chapter-4
--backend-store-uri는 실험·run·지표·모델 레지스트리 메타데이터를 넣는 곳이고, --default-artifact-root는 새 실험에 부여하는 아티팩트 위치다. 서버가 S3에 쓰려면 boto3가 읽는 AWS_ACCESS_KEY_ID·AWS_SECRET_ACCESS_KEY와, MLflow가 S3 엔드포인트를 바꿀 때 쓰는 MLFLOW_S3_ENDPOINT_URL이 필요하다. 각 옵션의 의미는 MLflow Tracking Server 문서에 있다. 마지막 줄이 uv run이 아니라 .venv/bin/mlflow인 이유는 트러블슈팅 사례 3에서 다룬다.
# 터미널 C: 서버 기동 (port-forward가 켜져 있어야 한다)
~/ml-study$ chapters/ch04-feast/scripts/start-mlflow.sh
# ... Uvicorn running on http://127.0.0.1:5050

# 다른 터미널에서 상태와 기본 실험의 아티팩트 위치 확인
~/ml-study$ curl -s localhost:5050/health
OK
~/ml-study$ curl -s -X POST localhost:5050/api/2.0/mlflow/experiments/search \
  -H 'Content-Type: application/json' -d '{"max_results":10}'
# {"experiments":[{"experiment_id":"0","name":"Default","artifact_location":"s3://mlflow-artifacts/chapter-4/0", ...}]}
기본 실험 Default의 아티팩트 위치가 S3 경로로 잡혀 있다. 4.1절에서 노트북이 run을 기록하면 모델 파일이 이 경로 아래에 올라간다.
챕터 가상 환경
실습 저장소는 루트 .venv에 공통 도구(jupyterlab, pandas, scikit-learn, mlflow, torch)를, 챕터마다 별도 .venv에 그 챕터의 의존성을 둔다(3.1편). 4장 저장소의 requirements.txt는 mlflow 3.0.0, feast 0.40.1, xgboost 1.7.6, minio 7.1.16, redis 4.6.0, s3fs, boto3를 고정한다. 책 본문은 mlflow 2.6.0 기준으로 쓰였지만 저장소 코드가 3.0.0으로 올라와 있어 그대로 따랐다.
# 4장 전용 가상 환경 (Python 3.11)과 의존성. sqlalchemy 고정은 사례 2 참고
~/ml-study/chapters/ch04-feast$ uv venv --python 3.11
~/ml-study/chapters/ch04-feast$ uv pip install -r requirements.txt "sqlalchemy>=2.0,<2.1" jupyterlab ipykernel
챕터 폴더에는 pyproject.toml이 없다. 이 상태에서 uv run을 실행하면 uv는 현재 디렉터리와 상위 디렉터리에서 프로젝트를 찾아 저장소 루트의 pyproject.toml을 발견하고, 루트 .venv로 명령을 실행한다(uv 문서의 --no-project 설명이 이 탐색 범위를 적는다). 그래서 챕터 도구는 .venv/bin/<명령>으로 직접 실행한다.
# 챕터 폴더에서 두 방식이 가리키는 가상 환경 비교
~/ml-study/chapters/ch04-feast$ uv run python -c 'import sys, mlflow; print(sys.prefix, mlflow.__version__)'
/Users/<user>/ml-study/.venv 3.17.1
~/ml-study/chapters/ch04-feast$ .venv/bin/python -c 'import sys, mlflow; print(sys.prefix, mlflow.__version__)'
/Users/<user>/ml-study/chapters/ch04-feast/.venv 3.0.0
Jupyter Lab도 같은 이유로 .venv/bin/jupyter lab으로 띄운다. 실행한 디렉터리가 파일 브라우저의 루트가 되므로 챕터 폴더에서 실행하면 4장 파일만 보인다. 커널은 가상 환경 안에서 띄운 “Python 3 (ipykernel)”이 곧 이 .venv다.
노트북 첫 셀에서 어느 가상 환경인지 확인해 두면 뒤의 버전 문제를 줄일 수 있다.
# 노트북 첫 셀: 인터프리터와 핵심 패키지 버전
import sys, mlflow, sklearn
print(sys.prefix, mlflow.__version__, sklearn.__version__)
# /Users/<user>/ml-study/chapters/ch04-feast/.venv 3.0.0 1.9.1
scikit-learn은 requirements.txt에 없어 최신 1.9.1이 들어왔다. 5장에서 파이프라인 컴포넌트 이미지를 만들 때 이 버전과 맞춰야 학습한 모델을 파드에서 읽을 수 있다.
kfp SDK와 CLI
파이프라인을 컴파일하고 제출하는 kfp SDK는 백엔드와 같은 2.17.3을 루트 .venv에 설치했다. Feast CLI는 챕터 .venv의 feast를 쓴다.
실습 중에는 터미널 세 개를 켜 둔다. SeaweedFS port-forward, start-mlflow.sh, Jupyter Lab이다. 셋 다 127.0.0.1에만 열리므로 LAN에 노출되지 않고, 가시다님 환경의 SSH 터널이나 비밀번호 설정은 필요 없다.
검증: 파이프라인 한 번 실행과 저장소 확인
설치가 끝났는지는 파이프라인이 끝까지 돌아야 안다. 컴포넌트 두 개가 덧셈을 이어 하는 최소 파이프라인을 만들었다.
# kubeflow/pipeline_example.py: add 컴포넌트 두 개를 잇는 파이프라인
from kfp import dsl, compiler


@dsl.component(base_image="python:3.11-slim")  # 컴포넌트가 실행될 컨테이너 이미지
def add(a: float, b: float) -> float:
    print(f"{a} + {b} = {a + b}")
    return a + b


@dsl.pipeline(name="example")
def pipeline(x: float = 1.0, y: float = 2.0):
    first = add(a=x, b=y)          # 1단계
    add(a=first.output, b=10.0)    # 2단계: 1단계 출력을 입력으로

# IR YAML로 컴파일
compiler.Compiler().compile(pipeline, "kubeflow/pipeline_example.yaml")
컴파일한 YAML을 kfp 클라이언트로 제출하고 끝날 때까지 기다렸다. UI의 Upload pipeline으로 같은 YAML을 올려 실행해도 결과는 같다.
# 컴파일 후 제출. 호스트는 socat 프록시 주소
~/ml-study/chapters/ch04-feast$ ../../.venv/bin/python kubeflow/pipeline_example.py
~/ml-study/chapters/ch04-feast$ ../../.venv/bin/python - <<'EOF'
import kfp
client = kfp.Client(host="http://localhost:30008")
run = client.create_run_from_pipeline_package(
    "kubeflow/pipeline_example.yaml", arguments={"x": 2, "y": 5}
)
print("state:", client.wait_for_run_completion(run.run_id, timeout=600).state)
EOF
Experiment details: http://localhost:30008/#/experiments/details/254e5fb3-...
Run details: http://localhost:30008/#/runs/details/01c74fc6-...
state: SUCCEEDED
run 하나가 Argo Workflow 하나가 되고, 컴포넌트마다 driver 파드와 실제 실행 파드가 생긴다. KFP v2는 컴포넌트 실행 전에 kfp-driver 이미지로 입력을 해석하고(driver), 그다음 사용자 이미지(python:3.11-slim)에 kfp-launcher를 주입해 실행한다(container-impl). 파이프라인 전체를 위한 dag-driver도 하나 돈다.
# Workflow와 파드
kubectl -n kubeflow get workflows
# NAME            STATUS      AGE
# example-97pbc   Succeeded   55s

kubectl -n kubeflow get pods -l workflows.argoproj.io/workflow=example-97pbc \
  -o custom-columns='NAME:.metadata.name,STATUS:.status.phase,IMAGES:.spec.containers[*].image'
# NAME                                               STATUS      IMAGES
# example-97pbc-system-dag-driver-2763678176         Succeeded   quay.io/argoproj/argoexec:v4.0.6,ghcr.io/kubeflow/kfp-driver:2.17.3
# example-97pbc-system-container-driver-343167502    Succeeded   quay.io/argoproj/argoexec:v4.0.6,ghcr.io/kubeflow/kfp-driver:2.17.3
# example-97pbc-system-container-impl-3831738003     Succeeded   quay.io/argoproj/argoexec:v4.0.6,python:3.11-slim
# example-97pbc-system-container-driver-1022491993   Succeeded   quay.io/argoproj/argoexec:v4.0.6,ghcr.io/kubeflow/kfp-driver:2.17.3
# example-97pbc-system-container-impl-3178399942     Succeeded   quay.io/argoproj/argoexec:v4.0.6,python:3.11-slim

# 실행 파드의 출력
kubectl -n kubeflow logs example-97pbc-system-container-impl-3831738003 -c main | grep ' = '
# 2 + 5 = 7
kubectl -n kubeflow logs example-97pbc-system-container-impl-3178399942 -c main | grep ' = '
# 7 + 10 = 17
같은 인자로 두 번 제출했을 때는 두 번째 run에 실행 파드가 생기지 않았다. Workflow의 노드 상태에 executor Skipped만 남고 driver 파드 세 개만 돌았는데, cache-server가 같은 컴포넌트와 같은 입력의 이전 결과를 재사용했기 때문이다. 실행 캐시는 KFP의 기본 동작이고, 결과를 다시 계산하게 하려면 입력을 바꾸거나 캐시를 끈다. 위 출력은 인자를 바꿔 제출한 run이다.
Workflow에는 산출물을 어디에 쓸지가 들어 있다. 2단계 설치 매니페스트의 ConfigMap이 정한 값이다. Argo Workflow의 아티팩트 저장소를 객체 저장소로 직접 설정해 본 기록은 Argo Workflow Artifact 글에 있다.
# kubectl -n kubeflow get wf example-97pbc -o yaml 발췌
artifactRepositoryRef:
  artifactRepository:
    archiveLogs: true
    s3:
      endpoint: seaweedfs.kubeflow.svc:9000   # Service의 http-s3-compat 포트
      bucket: mlpipeline
      insecure: true
      keyFormat: private-artifacts/{{workflow.namespace}}/{{workflow.name}}/{{workflow.creationTimestamp.Y}}/{{workflow.creationTimestamp.m}}/{{workflow.creationTimestamp.d}}/{{pod.name}}
      accessKeySecret: { name: mlpipeline-minio-artifact, key: accesskey }
      secretKeySecret: { name: mlpipeline-minio-artifact, key: secretkey }
버킷을 다시 보면 run마다 파드 이름으로 폴더가 생기고 크기가 늘어 있다.
# run 세 번 뒤의 버킷 (설치 직후 16,616B)
echo "s3.bucket.list" | kubectl -n kubeflow exec -i deploy/seaweedfs -- /usr/bin/weed shell | grep mlpipeline
#   mlpipeline    size:33216      chunk:20
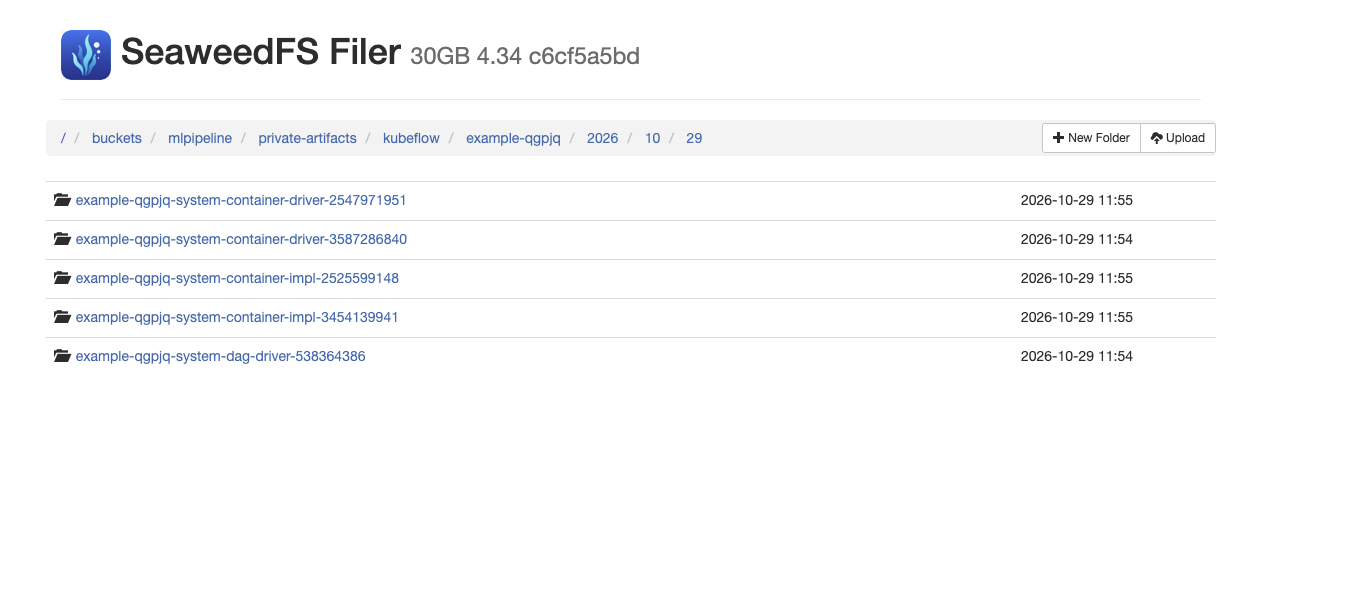
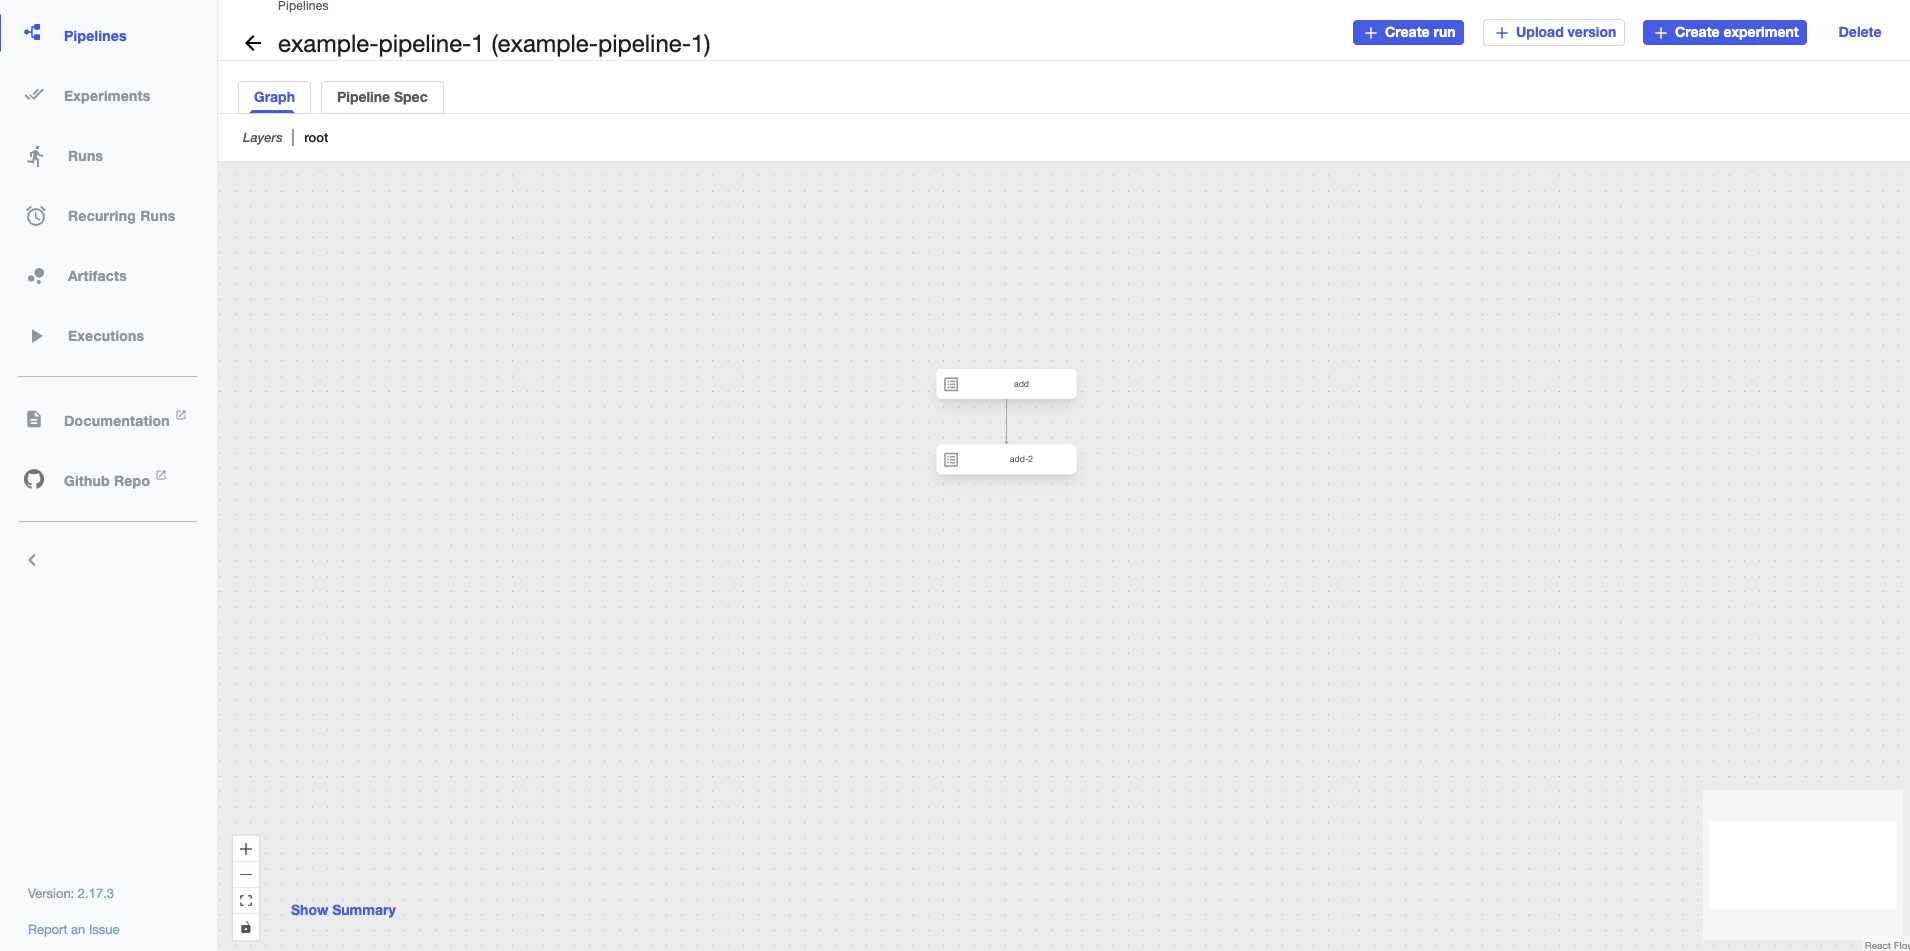
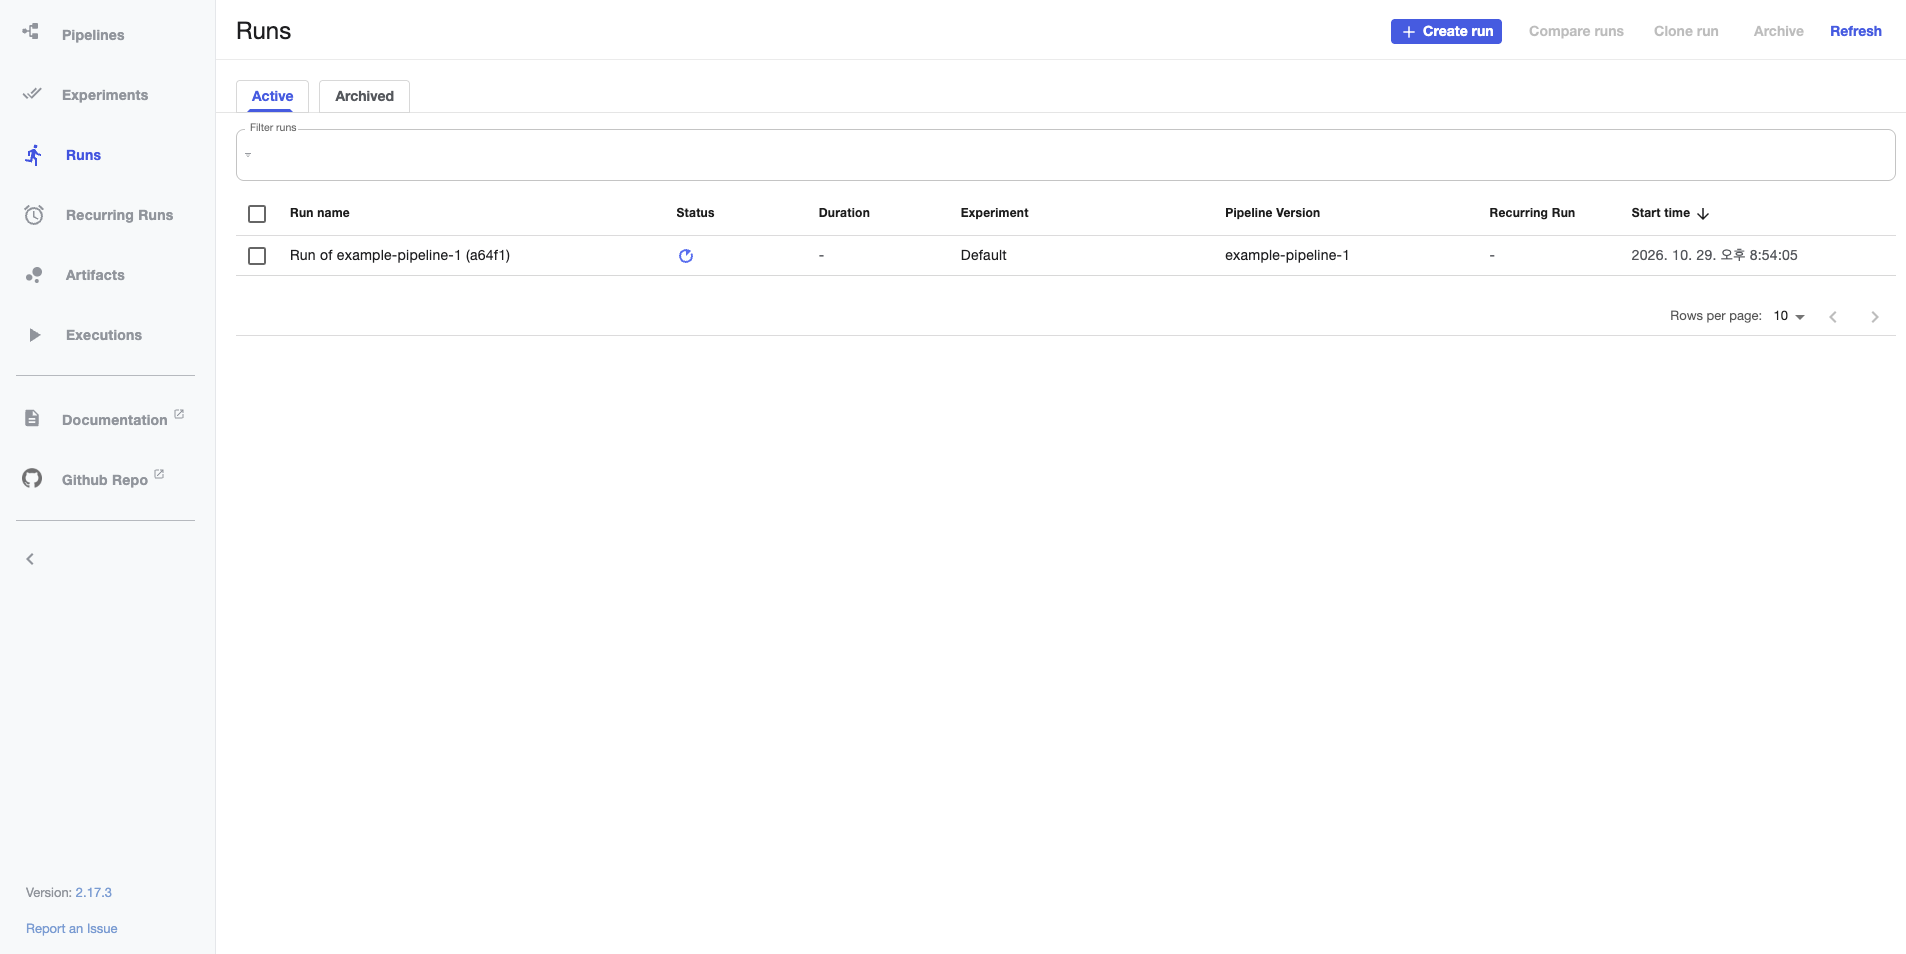
MLflow 쪽은 /health와 기본 실험의 아티팩트 위치까지 확인했고, run 기록은 4.1절 노트북에서 한다.
트러블슈팅
사례 1: metadata-writer 파드가 뜨지 않음
증상: ImagePullBackOff
2단계 매니페스트를 적용한 뒤 다른 파드는 모두 Running이 됐는데 metadata-writer만 이미지를 받지 못했다.
# 파드 상태
kubectl -n kubeflow get pods | grep metadata-writer
# metadata-writer-6f6d56d68f-pfsgt   0/1   ImagePullBackOff   0   36m

# 파드 이벤트의 실패 메시지
# Failed to pull image "ghcr.io/kubeflow/kfp-metadata-writer:2.17.3":
#   no match for platform in manifest: not found
증거: manifest list에 arm64 항목 없음
docker manifest inspect 결과 이 이미지의 manifest list에는 linux/amd64 항목과 빌드 증명만 있었다. 같은 버전의 다른 KFP 이미지(api-server, frontend, persistence-agent, driver, launcher 등)에는 linux/arm64 항목이 있었다. KFP의 arm64 지원 이슈도 kfp-metadata-writer를 amd64 전용으로 표시한다.
원인: 노드 아키텍처와 맞는 항목을 고르지 못함
arm64 노드의 containerd는 manifest list에서 linux/arm64 항목을 찾는다. 없으면 받을 이미지를 정하지 못하고 no match for platform으로 실패한다. 단일 매니페스트인 ML Metadata 이미지가 같은 노드에서 떴던 것과 대비된다. 그 이미지는 고를 목록이 없어 amd64 그대로 내려받았고 Rosetta로 실행됐다.
해결: amd64 digest로 고정
태그 대신 amd64 항목의 digest를 직접 지정하면 런타임은 플랫폼 선택 없이 그 이미지를 받는다. 실행은 ML Metadata 이미지와 같이 Rosetta가 맡는다.
# Deployment의 이미지를 amd64 digest로 교체하고 롤아웃 완료 대기
kubectl -n kubeflow set image deploy/metadata-writer \
  main=ghcr.io/kubeflow/kfp-metadata-writer@sha256:c96037c8d2ec4d3b66e1329a0d0b55504a9a74a549c1eaf3a29be7f9e7c322cb
kubectl -n kubeflow rollout status deploy/metadata-writer
# deployment "metadata-writer" successfully rolled out

# ReplicaSet 이력: 태그판은 0개로 줄고 digest판이 1개
kubectl -n kubeflow get rs -l app=metadata-writer \
  -o custom-columns='NAME:.metadata.name,IMAGE:.spec.template.spec.containers[0].image,REPLICAS:.spec.replicas'
# metadata-writer-6f6d56d68f   ghcr.io/kubeflow/kfp-metadata-writer:2.17.3            0
# metadata-writer-bb8f799f7    ghcr.io/kubeflow/kfp-metadata-writer@sha256:c96037c8…   1
이 변경은 클러스터 안의 Deployment에만 있다. 2단계 매니페스트를 다시 적용하면 이미지가 태그로 되돌아가므로, 재적용할 일이 있으면 이 명령도 다시 실행해야 한다.
사례 2: mlflow server가 ImportError로 종료
증상: 서버 시작 직후 종료
챕터 .venv에 requirements.txt만 설치하고 mlflow server를 띄우면 시작 단계에서 ImportError가 났다.
ImportError: cannot import name 'FallbackAsyncAdaptedQueuePool' from 'sqlalchemy.pool'
증거: SQLAlchemy 2.1
가상 환경에 들어온 SQLAlchemy가 2.1.6이었다. requirements.txt는 mlflow 3.0.0을 고정하지만 SQLAlchemy 버전은 고정하지 않고, mlflow 자체의 의존성 범위는 sqlalchemy<3,>=1.4.0이라 최신 2.1 계열이 설치된다.
원인: SQLAlchemy 2.1에서 제거된 심볼
mlflow 3.0.0의 mlflow/store/db/utils.py는 sqlalchemy.pool에서 FallbackAsyncAdaptedQueuePool을 무조건 import한다. SQLAlchemy 2.1은 greenlet을 선택 의존성으로 바꾸면서 이 공개 클래스를 제거했다. mlflow는 PR #20203에서 import를 try/except로 감쌌고 수정은 3.9.0(2026-01-29)부터 들어갔다. SQLAlchemy 2.1.0 정식판은 2026-09-24에 나왔으므로, 그 뒤에 mlflow 3.0.0을 새로 설치하면 이 조합이 된다.
해결: SQLAlchemy 2.0 계열로 고정
책 코드가 고정한 mlflow 3.0.0을 유지하려고 SQLAlchemy를 2.0 계열로 내렸다. mlflow를 3.9.0 이상으로 올리는 방법도 있지만 책 코드의 버전을 바꾸게 된다.
~/ml-study/chapters/ch04-feast$ uv pip install "sqlalchemy>=2.0,<2.1"
# sqlalchemy 2.0.55
~/ml-study/chapters/ch04-feast$ curl -s localhost:5050/health
OK
사례 3: MLflow UI에 3.17.1이 표시됨
증상: 설치한 버전과 다른 서버
처음 작성한 start-mlflow.sh는 마지막 줄이 exec uv run mlflow server …였다. 서버는 떴지만 UI 왼쪽 위에 3.17.1이 표시됐다. 챕터 .venv에 설치한 mlflow는 3.0.0이다.
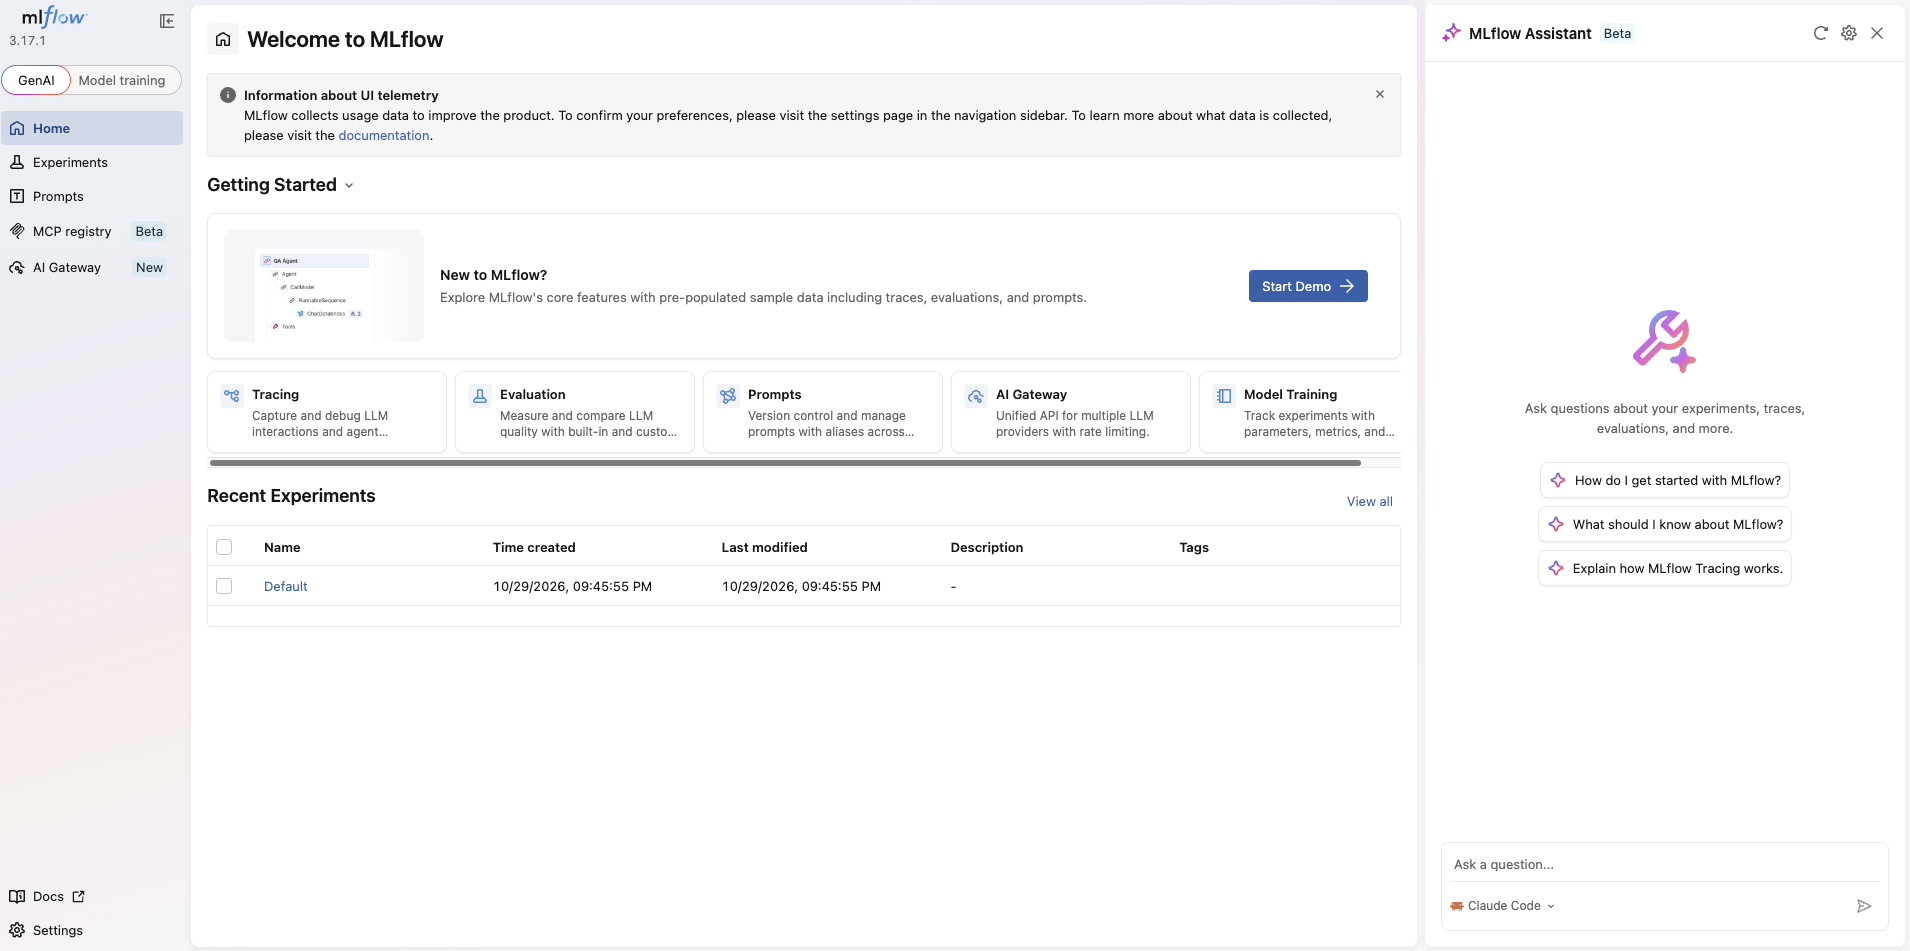
증거: 루트 가상 환경의 mlflow
챕터 폴더에서 uv run python -c 'import sys; print(sys.prefix)'를 실행하면 저장소 루트의 .venv가 나오고, 그 환경의 mlflow가 3.17.1이다. 루트 pyproject.toml의 공통 의존성에 버전 고정 없는 mlflow가 들어 있어 최신판이 설치돼 있었다.
원인: uv의 프로젝트 탐색
uv run은 현재 디렉터리에서 상위로 올라가며 pyproject.toml을 찾고, 찾은 프로젝트의 .venv를 쓴다. 챕터 폴더에는 pyproject.toml이 없으므로 루트 프로젝트가 잡힌다. uv 문서는 --no-project를 “현재 디렉터리와 상위 디렉터리에서 프로젝트를 찾지 않는” 옵션으로, --project를 “주어진 디렉터리에서 프로젝트를 찾는” 옵션으로 설명한다.
해결: 가상 환경의 실행 파일을 직접 호출
스크립트의 마지막 줄을 exec .venv/bin/mlflow server …로 바꾸고, Jupyter와 스크립트 실행도 .venv/bin/ 아래 실행 파일을 쓰도록 통일했다. 다시 띄운 서버의 버전은 3.0.0이다.
~/ml-study/chapters/ch04-feast$ .venv/bin/mlflow --version
mlflow, version 3.0.0
재발 방지
- 새 컴포넌트를 올리기 전에
docker manifest inspect <이미지>로 arm64 항목이 있는지 본다. 없으면 digest 고정과 Rosetta 실행을 처음부터 계획에 넣는다 - 포트를 정하기 전에
lsof -nP -iTCP:<포트> -sTCP:LISTEN으로 점유 프로세스를 확인한다 - 챕터 폴더의 명령은
.venv/bin/<명령>으로 실행하고, 노트북 첫 셀에서sys.prefix와 패키지 버전을 찍는다 - 스크립트에 넣을 자격 증명은 Secret에서 읽고 파일에 값을 쓰지 않는다
정리
이 환경은 4장의 실험 추적과 피처 저장소, 5장의 파이프라인이 공유하는 저장소와 실행 기반이다. 세 도구가 같은 S3 호환 저장소를 버킷으로 나눠 쓰고, Mac의 노트북 프로세스와 클러스터 안 파드가 같은 데이터에 닿아야 한다. 그래서 어디서 무엇이 실행되고 어떤 주소로 닿는지를 먼저 그렸다.
Mac에서 실습 조건을 바꾼 것은 세 가지였다. 노드 포트는 클러스터 생성 때 정해지므로 뒤늦게 필요한 포트는 중계 컨테이너나 port-forward로 연다. arm64 이미지가 없는 컴포넌트는 digest 고정과 Rosetta로 띄운다. 호스트의 기본 포트는 다른 프로세스가 쓰고 있을 수 있다. 여기에 저장소 자체의 함정으로 도구 버전과 가상 환경 선택이 더해졌다.
남은 작업은 Feast 온라인 스토어인 Redis와 피처 버킷 두 개(4.2절), 그리고 파드가 MLflow에 닿도록 바인딩 주소를 다시 정하는 일(5장)이다.
참고 링크
- Machine Learning Platform Engineering — Manning
- 머신러닝 플랫폼 엔지니어링 — 책만
- 책 4장 코드: https://github.com/practical-mlops/chapter-4
- Kubeflow Pipelines 설치 문서
- Kubeflow Pipelines 로컬 배포 문서(레거시 V1)
- KFP 2.17.3 매니페스트 env/platform-agnostic
- KFP 2.15.0 릴리스 노트
- KFP linux/arm64 지원 umbrella 이슈
- SeaweedFS Amazon S3 API
- kind 설정: Extra Port Mappings
- Docker Desktop 설정
- MLflow Tracking Server
- mlflow PR #20203: Fix for SQLAlchemy 2.1
- uv CLI reference: uv run
- Apple: TCP and UDP ports used by Apple software products
댓글남기기