[Evidently] 머신러닝 플랫폼 엔지니어링: Evidently와 Kubeflow Notebooks - 6.2.1. 드리프트 판정과 윈도 크기
시리즈 · 머신러닝 플랫폼 엔지니어링: Evidently와 Kubeflow Notebooks (1 / 2)·다음 편 →
서종호(가시다)님의 Machine Learning Platform Engineering Study 3주차 학습 내용을 기반으로 합니다.
TL;DR
- 3주차 실습은 학습 데이터에 있는 사용자로 요청을 보내므로 분포가 같아야 한다. 그런데 최근 요청 100건의 드리프트 컬럼 비율이 0.5로 나왔다. 세 컬럼이 일치하는 100행을 Evidently 버전 0.5.0에 넣어 같은 값을 얻었다
- 기준 데이터가 1000행을 넘으면 범주형 컬럼은 Jensen-Shannon 거리가 0.1 이상일 때 드리프트로 판정한다. 이 기준은 윈도(최근 요청 묶음) 크기와 무관하게 고정이다
- 같은 분포에서 뽑아도 표본 오차만큼 거리가 나온다. 크기는 약 $\sqrt{(k-1)/(8n)}$이다. 범주 16개에 윈도 100이면 0.137이라 기준을 넘는다
- 같은 데이터의 윈도를 5000번 판정하니 데이터셋 드리프트 판정 비율이 윈도 50에서 98%, 100에서 57%, 200에서 1%였다. 책의 0.875는 윈도 50의 위쪽 값이다
- 이 관계로 윈도 크기를 정할 수 있다. 범주 16개 컬럼의 오경보(분포가 같은데 드리프트로 나온 판정)를 5%로 두려면 식으로 312행, 측정으로 350행이었다
- 판정 방법을 바꾸려고 기준 데이터를 줄일 필요는 없다. 전체를 쓴 채
stattest="chisquare"를 주면 데이터셋 오경보는 1% 아래였다. 1000행으로 줄이면 기준 데이터의 표본 오차가 판정에 들어가 윈도가 커질수록 늘었다 - 표본이 아주 크면 chi-square는 대응할 필요가 없는 작은 변화까지 유의하다고 판정한다
들어가며
분포가 같은 데이터를 넣었는데 드리프트로 나오면 무엇이 잘못된 걸까. 3주차에 읽은 책 머신러닝 플랫폼 엔지니어링 6장의 실습에서 이 일이 일어난다. 데이터 드리프트(data drift)는 모델 입력의 분포가 학습 때와 달라지는 현상이다. 모델 성능이 떨어지기 전에 점검이나 재학습으로 잇기 위해 드리프트를 감시한다. 2주차 글에서 학습 트리거 구간을 이야기하며 드리프트 신호는 뒤의 모니터링 장에 미뤄 두었다. 모니터링 장은 책 6장이고 드리프트는 그중 6.2절에서 다룬다.
실습은 소득 분류기를 BentoML로 배포한다. 서비스는 최근 요청 N건을 윈도(window)에 모아 학습 데이터와 비교한다. 요청 하나가 표의 한 행이므로 윈도 크기 50은 50행이다. 요청에는 학습 데이터에 있는 사용자의 ID만 실린다. 서비스가 피처 저장소에서 그 사용자의 값을 읽어 윈도에 넣는다. 학습 데이터에서 온 값이니 분포가 같아 드리프트가 없어야 한다.
그런데 책은 윈도 크기가 50일 때의 대시보드(그림 6.21)에서 드리프트 컬럼 비율이 0.875에 가깝다고 적는다. 범주형 컬럼 8개 중 드리프트로 판정된 컬럼의 비율이다. 0.875면 8개 중 7개다. 책은 이 수치가 다소 이상하다며 윈도 크기 때문일 수 있으니 임곗값을 재검토하고 더 큰 윈도를 시도해 보라고 권한다. 스터디 노트에 실린 대시보드 캡처는 윈도 100에서 0.5였다. 노트는 표본이 작으면 거리 기반 판정의 값이 크게 나오기 쉽다고 설명한다.
그 값이 얼마나 크게 나오는지 궁금했다. 왜 8개 중 4개, 7개가 기준을 넘었을까. 윈도를 얼마나 키워야 같은 분포에서 드리프트 판정이 나오지 않을까. 이 글은 답을 식과 측정으로 찾는다.
이 시리즈는 3주차 범위의 Evidently와 Kubeflow Notebooks를 다룬다. 번호는 책의 장과 절을 따르고 세 번째 자리는 글의 순서다. 이번 주 실습 전체는 서빙과 저장소까지 갖춘 쿠버네티스 구성이라 시간 안에 돌리지 못했다. 드리프트 판정은 Evidently 라이브러리 안에서 끝나므로 Python 가상환경에서 돌렸다. 실험 코드 작성과 실행에는 AI의 도움을 받았다. 코드와 데이터, 실행 출력은 실험 폴더에 두었다.
Evidently의 드리프트 판정
Evidently는 기준이 되는 reference 데이터와 새로 들어온 current 데이터를 비교한다. 실습에서는 학습 데이터가 reference이고 윈도가 current다. 판정은 두 단계로 이뤄지고 기준도 둘이다. 컬럼마다 드리프트를 판정한 뒤 드리프트 컬럼 비율이 0.5 이상이면 데이터셋 드리프트로 본다.
flowchart TB
  %% 컬럼마다 판정한 뒤 드리프트 컬럼 비율로 데이터셋을 판정한다
  R[reference] --> C[컬럼별 판정]
  W[current 윈도] --> C
  C --> S[드리프트 컬럼 비율]
  S --> D{0.5 이상인가}
  D -->|예| T[데이터셋 드리프트]
  D -->|아니오| F[드리프트 아님]
컬럼 8개 중 4개면 비율이 0.5이고 이 경우도 드리프트다(소스).
컬럼별 판정 방법은 reference의 행 수와 컬럼 타입으로 정해진다. 책이 쓰는 버전 0.5.0의 기본 규칙은 다음과 같다. 2026년 11월의 Evidently 문서에 적힌 규칙도 같다. 이 글에서 쓰는 칸은 범주형 두 칸이고 나머지는 전체 규칙을 보이려고 적었다.
| reference 행 수 | 범주형 | 수치형 |
|---|---|---|
| 1000 이하 | chi-square, 값이 2개면 Z 검정 | KS 검정, 값이 5개 이하면 chi-square나 Z 검정 |
| 1000 초과 | Jensen-Shannon 거리 | Wasserstein 거리, 값이 5개 이하면 Jensen-Shannon 거리 |
표의 방법은 거리와 가설 검정 두 종류다. 거리(distance)는 두 분포가 얼마나 다른지를 값으로 내고 고정 기준과 비교한다. 표본 크기는 판정에 들어가지 않는다. 가설 검정(hypothesis test)은 같은 분포라고 했을 때 이만한 차이가 우연히 나올 확률(p값)을 낸다. p값이 유의수준 0.05보다 작으면 드리프트로 본다. 표본 크기가 계산에 들어가고 값이 작을수록 드리프트다. 같은 분포에서도 약 5%는 드리프트로 나오는 것이 정상이다.
선택 함수에서 범주형 부분만 추리면 조건문에 reference_data의 크기만 있다. 학습 데이터 3만 행을 reference로 두면 윈도가 50이든 5000이든 같은 방법을 쓴다.
# evidently/calculations/stattests/registry.py (v0.5.0, 발췌)
elif reference_data.shape[0] <= 1000:
    ...
    elif feature_type == ColumnType.Categorical:
        return stattests.chi_stat_test if n_values > 2 else stattests.z_stat_test
elif reference_data.shape[0] > 1000:
    ...
    elif feature_type == ColumnType.Categorical:
        return stattests.jensenshannon_stat_test
범주형 컬럼의 Jensen-Shannon 거리는 reference와 current의 범주별 비율을 비교한다. 0이면 비율이 같다. 겹치는 범주가 없으면 최댓값 $\sqrt{\ln 2} \approx 0.833$이다. 판정은 이 거리를 기본 임곗값 0.1과 비교한다. 범주 2개로 보면 50:50과 64:36의 거리가 0.100이다.
# evidently/calculations/stattests/jensenshannon.py (v0.5.0, 발췌)
jensenshannon_value = distance.jensenshannon(reference_percents, current_percents, base)
return jensenshannon_value, jensenshannon_value >= threshold
참고: 책은 그림 6.16의 보고서를 바서슈타인(Wasserstein) 거리로 설명한다. 수치형 컬럼의 기본 방법이고 기본 임곗값은 역시 0.1이다. 이 글은 범주형 8개 컬럼만 비교한다.
실습 재현
책 저장소의 mock 요청 CSV는 100행이고 사용자 ID와 Workclass, Education, Occupation 세 컬럼이 있다. 소득 분류기의 학습 데이터는 UCI Adult다. 이 세 컬럼을 대조하니 결측 행을 뺀 Adult의 앞 100행과 100행 모두 일치했다. 나머지 다섯 컬럼은 서비스가 피처 저장소에서 읽으므로 대조하지 못했다. 이 100행을 current로 두고 결측 제외 전체 30,162행을 reference로 두었다.
clean = df[~df.isin([" ?"]).any(axis=1)].reset_index(drop=True)  # Adult의 결측 표기는 " ?"다
ref = clean[cats]  # 범주형 8개 컬럼, 30,162행
report = Report(metrics=[DatasetDriftMetric()] + [ColumnDriftMetric(column_name=c) for c in cats])
report.run(reference_data=ref, current_data=ref.head(100))
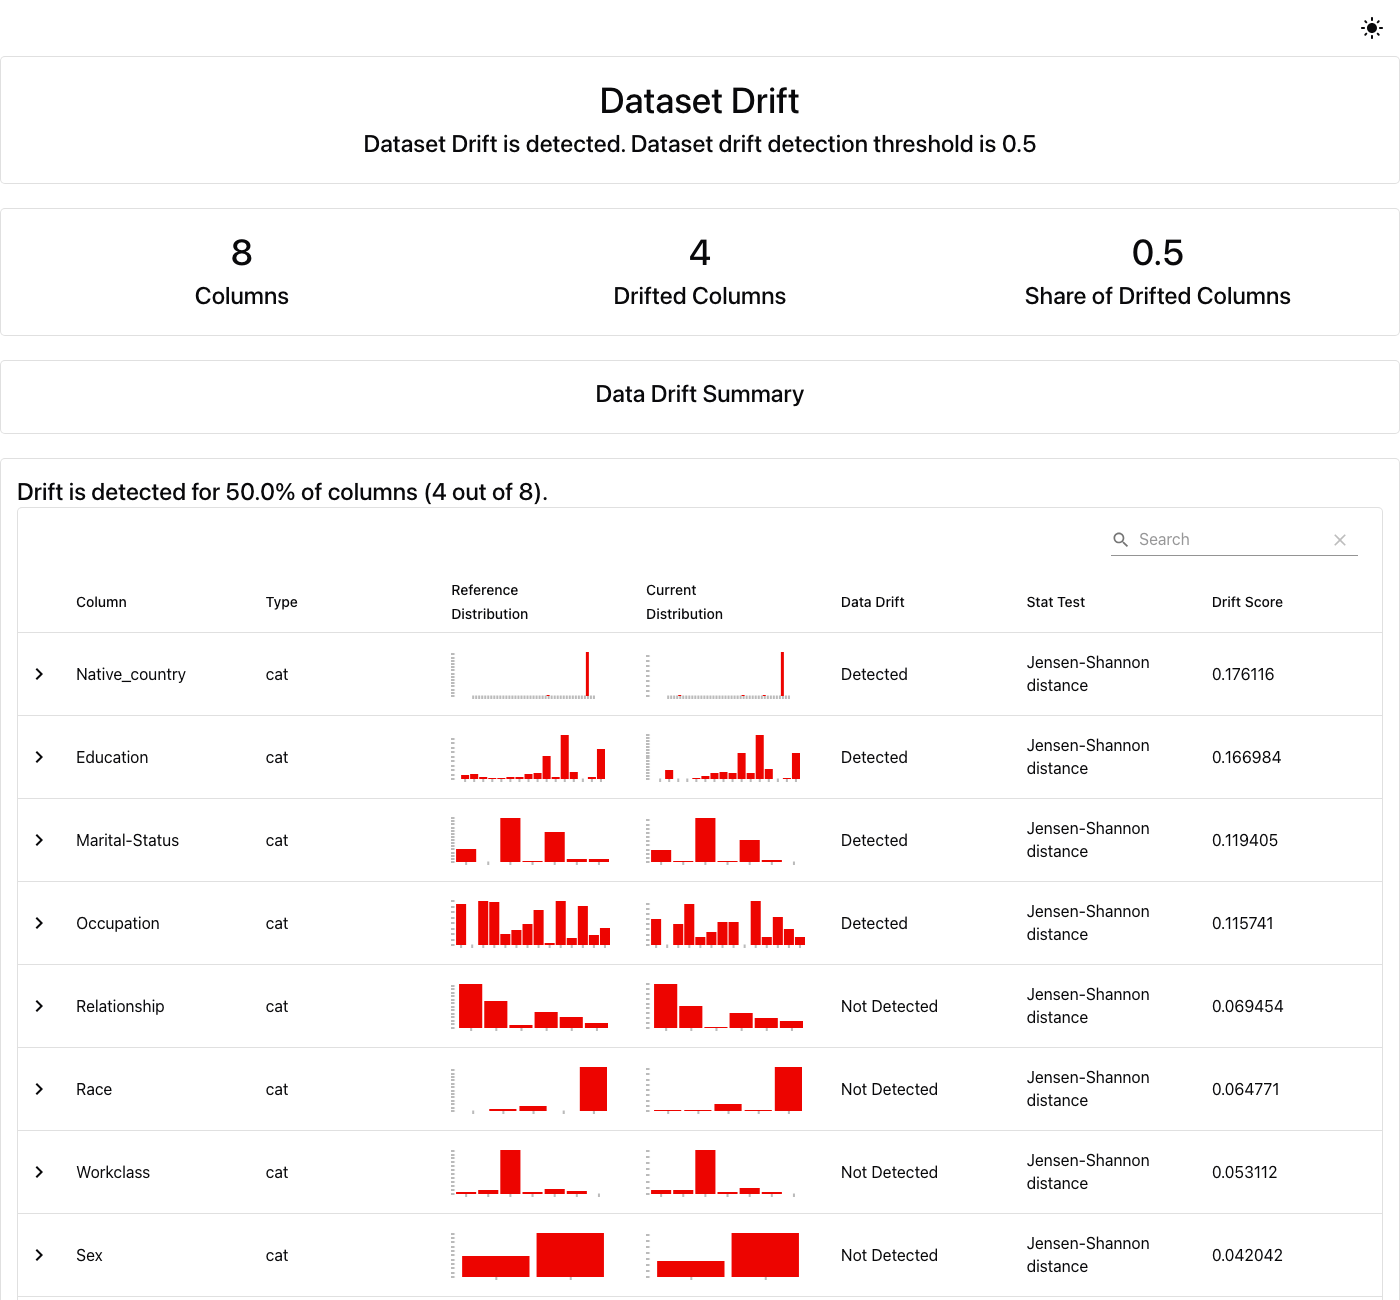
전체 코드는 exact_window2.py에 있다. 결과는 스터디 캡처와 같은 0.5다.
mock vs no-missing head, identical rows: 100 of 100
ref=no-missing all, window=mock's 100 rows: share 0.5 dataset_drift True
  Education        Jensen-Shannon distance score=0.1670 drifted=True
  Marital-Status   Jensen-Shannon distance score=0.1194 drifted=True
  Native_country   Jensen-Shannon distance score=0.1761 drifted=True
  Occupation       Jensen-Shannon distance score=0.1157 drifted=True
  Race             Jensen-Shannon distance score=0.0648 drifted=False
  Relationship     Jensen-Shannon distance score=0.0695 drifted=False
  Sex              Jensen-Shannon distance score=0.0420 drifted=False
  Workclass        Jensen-Shannon distance score=0.0531 drifted=False
window 50 sliding over those rows: [0.875, 0.75, 0.75, 0.75, 0.625, 0.75]
마지막 줄은 윈도를 50으로 줄여 10행씩 밀어 본 결과다. 앞 50행의 값이 책과 같은 0.875다. 값이 같다고 설정이 같다고 말할 수는 없다. 스터디의 실제 reference는 보지 못했다. 뒤에서 보듯 0.5는 무작위 윈도의 약 35%에서 나오는 값이다. 책 그림에는 1.0도 보이는데 이 100행에서는 나오지 않았다.
Evidently는 판정을 HTML 보고서로도 내보낸다. 이 윈도의 보고서를 열면 컬럼별 분포와 판정을 볼 수 있다.
원인: 표본 오차가 남긴 거리
분포 변화가 없는데 드리프트로 나온 판정을 이 글에서 오경보(false alarm)라고 부른다. 같은 분포에서 뽑아도 표본의 비율은 전체 비율과 조금씩 다르다. 오차는 양쪽으로 나지만 거리는 0 아래로 내려가지 않으므로 그대로 양수 값으로 남는다. 윈도가 작을수록 오차가 크니 거리도 크다.
크기는 식으로 잡을 수 있다. reference가 윈도보다 훨씬 크면 reference의 비율을 참값으로 볼 수 있다. reference의 범주 비율을 $p_i$, 윈도의 비율을 $q_i$, 범주 수를 $k$, 윈도 크기를 $n$이라 하자. Jensen-Shannon 거리 $d$는 Jensen-Shannon 발산의 제곱근이다. 차이가 작을 때 자연로그 기준 발산은 다음과 같이 근사된다(유도는 테일러 전개이고 여기서는 생략한다).
합에 $n$을 곱한 값은 chi-square 적합도 통계량이다. 이 통계량은 같은 분포에서 자유도 $k-1$인 chi-square 분포를 따른다. 평균이 $k-1$이므로 거리의 크기는 다음과 같다. 평균 제곱의 제곱근이라 실제 평균보다 조금 크다.
판정 확률도 같은 식에서 나온다. 거리가 0.1 이상이라는 말은 통계량이 $8n(0.1)^2$ 이상이라는 말이다.
아래 표에 이 식을 Adult의 컬럼에 대입한 값과 측정을 나란히 놓았다. 범주가 적은 순으로 정렬했다. 측정은 컬럼의 실제 분포에서 표본을 4000번 뽑아 잰 컬럼 판정 비율이다. 범주 수는 adult.data 원본 기준이다.
| 컬럼 | 범주 수 | 윈도 50 측정 | 식 | 윈도 100 측정 | 식 | 윈도 200 측정 | 식 |
|---|---|---|---|---|---|---|---|
| Sex | 2 | 5% | 5% | 1% | 0% | 0% | 0% |
| Race | 5 | 48% | 41% | 13% | 9% | 1% | 0% |
| Relationship | 6 | 61% | 55% | 20% | 16% | 1% | 1% |
| Marital-Status | 7 | 70% | 68% | 24% | 24% | 2% | 1% |
| Workclass | 9 | 77% | 86% | 32% | 43% | 3% | 4% |
| Occupation | 15 | 100% | 100% | 89% | 89% | 32% | 31% |
| Education | 16 | 100% | 100% | 97% | 92% | 50% | 38% |
| Native_country | 42 | 100% | 100% | 100% | 100% | 100% | 100% |
식은 범주 비율이 한쪽으로 크게 쏠린 컬럼에서 어긋난다. 42개 범주 중 39개가 1% 미만인 Native_country는 평균 거리가 윈도 50에서 식 0.320, 측정 0.201이다. 드문 범주가 윈도에 나타나면 제곱 항이 근사보다 크게 부풀기 때문이다. 정확히 재려면 범주별 비율을 넣어야 하고 드문 범주가 적으면 $k$로 어림할 수 있다.
이 표로 0.5와 0.875를 설명할 수 있다. 윈도 100에서 범주가 많은 세 컬럼은 거의 늘 기준을 넘는다. 나머지 컬럼은 1~32% 확률로 넘는다. 셋에 하나가 더해지면 8개 중 4개, 0.5다. 이번 윈도에서는 Marital-Status가 더해졌다. 윈도 50에서는 Sex를 뺀 일곱 컬럼이 48~100% 확률로 넘는다. 일곱이 모두 넘으면 0.875다.
두 값은 드문 값이 아니다. 결측 제외 reference로 무작위 윈도를 5000번 뽑으면 윈도 100의 비율 중 0.5가 35%이고 윈도 50의 비율 중 0.875가 16%다. 윈도 50의 평균은 0.69다. 0.875는 분포의 위쪽 값이다.
윈도 크기별로 데이터셋 판정도 세어 보았다. reference는 adult.data 32,561행이다. 같은 데이터에서 윈도를 크기별로 5000번 뽑았다. 마지막 열은 윈도 5000개 중 드리프트 컬럼 비율이 0.5 이상인 윈도의 비율이다. 표의 값은 Evidently와 같은 식을 직접 계산한 것이고 80번 대조해 차이가 없었다(결과).
| 윈도 크기 | 드리프트 컬럼 비율 평균 | 5~95% 범위 | 데이터셋 드리프트 판정 비율 |
|---|---|---|---|
| 50 | 0.703 | 0.5~0.875 | 98.4% |
| 100 | 0.468 | 0.25~0.625 | 56.8% |
| 200 | 0.234 | 0.125~0.375 | 1.3% |
| 500 | 0.099 | 0~0.125 | 0% |
| 1000 이상 | 0 | 0 | 0% |
윈도 200이면 데이터셋 판정은 거의 사라지지만 컬럼 판정은 남는다. 윈도 500의 평균 0.099는 Native_country 한 컬럼이 윈도의 79%에서 넘은 값이다(0.79÷8).
윈도 크기를 정할 때
허용할 오경보 비율 $\alpha$를 정하면 앞의 식에서 윈도 크기가 나온다. $\chi^2_{k-1,\,1-\alpha}$는 자유도 $k-1$인 chi-square 분포의 상위 $\alpha$ 지점이다. $t$는 거리 임곗값이다.
아래 표는 $\alpha = 5\%$, $t = 0.1$인 경우다. 측정은 컬럼 판정 비율이 5% 이하가 되는 가장 작은 윈도이고 윈도를 10~25행 간격으로 올리며 찾았다.
| 컬럼 | 범주 수 | 식 | 측정 |
|---|---|---|---|
| Sex | 2 | 48 | 50 |
| Race | 5 | 119 | 140 |
| Marital-Status | 7 | 157 | 170 |
| Workclass | 9 | 194 | 180 |
| Education | 16 | 312 | 350 |
| Native_country | 42 | 712 | 825 |
식과 측정의 차이는 측정값의 15% 안쪽이었다. 어느 판정을 줄일지에 따라 필요한 크기는 다르다. 이 데이터에서 데이터셋 판정은 윈도 200이면 1%다. 모든 컬럼의 판정을 5%로 두려면 800행이 넘는다. 윈도를 키우면 변화를 늦게 알게 된다. 요청이 하루 1000건이면 윈도 500은 반나절 치다. 얼마나 빨리 알아야 하는지와 오경보를 얼마나 견딜지를 먼저 정해야 크기를 고를 수 있다.
윈도를 키우지 못하면 다른 설정을 쓸 수 있다.
- 컬럼별 임곗값: 범주가 많은 컬럼의 임곗값을 올린다.
DatasetDriftMetric(per_column_stattest_threshold={...})로 주어야 드리프트 컬럼 비율이 바뀐다. 실습 윈도에서 세 컬럼을 0.3으로 주면 0.5가 0.125로 내려갔다.ColumnDriftMetric의stattest_threshold는 그 컬럼의 판정만 바꾸고 비율은 0.5 그대로였다. 거리는 임곗값을 올리면 덜 민감해진다. p값 방식은 임곗값을 올리면 오히려 더 민감해진다. - 범주 묶기: 드문 범주를 묶어 $k$를 줄인다.
- 데이터셋 기준:
DatasetDriftMetric(drift_share=...)로 앞의 0.5를 올린다. 컬럼 몇 개만 실제로 바뀐 경우를 놓치기 쉽다. - 연속 판정: 스터디 노트가 제안한 대로 연속 몇 회 넘을 때만 알린다. 겹치지 않는 윈도일 때 효과가 있다. 책의 서비스는 요청마다 윈도를 한 행씩 밀기 때문에 이웃 윈도가 99행을 공유한다. 윈도 100에서 한 행씩 밀면 오경보 55%가 3회 연속 50%, 10회 연속 38%였다. 겹치지 않게 자르면 3회 연속 16%, 5회 연속 2%였다.
판정 방법과 reference 크기
거리 대신 chi-square를 쓰면 어떨까. 판정 방법은 stattest 인자로 고를 수 있으므로 reference를 유지한 채 방법만 바꿀 수 있다. reference를 1000행으로 줄이면 기본 규칙이 chi-square를 고른다. 두 경우를 비교했다. 표는 데이터셋 드리프트 판정 비율이다. 첫 값은 앞 표의 값이며 나머지 두 열은 Evidently로 윈도를 300번 판정한 값이다(결과).
| 윈도 크기 | 기본값(거리, reference 전체) | stattest="chisquare", reference 전체 |
기본값(chi-square), reference 1000행 |
|---|---|---|---|
| 50 | 98% | 0.7% | 1.7% |
| 100 | 57% | 0.7% | 5.7% |
| 200 | 1% | 0% | 9.0% |
reference를 유지하고 방법만 바꾸면 데이터셋 오경보는 1% 아래다. 컬럼 판정은 대체로 4~11%였고 Native_country만 14~23%로 높았다. reference를 줄이면 윈도가 커질수록 오경보가 늘었다. 기대 빈도를 만드는 방식 때문이다.
# evidently/calculations/stattests/chisquare_stattest.py (v0.5.0, 발췌)
k_norm = current_data.shape[0] / reference_data.shape[0]
f_exp = [ref_feature_dict[key] * k_norm for key in keys]
f_obs = [current_feature_dict[key] for key in keys]
p_value = chisquare(f_obs, f_exp)[1]
기대 빈도는 current의 행 수로 환산한 reference의 빈도다. 그런데 reference도 표본이다. 이 코드는 reference 비율을 오차 없는 참값으로 두므로 윈도가 reference 크기에 가까워질수록 통계량이 커진다. 드문 범주가 없는 Relationship도 reference 1000행에서 윈도 50일 때 8%, 200일 때 11%, 500일 때 21%, 1000일 때 35%였다(결과).
reference를 줄이면 current에는 있는데 reference 1000행에는 없는 범주가 나올 수 있다. 이때는 기대 빈도가 0이 되어 통계량이 무한대로 가고 p값이 0이 된다. Native_country는 윈도 200에서 84%의 시행에 이런 범주가 나왔고 그때의 판정은 모두 드리프트였다(결과).
reference는 판정 비용 때문에 줄인다. 책의 보고서 구성으로 잰 report.run의 중앙값은 reference 전체일 때 약 400ms, 1000행일 때 약 40ms였다. 비용 때문에 줄이더라도 방법은 stattest로 따로 고른다. 줄인 reference의 표본 오차가 판정에 들어간다는 점도 감안하는 편이 낫다.
표본이 크면
행이 독립이고 reference가 크면 거리 판정의 오경보는 윈도가 작을 때 생긴다. 표본이 커지면 가설 검정 쪽에서 다른 문제가 나타난다. 범주 5개 분포에서 45%를 45.5%로, 5%를 4.5%로 옮긴 표본을 원래 분포의 표본과 비교했다. 두 표본의 크기는 같고 검정은 두 표본 chi-square다. 표는 1000번 실행의 값이다.
| 표본 크기 | p값 중앙값 | p<0.05 비율 | 거리 평균 |
|---|---|---|---|
| 1만 | 0.21 | 22% | 0.0123 |
| 10만 | 1.9e-6 | 99.5% | 0.0090 |
| 100만 | 2.3e-62 | 100% | 0.0086 |
100만 건이면 chi-square는 이 변화를 확실하게 판정한다. 분포를 실제로 바꿨으니 판정이 틀린 것은 아니다. 변화 없는 표본을 주면 100만 건에서도 4.1%였다. 그런데 chi-square는 대응할 필요가 없는 작은 변화까지 유의하다고 답한다. 거리는 실제 차이 0.0085로 수렴해 기준 0.1에 한참 못 미친다. 그래서 표본이 크면 얼마만큼의 변화에 대응할지를 따로 정해야 한다.
Evidently의 기본 규칙은 reference 크기로 방법을 고른다. 이번 측정에서는 윈도 크기에 따라 판정이 갈렸다.
정리
들어가며의 두 질문에 답을 적으면 이렇다.
왜 8개 중 4개, 7개가 넘었나. 고정 기준 0.1이 윈도 크기를 반영하지 않아서다. 윈도 100에서 범주가 많은 세 컬럼은 표본 오차만으로 거의 늘 기준을 넘고 나머지가 확률적으로 더해진다. 0.5와 0.875는 무작위 윈도의 드리프트 컬럼 비율 분포 안의 값이다.
윈도를 얼마나 키워야 하나. 이 데이터의 데이터셋 판정은 윈도 200이면 1%다. 컬럼 판정까지 정하려면 허용할 오경보 비율을 먼저 정하고 앞의 식으로 구한다. 범주가 많으면 윈도를 키우기보다 판정 방법이나 임곗값을 바꾸는 쪽이 낫다.
이 글의 데이터는 행 하나가 사람 한 명인 표 데이터다. 행끼리 독립이라고 볼 수 있으니 $n$은 행 수다. 다음 글에서는 공개 주행 영상 데이터로 옮겨 행이 프레임일 때 $n$이 무엇이 되는지 본다.
참고 링크
- 실험 코드, 데이터, 결과
- 책 6장 실습 저장소
- Evidently: Data drift algorithm
- Evidently v0.5.0 기본 검정 선택 소스
- SciPy
jensenshannon - UCI Adult
댓글남기기