[Evidently] 머신러닝 플랫폼 엔지니어링: Evidently와 Kubeflow Notebooks - 6.2.2. 주행 영상 데이터의 드리프트 판정: 프레임 수와 영상 수
시리즈 · 머신러닝 플랫폼 엔지니어링: Evidently와 Kubeflow Notebooks (2 / 2)·← 이전 편
서종호(가시다)님의 Machine Learning Platform Engineering Study 3주차 학습 내용을 기반으로 합니다.
TL;DR
- Sama Drives California의 라벨에는 영상 내내 값이 같은 것과 프레임마다 달라지는 것이 섞여 있다. 프레임 1행 표로 판정하면 행 수가 표본 수가 되지 않는다
- 공개 데이터 Sama Drives California(영상 171개, 25,136프레임)의 태그 8개로 측정했다. 분포를 바꾸지 않아도 프레임 1,470장을 무작위로 뽑으면 데이터셋 드리프트 판정이 0%, 같은 양을 영상 10개로 묶으면 57%였다
- 거리에서 거꾸로 구한 유효 표본 수는 약 1,470프레임 배치에서
weather6,vehicles24,sign54였다. 프레임마다 값이 바뀌는 태그도 표본 수는 프레임 수가 아니다 - 영상을 섞은 조건에서 표본 수는 영상 수와 자릿수가 같다. 녹화 순서의 연속 구간은 그보다 훨씬 작다. 연속 구간은 영상을 네 배로 늘려도 평균 거리가 거의 줄지 않았다
- 영상 20개 배치의
timeofday오경보는 기본값 65%, 영상당 1행 두 표본 chi-square 6%, 영상 재표본 임곗값 4%였다. 어두운 영상이 30%인 배치는 각각 96%, 27%, 9% 판정됐다 - 이 표본 크기로는 작은 변화를 안정적으로 잡기 어렵다. 판정 결과로 재학습을 바로 시작하기보다 사람이 태그별 변화를 보는 입력으로 쓰는 쪽이 맞아 보인다
- 측정한 것은 운행 설계 영역(ODD)의 시간대, 날씨와 장면 일부인 범주형 태그다. 클래스 분포, 박스 크기, 거리, 센서 구성의 드리프트는 다루지 않았다
들어가며
앞 글에서 Evidently의 기본 판정은 윈도 크기를 보지 않아 같은 분포에서도 약 $\sqrt{(k-1)/(8n)}$의 거리가 나왔다($k$는 범주 수). 거기서 표본 수 $n$은 표의 행 수였다. 행 하나가 사람 한 명인 소득 데이터라 자연스러운 가정이다.
2주차 글에서 비전 데이터도 픽셀 밖의 항목은 분위수와 비율로 잴 수 있다고 썼고 장면을 세는 범주 체계로 운행 설계 영역(Operational Design Domain, ODD)을 들었다. ODD는 자율주행 시스템이 동작하도록 설계된 조건의 집합이고 날씨와 시간대가 여기에 든다. 학습이 걸리는 시점에 이번 데이터의 장면 구성이 지난번과 어떻게 다른지를 플랫폼이 알려 주면 좋겠다고도 썼다. 장면 태그는 표로 만들 수 있으니 드리프트 판정을 얹어 볼 수 있다. 이때 current는 서빙 요청의 윈도가 아니라 새로 들어온 주행 데이터 묶음이다. reference는 그 전까지 쌓인 데이터다. 이 글에서는 이 묶음을 배치(batch)라고 부른다. 앞 글의 윈도에 해당한다.
공개 주행 데이터의 라벨에는 영상 내내 값이 같은 것과 프레임마다 달라지는 것이 함께 있다. 이런 표를 프레임 그대로 넣으면 $n$은 무엇이 될까. 그리고 그 판정을 어디에 쓸 수 있을까. 공개 주행 데이터로 측정했다. 앞 글과 마찬가지로 실험 코드 작성과 실행에는 AI의 도움을 받았다. 코드와 데이터는 실험 폴더에 두었다.
데이터
Sama Drives California는 캘리포니아를 달린 차의 대시보드 카메라 영상을 1fps로 뽑은 데이터다. 라이선스는 CC BY 4.0이고 등록 없이 받을 수 있다. 영상은 171개, 프레임은 25,136장으로 약 7시간이다. 영상 하나의 길이는 평균 147프레임이고 가장 긴 것이 180프레임이다. 데이터 카드에 따르면 영상은 시간 간격 없이 이어서 녹화됐고 민감한 내용이 있거나 주차 중인 영상은 빠졌다. 차 한 대가 이어서 달린 주행이고 낮에서 밤으로 흐른다.
프레임마다 timeofday, weather 라벨이 있고 차량, 차선, 표지판 같은 객체 라벨이 있다. 이미지는 쓰지 않고 라벨만 프레임 1행 표로 만들었다. 원본 라벨 둘에 객체 라벨로 만든 컬럼 여섯을 더해 8개 컬럼을 두었다. 앞 글처럼 컬럼이 8개이면 데이터셋 판정을 같은 틀로 볼 수 있어서다. 데이터셋 판정 비율은 컬럼 구성에 따라 달라지므로 이 글의 숫자는 이 8개 컬럼에서 나온 값이다.
| 컬럼 | 뜻 | 값 수($k$) |
|---|---|---|
timeofday |
시간대(원본 라벨) | 3 |
weather |
날씨(원본 라벨) | 4 |
traffic |
교통량. 프레임의 객체 속성 중 가장 많은 값 | 4 |
vehicles |
프레임의 차량 수 구간(0, 1-2, 3-5, 6+) | 4 |
sign |
표지판이 있는가 | 2 |
traffic_light |
신호등이 있는가 | 2 |
pedestrian |
보행자가 있는가 | 2 |
opposite_lane |
반대 차로가 있는가 | 2 |
2주차 글의 항목으로 보면 이 8개 컬럼은 ODD의 시간대, 날씨와 장면의 일부이고 모두 범주형이다. 클래스 롱테일, 박스 크기, 가림은 라벨에서 구할 수 있지만 이 글에서는 쓰지 않았다. 거리, 지역, 센서 구성은 이 데이터로 재기 어렵다. 분위수로 재는 수치형 항목의 드리프트도 다루지 않는다.
표를 만든 코드는 sama_table.py, 결과는 sama_frames.csv다.
프레임과 영상
먼저 영상을 무작위로 섞어 분포를 바꾸지 않은 배치를 만들었다. 이 글에서는 데이터가 나오는 과정이 바뀌지 않았는데 드리프트로 판정되면 오경보라고 부른다. 영상을 섞어 뽑아도 배치에 눈 온 영상이 우연히 쏠리면 구성이 실제로 다르다. 구성 차이를 알려 주는 목적이라면 맞는 정보다. 변화를 잡는 목적이라면 오경보다.
아래 표는 두 방식으로 뽑은 배치의 판정 비율이다. 기본값은 앞 글의 거리 기준 0.1이고 reference는 나머지 전체다. 태그 네 열은 컬럼 판정 비율이다. 프레임 무작위는 비교용 대조군이다. 프레임이 이렇게 섞여 들어오는 일은 없다. 영상 묶음은 5000번, 프레임 무작위는 1000번 뽑았다(결과).
| 배치 구성 | 프레임 수 | 데이터셋 판정 | timeofday |
weather |
vehicles |
sign |
|---|---|---|---|---|---|---|
| 프레임 무작위 | 1,470 | 0% | 0% | 0% | 0% | 0% |
| 영상 10개 | 1,471 | 57% | 88% | 95% | 57% | 5% |
| 프레임 무작위 | 2,940 | 0% | 0% | 0% | 0% | 0% |
| 영상 20개 | 2,940 | 15% | 62% | 76% | 29% | 1% |
| 프레임 무작위 | 5,880 | 0% | 0% | 0% | 0% | 0% |
| 영상 40개 | 5,878 | 2% | 38% | 63% | 11% | 0% |
프레임 수가 같아도 영상으로 묶으면 판정이 달라진다. 앞 글의 식으로 보면 범주 4개 컬럼의 오경보 5%는 약 98행이면 되니 프레임 1,470장은 충분하다. 그런데 그 프레임이 영상 10개에서 왔다면 weather 값은 10번 뽑은 것에 가깝다. 영상 안의 프레임은 같은 값을 반복할 뿐이다. 행이 서로 독립이라면 몇 개에 해당하는지를 나타내는 값이 유효 표본 수(effective sample size)다.
앞 글은 reference가 커서 그 오차를 무시했다. 이번에는 reference도 크기가 비슷한 표본이라 두 표본의 오차가 더해진다. 배치 크기를 $n$, reference 크기를 $N$이라 하면 거리의 크기는 다음과 같다.
weather($k=4$)의 측정값과 비교했다. 식(프레임 수)는 $n$과 $N$에 프레임 수를, 식(영상 수)는 영상 수를 넣은 값이다.
| 배치 구성 | 측정 평균 거리 | 식(프레임 수) | 식(영상 수) |
|---|---|---|---|
| 프레임 무작위 1,470장 | 0.015 | 0.016 | 해당 없음 |
| 영상 10개 | 0.239 | 0.016 | 0.200 |
| 영상 20개 | 0.167 | 0.012 | 0.146 |
| 영상 40개 | 0.119 | 0.009 | 0.111 |
| 영상 80개 | 0.097 | 0.008 | 0.094 |
영상으로 묶으면 측정값이 프레임 수를 넣은 식의 10배 이상이다. 영상 수를 넣은 식과는 자릿수가 같다. 작은 배치에서는 측정값이 식보다 크다. 영상 길이 차이와 작은 배치의 근사 오차가 겹친 것으로 보인다.
유효 표본 수를 태그별로 구해 보았다. 평균 제곱 거리를 위 식에 넣어 $n$을 푼 값이다. 작은 순으로 정렬했다(결과).
| 태그 | 영상 내내 같은 값인 영상 | 영상 10개(약 1,470프레임) | 영상 20개(약 2,940프레임) |
|---|---|---|---|
weather |
100% | 6 | 13 |
timeofday |
100% | 7 | 13 |
opposite_lane |
54% | 11 | 24 |
traffic |
43% | 19 | 38 |
vehicles |
4% | 24 | 50 |
traffic_light |
53% | 35 | 68 |
sign |
2% | 54 | 103 |
pedestrian |
81% | 55 | 101 |
timeofday와 weather는 영상 수에 가깝다. 프레임마다 값이 바뀌는 태그도 표본 수는 프레임 수가 아니다. sign도 프레임 수의 4%쯤이고 vehicles는 2%쯤이다. 프레임마다 값이 바뀌어도 영상마다 쏠리는 값이 다르면 표본 수가 줄어드는 것으로 보인다. pedestrian은 영상 내내 같은 값이 많아도 거의 모두 no라서 영상끼리 차이가 작다. 영상 안의 고정 비율보다 영상 사이의 차이가 판정을 가르는 것으로 읽힌다.
영상을 무작위로 섞은 뒤 61개를 reference로 두고 나머지를 영상 10개씩 11개 배치로 대시보드에 쌓았다. 날짜 축은 배치 순서를 나타내려고 넣은 값이다.
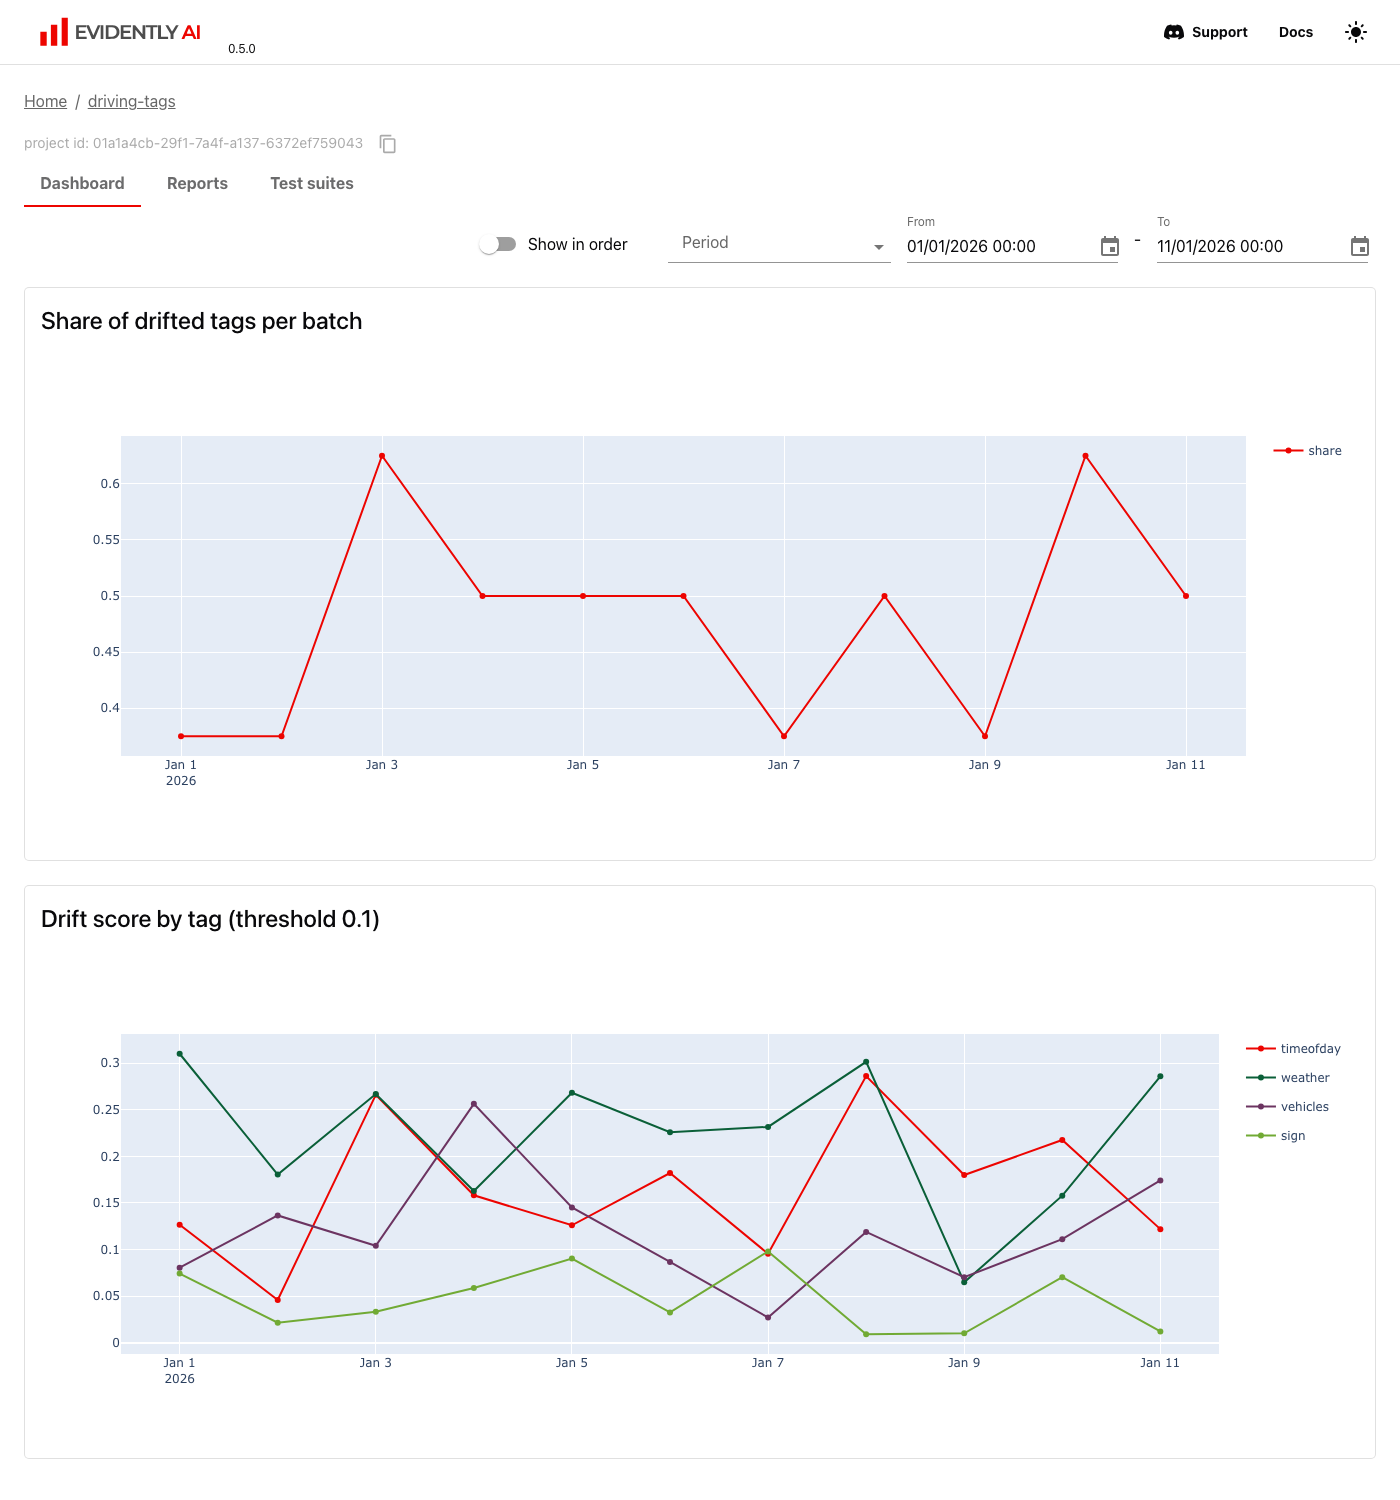
timeofday는 11개 배치 중 9개, weather는 10개에서 거리가 0.1을 넘었고 sign은 11개 모두 0.1 아래다. 같은 방식으로 따로 뽑은 영상 10개 배치의 보고서도 열어 볼 수 있다.
연속 구간
지금까지는 영상을 무작위로 섞었다. 실제 데이터는 이어서 들어온다. 녹화 순서로 보면 영상 171개에서 값이 이어지는 구간이 timeofday 11개, weather 21개다. 이웃한 영상이 같은 값인 비율은 0.94, 0.88이다. 연속한 영상을 묶은 배치의 평균 거리를 섞은 배치와 비교했다. reference는 나머지 영상이다.
| 태그 | 배치 구성 | 영상 10개 | 영상 20개 | 영상 40개 |
|---|---|---|---|---|
weather |
섞음 | 0.242 | 0.165 | 0.116 |
weather |
연속 구간 | 0.380 | 0.365 | 0.370 |
timeofday |
섞음 | 0.189 | 0.130 | 0.092 |
timeofday |
연속 구간 | 0.288 | 0.276 | 0.266 |
연속 구간은 영상을 네 배로 늘려도 거리가 거의 줄지 않는다. 그래서 표본 수가 영상 수에 가깝다는 말은 영상을 섞었을 때만 맞다. 이어서 들어오는 배치의 표본 수는 그보다 작다. 이 차이가 실제 변화인지 이웃 영상이 닮은 것인지는 이 데이터 하나로 나눌 수 없다.
실제 변화
녹화 순서로 자른 배치에는 눈에 보이는 변화가 있다. 앞 60개 영상을 reference로 두고 이후를 영상 10개씩 판정했다. reference는 프레임의 99%가 Day이고 98%가 Sunny다. 마지막 배치는 남은 영상 1개다. 마지막 열은 재표본 임곗값을 넘은 컬럼 수다. 재표본 임곗값은 뒤에서 설명한다.
| 영상 번호 | 프레임 수 | 드리프트 컬럼 비율 | timeofday 거리 |
weather 거리 |
가장 많은 시간대와 날씨 | 재표본 임곗값을 넘은 컬럼 |
|---|---|---|---|---|---|---|
| 061-070 | 1,184 | 0.500 | 0.051 | 0.089 | Day, Sunny | 4 |
| 071-081 | 1,560 | 0.750 | 0.051 | 0.222 | Day, Sunny | 4 |
| 082-091 | 1,320 | 0.375 | 0.051 | 0.089 | Day, Sunny | 2 |
| 092-101 | 762 | 0.625 | 0.051 | 0.468 | Day, Sunny | 1 |
| 102-111 | 1,800 | 0.500 | 0.051 | 0.833 | Day, Snowy | 3 |
| 112-121 | 1,800 | 0.750 | 0.051 | 0.487 | Day, Sunny | 5 |
| 122-131 | 1,800 | 0.625 | 0.051 | 0.353 | Day, Sunny | 4 |
| 132-141 | 1,800 | 0.625 | 0.051 | 0.118 | Day, Sunny | 2 |
| 142-151 | 1,800 | 0.875 | 0.318 | 0.212 | Day, Sunny | 4 |
| 152-161 | 1,653 | 0.750 | 0.703 | 0.311 | Dusk/Dawn/Twilight, Sunny | 5 |
| 162-171 | 1,697 | 0.500 | 0.833 | 0.814 | Night, Other | 3 |
| 172 | 95 | 0.875 | 0.833 | 0.833 | Night, Other | 7 |
눈이 온 102-111 배치는 weather 거리가, 밤이 된 162-171 배치는 timeofday 거리가 0.833이다. 앞 글에서 본 거리의 최댓값이다. reference에 없는 값만 나온 배치에서 나온다. 12개 배치 중 082-091을 뺀 11개가 데이터셋 드리프트로 판정됐다. 이 판정만으로는 어느 배치의 무엇이 달라졌는지 알기 어렵다. 눈이나 밤처럼 reference에 없던 값이 들어온 배치는 변화로 볼 수 있다. 하지만 061-070처럼 두 태그가 낮은 배치가 변하지 않았다는 근거도 없다.
변화의 크기를 조절해 보기도 했다. 영상을 절반으로 나눠 reference를 만들었다. 나머지에서 영상 20개를 뽑아 어두운 영상 수를 정했다. 어두운 영상은 낮이 아닌 영상이고 전체의 14%다. 무작위 행은 어두운 영상 수를 정하지 않고 뽑은 기준선이다. 고정한 행은 어두운 영상 수의 쏠림을 없앴으므로 기준선보다 판정이 낮을 수 있다.
| 배치 구성 | 어두운 프레임 비중 | timeofday 판정 |
데이터셋 판정 |
|---|---|---|---|
| 무작위 | 15% | 59% | 17% |
| 어두운 영상 3개 | 16% | 35% | 12% |
| 어두운 영상 6개 | 32% | 98% | 26% |
| 어두운 영상 10개 | 53% | 100% | 39% |
| 어두운 영상 12개 | 63% | 100% | 48% |
어두운 프레임이 네 배 가까이 늘어 timeofday는 기본값으로 100% 판정됐지만 데이터셋 판정은 절반을 넘지 못했다. 이 8개 컬럼에서 시간대와 함께 움직이는 컬럼은 일부뿐이다. 드리프트 컬럼 비율 0.5는 많은 컬럼이 함께 움직이는 변화를 찾는 기준이므로 태그 하나의 변화를 보려면 컬럼 판정을 따로 봐야 한다.
판정 방식 비교
기본값과 대안 네 가지를 같은 조건에서 비교했다. 영상을 무작위로 절반씩 나눠 한쪽을 reference(약 85개)로 두었다. 다른 쪽에서 영상 20개 배치를 뽑았다. 분할 100개 × 배치 200개의 평균이고 대상은 timeofday다. 변화 없음 열이 오경보이고 뒤의 두 열은 어두운 영상 비중을 정한 배치의 판정 비율이다(코드, 결과).
| 판정 방식 | 변화 없음 | 어두운 영상 30% | 어두운 영상 50% | 쓸 수 있는 태그 |
|---|---|---|---|---|
| 기본값(거리 0.1), 프레임 그대로 | 65% | 96% | 100% | 모두 |
| chi-square, 프레임 그대로 | 98% | - | - | 모두 |
| 영상당 1행, Evidently chi-square | 14% | 62% | 100% | 영상 단위 태그 |
| 영상당 1행, 두 표본 chi-square | 6% | 27% | 100% | 영상 단위 태그 |
| 영상 재표본 임곗값 | 4% | 9% | 90% | 모두 |
- 기본값: 변화가 없어도 65% 판정하므로 높은 판정 비율이 탐지 성능을 뜻하지 않는다.
- chi-square, 프레임 그대로:
stattest="chisquare"로 지정한 경우다. 검정은 행이 독립이라고 가정한다. 프레임 수만큼 표본이 있다고 믿으니 영상 몇 개의 쏠림을 유의한 차이로 판정한다. - 영상당 1행, Evidently chi-square: 영상마다 값이 하나인 태그는
groupby한 줄로 쓸 수 있다. reference가 1000행 이하이므로 Evidently가 chi-square를 고른다. 앞 글에서 본 대로 reference 빈도를 오차 없는 기대값으로 쓰기 때문에 오경보가 5%보다 높은 것으로 보인다. 앞 글의 reference에 없는 값 문제도 남는다. 영상이 1000개를 넘으면 기본 규칙이 거리로 돌아가므로stattest를 지정해야 한다. - 영상당 1행, 두 표본 chi-square: 같은 표를
scipy.stats.chi2_contingency로 검정한다. reference도 표본으로 보므로 오경보가 약 5%로 돌아왔다. - 영상 재표본 임곗값: reference에서 영상 20개를 뽑아 나머지와의 거리를 재는 일을 400번 반복한다. 그 95번째 백분위수를 임곗값으로 쓴다. 같은 분포에서 나오는 거리의 상위 5%를 드리프트로 보는 방식이다. 오경보는 설계상 약 5%이고 실제 8개 컬럼에서 4~8%였다. 임곗값은
timeofday0.25,weather0.30으로 기본값 0.1의 두세 배다. 프레임마다 값이 바뀌는 태그에도 쓸 수 있다. Evidently에서는stattest="jensenshannon"과 임곗값을 함께 넘겨야 한다.
같은 오경보 수준이면 영상 단위 태그에는 영상당 1행 두 표본 chi-square가 더 많이 잡았다. 프레임마다 값이 바뀌는 태그에는 재표본 임곗값이 남는다. 재표본 임곗값은 곧 검정이므로 표본이 많아지면 앞 글의 큰 표본 문제가 돌아올 수 있다. 얼마만큼의 변화에 대응할지는 따로 정해야 한다.
어두운 영상 30%는 전체의 14%에서 두 배쯤 늘어난 배치다. 영상 20개 배치에서 3개와 6개의 차이다. 재표본 임곗값으로는 이 변화가 우연과 구분되지 않았다. 영상 10개 배치에서는 같은 30%가 재표본 임곗값으로 14%, 두 표본 chi-square로 17% 판정됐다. 영상 20개에서 재표본 쪽이 오히려 낮다. 평균 거리는 비슷한데(0.190, 0.175) 표준편차가 0.060에서 0.031로 줄어서다. 작은 배치는 흔들림으로 임곗값을 넘는 일이 많다.
실제 변화 표의 마지막 열은 앞 60개 영상 안에서 같은 방식으로 임곗값을 잡아 영상 10개 배치에 적용한 결과다. timeofday는 뒤 4개 배치만 넘었고 vehicles는 12개 중 11개에서 넘었다. 이 reference는 거의 Day, Sunny인 구간이라 재표본은 그 안의 변동만 우연으로 친다. reference가 데이터의 변동을 담지 못하면 임곗값은 그 밖을 모두 변화로 본다.
컬럼 판정을 볼 때는 컬럼 수도 봐야 한다. 영상 20개 배치에서 변화가 없어도 8개 중 하나 이상이 넘는 비율은 기본값 97%, 재표본 임곗값 35%였다. 임곗값을 1−0.05/8 분위로 올리면 11%였다.
기본 임곗값을 유지한다면 앞 글의 식으로 $k=3$에서 75개, $k=4$에서 98개가 오경보 5%에 필요한 표본 수다. 영상이 독립일 때의 영상 개수다. 이 데이터는 영상이 171개뿐이라 그만큼의 배치를 만들면 reference가 모자란다.
판정 뒤의 동작
판정을 얻으면 무엇을 할 수 있을까. 책의 코드가 판정을 어떻게 쓰는지 읽어 봤다. 이 절은 코드를 읽은 내용이고 실행해 본 것은 아니다.
책은 배치 파이프라인 절에서 드리프트가 탐지되면 파이프라인 실행을 중단한다고 설명한다(스터디 노트의 번역문 기준). 이 파이프라인은 Kubeflow Pipelines로 돈다. 앞 단계가 실패해야 뒤 단계가 멈춘다. 파이프라인 정의를 보면 추론 단계는 드리프트 단계 뒤에 실행될 뿐이다.
# evidently/kubeflow-pipeline/inference_pipeline.py (발췌)
run_inference_task = run_inference_op(
    ...
    input_data=retrieve_features_task.outputs["data_output"],
).after(detect_drift_task)
.after()는 순서만 정한다. detect_drift가 직접 던지는 예외는 모델과 참조 데이터를 찾지 못한 경우뿐이다. 컴포넌트 정의에도 출력이 없어 판정 결과가 뒤 단계로 넘어가지 않는다. 스터디 노트도 드리프트가 탐지돼도 추론은 진행된다고 짚었다. 멈추려면 드리프트 여부를 출력으로 받아 dsl.If로 분기해야 한다고 적었다.
API 경로에서는 판정이 요청 안에서 돈다. BentoML 서비스의 predict는 예측 전에 모니터링 서비스의 iterate를 호출한다. iterate는 윈도가 찬 뒤로 요청마다 보고서를 만들고 워크스페이스에 올린다.
# bentoml/data_drift.py (발췌)
if current_size < self.window_size:
    ...
    return
self.report.timestamp = datetime.datetime.now()
logger.info("Running report")
self.report.run(
    reference_data=self.reference,
    current_data=self.current,
)
self.workspace.add_report(project_id=self.project_id, report=self.report)
앞 글에서 잰 report.run은 reference 전체 기준 약 400ms이므로 그만큼 응답이 늦어질 것으로 보인다. 윈도는 프로세스 메모리에 있어서 워커가 여럿이면 워커마다 따로 쌓인다. 스터디 실습이 워커를 하나로 둔 데는 이 이유도 있다. 요청 경로에서 빼려면 예측 로그를 남기고 판정을 별도 작업으로 돌리는 구성을 생각할 수 있다. 서버로 요청이 오지 않는 모델에는 이 경로가 없다. 데이터가 들어오는 시점에 배치로 판정하는 구성을 생각할 수 있다.
정리
주행 데이터처럼 프레임이 영상에 묶여 있으면 표의 행 수는 표본 수가 아니다. 영상 단위 태그의 $n$은 영상을 섞은 조건에서 영상 수에 가깝다. 프레임마다 바뀌는 태그도 프레임 수보다 훨씬 작다. 이어서 들어오는 배치의 표본 수는 그보다 더 작다.
이 데이터에서 판정을 만든다면 영상 단위 태그는 영상당 1행으로 줄여 두 표본 검정을 쓰고 나머지 태그는 영상 단위 재표본으로 임곗값을 잡는 조합이 나았다. 데이터셋 판정보다 컬럼 판정을 보고 컬럼 수만큼 임곗값을 조정해야 한다.
처음의 질문으로 돌아가면 판정 결과로 재학습을 바로 시작하기는 어려워 보인다. 영상 20개 배치로는 어두운 영상이 두 배로 늘어도 안정적으로 잡지 못했다. 연속 구간의 차이는 변화와 닮음이 섞여 있다. 분포 변화를 보려는 목적이라면 경보보다 태그별 비율 변화와 그 변화가 몰린 영상을 사람이 보는 쪽이 맞는다고 본다.
공개 데이터 하나로 측정한 값이다. 차 한 대가 이어서 달린 약 7시간 주행이다. 다른 데이터의 값은 다를 수 있다.
댓글남기기