[Kubernetes] 쿠버네티스 스케줄링 - 1. 개념과 kube-scheduler 구조
Kubernetes › 스케줄링·MLOps › 자원 관리·스케줄링·개념
시리즈 · 쿠버네티스 스케줄링 (2 / 7)·← 이전 편·다음 편 →
TL;DR
- 쿠버네티스 스케줄링이란,
kube-scheduler가 파드(Pod)를 적합한 노드에 배치하는 프로세스다. 스케줄러는 노드가 결정되지 않은 파드를 감지하여, 스케줄링 요구 사항에 맞는 노드를 필터링하고 스코어링으로 최적 노드를 선택한다. kube-scheduler는 컨트롤 플레인에서 실행되며(Static Pod, systemd 서비스, 프로세스 내장 등 배포 방식은 다양), 교체하거나 여러 스케줄러를 동시에 운영할 수 있다. 파드는spec.schedulerName으로 사용할 스케줄러를 지정하며, 각 스케줄러는 자신의 이름과 일치하는 파드만 처리한다(이름이 겹치지 않으면 경쟁 없음).- 스케줄러의 판단 기준은 오직
spec.nodeName이다.status.phase: Pending은 판단 기준이 아니다. - 스케줄러를 거치지 않는 수동 스케줄링은 파드 생성 시
spec.nodeName을 직접 지정하거나, 이미 생성된 파드에 대해 Binding 오브젝트를 생성하는 방식으로 가능하다. 수동 스케줄링이 실제로 활용된 대표 사례인 DaemonSet은ScheduleDaemonSetPodsFeature Gate가 기본 활성화된 v1.12부터 NodeAffinity(matchFields) 기반으로 전환되어kube-scheduler에 위임되며, v1.17에 GA가 되었다. - 수동 스케줄링은 Filter 단계를 건너뛰지만 kubelet이 일부 조건을 다시 검사한다. cordon,
NoScheduletaint, InterPodAffinity, PodTopologySpread는 아무도 검사하지 않는다. kube-scheduler내부는 Scheduling Framework(extension point의 종류와 순서), 플러그인(바이너리에 컴파일된 판단 로직), 프로필(schedulerName별로 플러그인을 고르는 설정)로 나뉜다. 프로필은 바이너리에 있는 플러그인만 고를 수 있고, 없는 플러그인(예: Coscheduling)을 쓰려면 바이너리를 다시 빌드해야 한다.- Scheduling Framework는 코어(오케스트레이터)를 가볍게 유지하고, 구체적인 판단 로직은 모두 플러그인에 격리하는 설계다. 플러그인은 Go 패키지로 구현되어 스케줄러 바이너리에 함께 컴파일되며(in-process), 이는 성능과 상태 공유를 위한 의도적 결정이다.
- 스케줄러 프로세스를 여러 개 두면 서로의 예약 상태를 모르므로 같은 노드 자원을 동시에 고를 수 있다. API Server는 이를 막지 않고, 늦게 도착한 파드를 kubelet이 거부한다. 기본 바이너리의 플러그인으로 충분하면 한 프로세스 안에서 프로필을 늘리는 편이 적절하다.
들어가며
쿠버네티스를 운영하다 보면, 파드가 Pending 상태에 빠져 있는 상황을 마주하게 된다. 왜 이 파드는 특정 노드에 배치되지 않는지, 왜 리소스가 충분해 보이는데도 스케줄링에 실패하는지, 혹은 Deployment를 업데이트했는데 새 파드가 영원히 뜨지 않는 상황이 왜 발생했는지를 이해하려면, 스케줄링의 동작 방식을 알아야 한다.
스케줄러 일반의 개념(쿠버네티스 밖의 Slurm, LSF 포함)과 그 안에서 쿠버네티스 스케줄링 모델의 위치는 0편에서 정리했다. 이 글은 그중 쿠버네티스 위의 스케줄러가 따르는 규칙과, 기본 스케줄러 kube-scheduler의 구조를 다룬다.
- 스케줄링의 기본 개념: 스케줄링이란 무엇이고, 무엇이 아닌지
- 스케줄러:
kube-scheduler의 실행 방식, 교체 가능 여부, 다중 스케줄러 운영과 파드 매칭 방식 - 스케줄링 대상: 스케줄러의 유일한 판단 기준 (
spec.nodeName)과 판단 기준이 아닌 것 (Pending,PodScheduled) - 수동 스케줄링: 스케줄러를 거치지 않는 노드 배치 방법 (
spec.nodeName직접 지정, Binding 오브젝트)과 대표 사례인 DaemonSet의 스케줄러 위임 전환 - kube-scheduler 구조: Scheduling Framework, 플러그인, 프로필의 관계와 다중 스케줄러 구성
스케줄러 큐(Active / Backoff / Unschedulable)는 파드가 처리되는 과정의 일부이므로 2편 - 스케줄러 큐에서 다룬다.
도입부의 세 질문 중 앞의 두 질문(특정 노드에 배치되지 않는 이유, 리소스가 충분해 보이는데도 실패하는 이유)은 2편의 Filter·Score와 3편의 제어 설정이 다루고, 세 번째 질문(Deployment 업데이트 후 새 파드가 뜨지 않는 이유)은 2편 - 프로세스 결과와 큐 이동 요약의 실전 사례가 다룬다. 실제 파드에서 실패 지점과 큐를 확인하는 절차는 6편 - 스케줄링 실패 진단에 있다.
이 시리즈는 파드가 처음 노드에 배치되는 시점의 결정만 다룬다. 배치된 뒤의 재배치(Descheduler), 축출(Eviction과 PodDisruptionBudget), 노드 증설(Cluster Autoscaler)은 스케줄링 결과에 영향을 주지만 kube-scheduler의 책임이 아니므로 범위 밖으로 둔다. 본문에 이 이름들이 나올 때는 스케줄링 결정과 맞닿는 지점만 짚는다.
본문 기준 버전은 v1.32이며, 그보다 최신 기능(PodGroup 스케줄링 등)은 등장 지점에 버전을 따로 표기한다.
스케줄링
개념
Kubernetes 스케줄링이란, 스케줄러가 파드를 적합한 노드에 배치하는 프로세스를 의미한다. 기본 스케줄러는 kube-scheduler다. 스케줄러의 핵심 역할은 파드가 배포될 적합한 노드를 결정하는 것이다. 스케줄러가 다루는 대상은 구체적으로 다음과 같다.
- 새로 생성되는 파드 중 노드가 결정되지 않은 경우: 파드가 API Server에 등록되었지만 아직
spec.nodeName이 설정되지 않은 상태 - 생성되었지만 적합한 노드를 아직 찾지 못한 경우: 이전 스케줄링 시도에서 실패하여 큐에서 대기 중인 파드
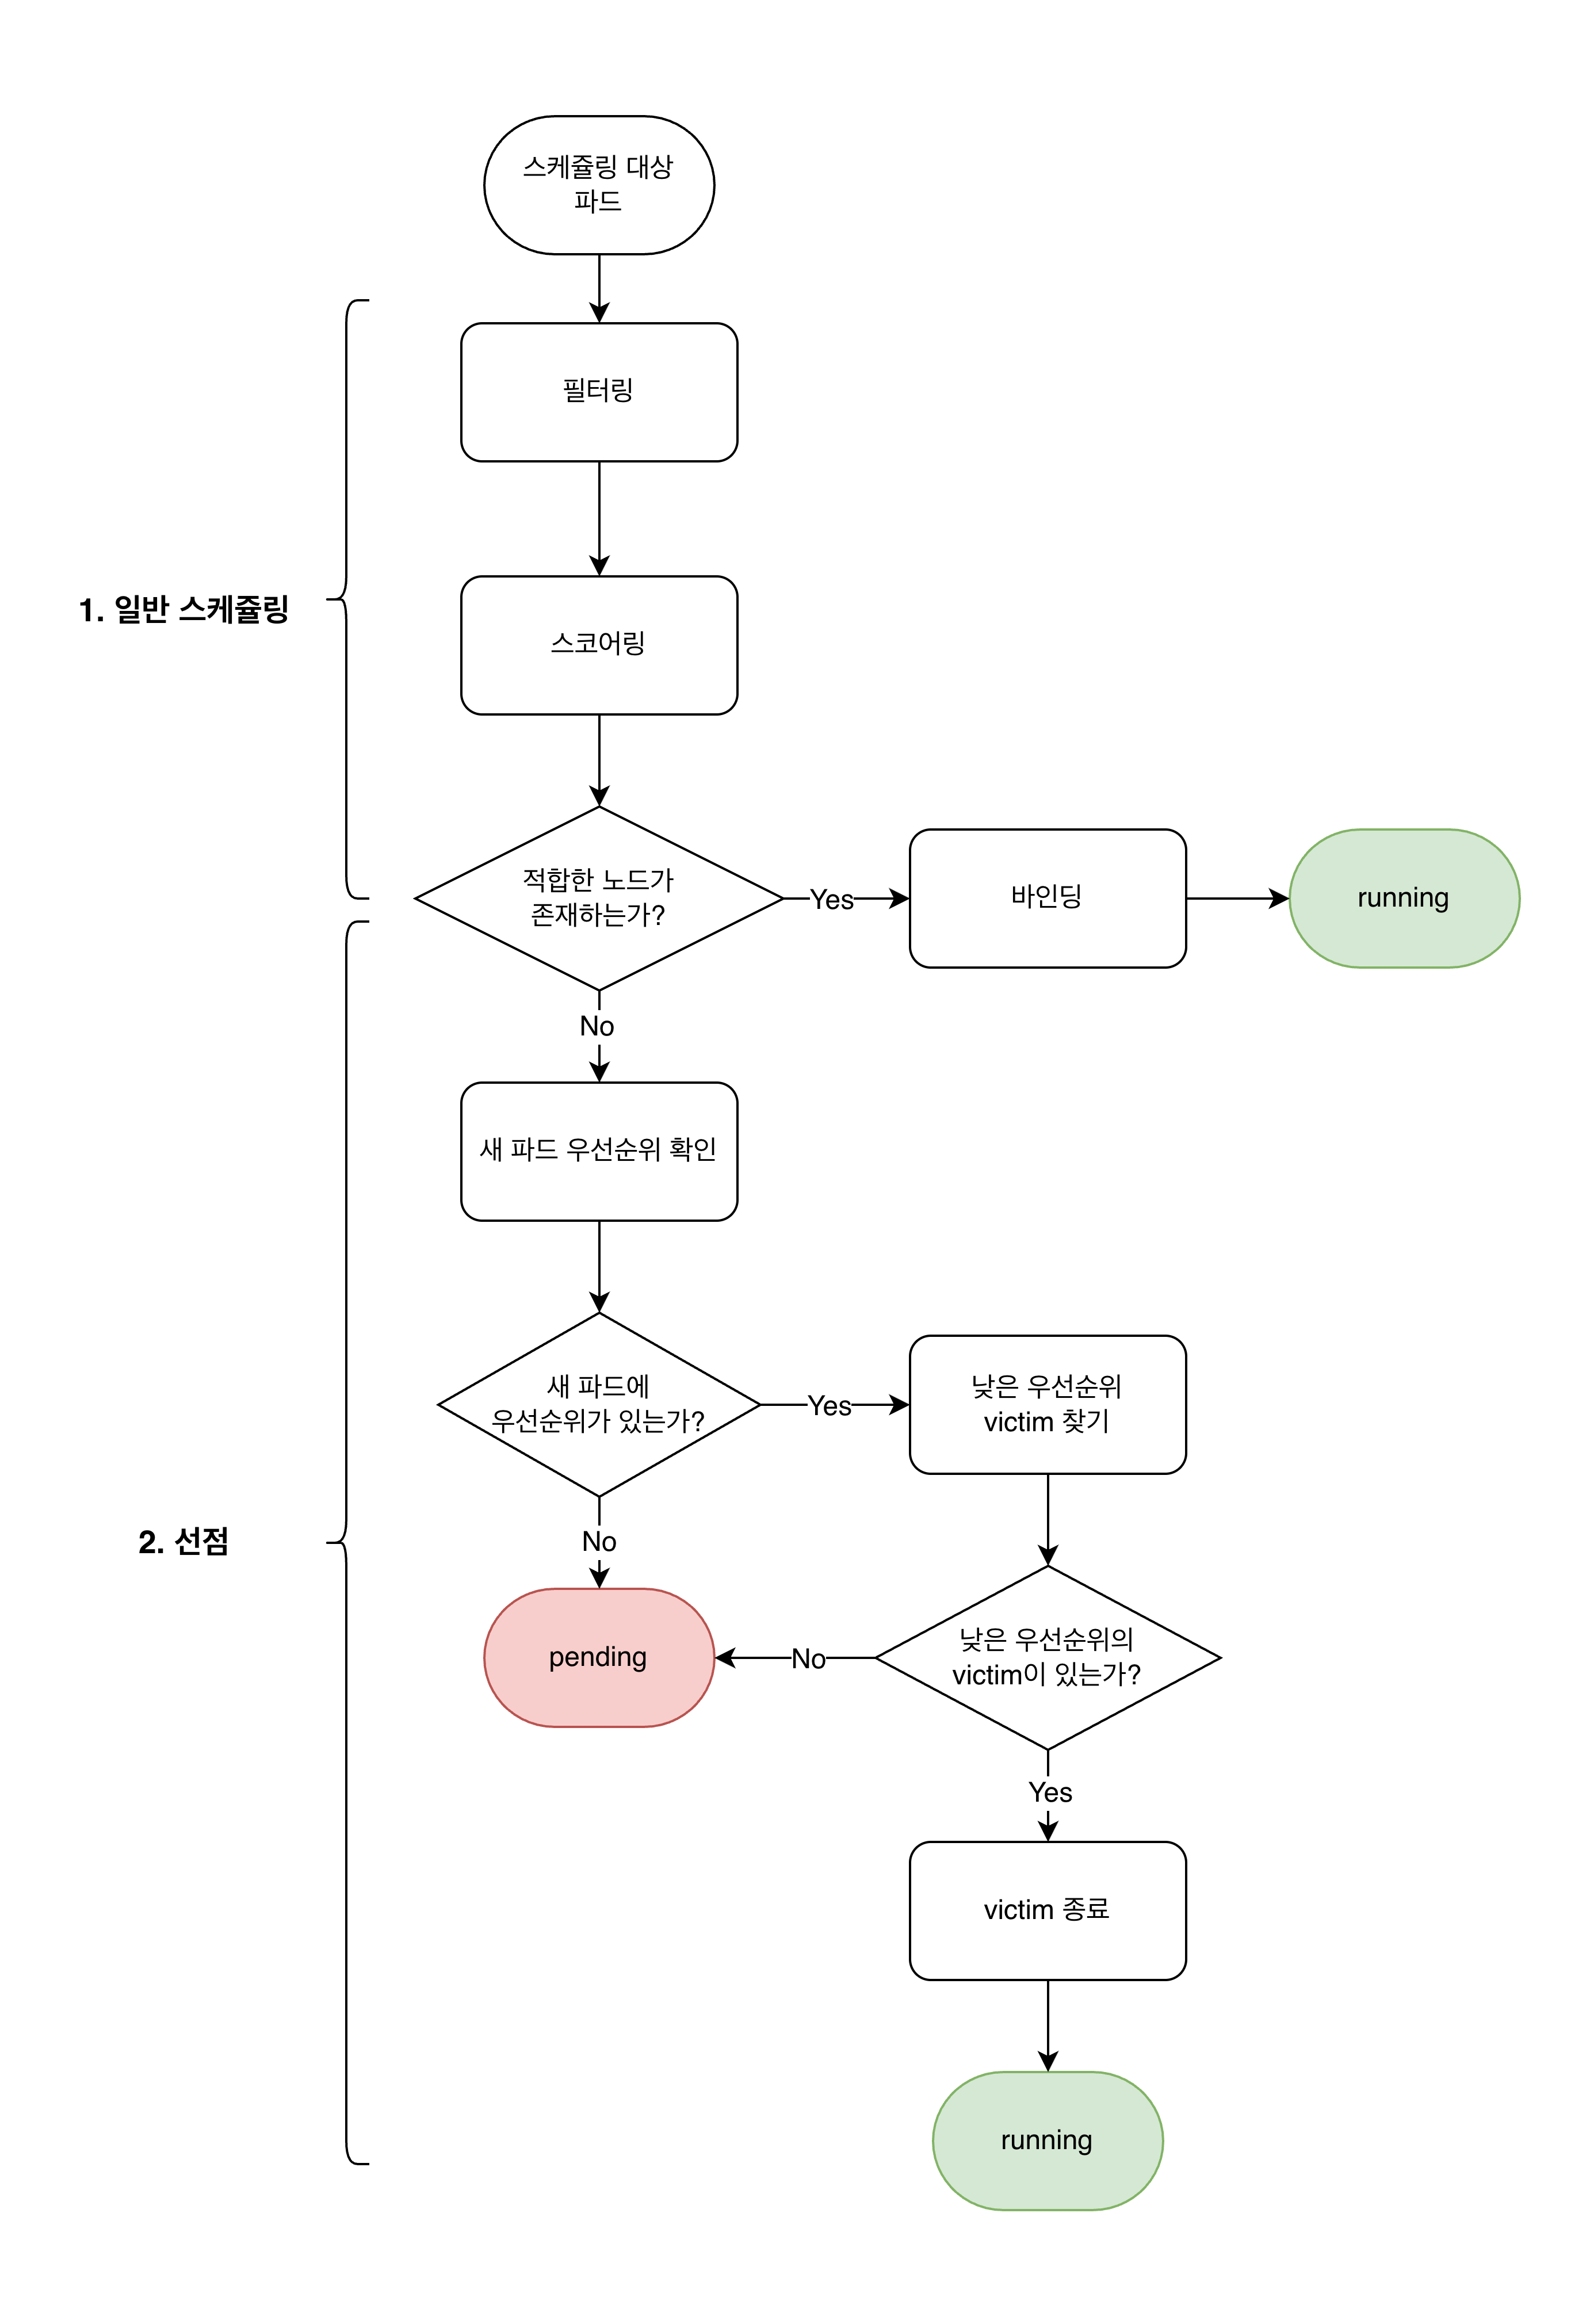
스케줄러가 이러한 파드를 감지하면, 파드에 정의된 스케줄링 요구 사항(리소스 요청은 2편 - Filter의 NodeResourcesFit에서, nodeSelector·affinity는 3편에서 후술)에 맞는 노드를 필터링하고, 스코어링 과정을 통해 배포에 적합한 노드 순서를 정렬한 뒤, 최적의 노드를 선택하여 바인딩한다. 전체 흐름을 요약하면 다음과 같다.
kube-scheduler가 스케줄링이 필요한 파드를 감지- 필터링으로 파드의 스케줄링 요구 사항에 맞는 노드를 걸러냄 (남는 노드가 없으면 선점을 시도하고, 이번 시도는 실패로 끝나 큐로 돌아감)
- 스코어링으로 적합한 노드에 순위를 매김
- 최고 점수 노드에 파드를 바인딩
공식 문서 살펴 보기
공식 문서는 아래와 같이 정의한다.
In Kubernetes, scheduling refers to making sure that Pods are matched to nodes so that Kubelet can run them.
Kubelet이 실행할 수 있도록, 파드가 노드에 매치되게 하는 작업이라고 한다. 정의에서도 확인할 수 있지만, 스케줄링은 배치 작업일 뿐이다. 아래와 같은 작업은, 스케줄링이 아니다.
- 파드 생성 그 자체: 리소스 컨트롤러가 API server에 요청하면, API server가 etcd에 저장
- Deployment의 경우: Deployment Controller → ReplicaSet Controller → API Server
- 파드 실행: Kubelet 담당. Kubelet이 Container Runtime을 통해 실행. Scheduler는 어디서 실행할지만 결정
- 리소스 할당: Linux cgroups/namespaces가 담당
그리고 이와 같은 스케줄링에 포함될 수 있는 작업의 범위는 다음과 같다:
- 노드 선택: Filter + Score를 통한 최적 노드 결정
- 파드와 노드 연결(바인딩):
spec.nodeName설정 - (필요 시) 선점: 낮은 우선순위 파드(victim) 선택 및 종료 요청
또한, 당연히 스케줄링은 파드에 적용되는 개념이다. Deployment, StatefulSet 등과 같은 리소스 컨트롤러에 적용되는 개념이 아니라는 의미다.
스케줄러
kube-scheduler
스케줄링을 수행하는 컴포넌트가 kube-scheduler다. 컨트롤 플레인에서 실행되며, 배포 방식은 클러스터 프로비저닝 도구에 따라 다르다. 어떤 방식이든 스케줄러의 동작 원리는 동일하다.
| 배포 방식 | 대표 도구 | 설명 |
|---|---|---|
| Static Pod | kubeadm, kubespray, RKE2 | kubelet이 Static Pod 매니페스트를 읽어 실행(kubeadm·kubespray: /etc/kubernetes/manifests/, RKE2: /var/lib/rancher/rke2/agent/pod-manifests/). 가장 일반적인 방식 |
| systemd 서비스 | Kubernetes The Hard Way | kube-scheduler 바이너리를 직접 실행하여 systemd unit으로 등록. 컨트롤 플레인에 kubelet이 필요 없음 |
| 프로세스 내장 | K3s | 단일 바이너리(k3s server)에 스케줄러가 포함되어 별도 프로세스 없이 동작 |
kubeadm 기반 클러스터에서는 Static Pod으로 실행되므로, kube-system 네임스페이스에서 파드로 확인할 수 있다.
kubectl get pods -n kube-system -l component=kube-scheduler
NAME                           READY   STATUS    RESTARTS   AGE
kube-scheduler-control-plane   1/1     Running   0          3d
반면 systemd 서비스로 구동하는 환경(예: Kubernetes The Hard Way)에서는 컨트롤 플레인 노드에 kubelet 자체가 없으므로, 스케줄러가 파드 목록에 나타나지 않는다. 대신 systemctl status kube-scheduler로 상태를 확인한다.
스케줄러 교체와 다중 스케줄러
kube-scheduler는 기본 스케줄러(default-scheduler)이지만, 반드시 이것만 사용해야 하는 것은 아니다. 쿠버네티스는 다음을 지원한다.
- 기본 스케줄러 교체:
kube-scheduler의 설정 파일(KubeSchedulerConfiguration— 구조는 아래 설정 계층 구조, 문법은 4편 - KubeSchedulerConfiguration에서 후술)을 수정하여 플러그인(2편 - 기본 플러그인과 Extension Point 매핑에서 후술)을 활성화/비활성화하거나, 커스텀 빌드 kube-scheduler나 별도 구현 스케줄러로 교체할 수 있다. 기본 바이너리에 없는 플러그인을 쓰려면 바이너리를 다시 빌드해야 한다(아래 플러그인 절). - 다중 스케줄러 운영: 기본 스케줄러와 두 번째 스케줄러를 동시에 실행할 수 있다. 각 스케줄러는 고유한 이름을 가지며, 파드는
spec.schedulerName필드로 어떤 스케줄러를 사용할지 지정한다.
schedulerName 지정
apiVersion: v1
kind: Pod
metadata:
  name: my-pod
spec:
  schedulerName: my-custom-scheduler  # 기본값: default-scheduler
  containers:
  - name: nginx
    image: nginx
spec.schedulerName을 지정하지 않으면 기본값인 default-scheduler가 사용된다. 이 기본값은 kube-apiserver가 파드 생성 시 자동으로 설정해 준다. 다중 스케줄러 환경에서 반드시 schedulerName을 명시해야 하는 것은 아니지만, 명시하지 않으면 API Server가 default-scheduler를 채우고, 그 값을 바꾸는 mutating webhook이 없는 한 default-scheduler가 해당 파드를 처리한다. 예를 들어 YuniKorn의 admission controller는 기본 설정에서 kube-system 밖의 파드를 yunikorn으로 바꾼다. 두 번째 스케줄러로 처리하고 싶은 파드에만 schedulerName을 명시하면 된다.
지정된 이름의 스케줄러가 클러스터에 없으면, 해당 파드는 아무도 스케줄링하지 않으므로 Pending 상태에 영구히 남게 된다. 시스템 파드까지 이 상황에 빠지는 경우는 아래 default-scheduler 부재 시나리오에서 다룬다.
이 동작은 뒤에서 다룰 Binding 오브젝트를 쓸 때도 그대로 활용된다. 존재하지 않는 스케줄러 이름을 지정해 두면 default-scheduler가 그 파드를 스케줄링 큐에 넣지 않으므로, 파드가 Pending으로 남아 있는 동안 여유롭게 Binding을 생성할 수 있다.
파드와 스케줄러의 매칭: 경쟁은 없다
하나의 파드를 놓고 여러 스케줄러가 “경쟁”하는 상황은 설계상 발생하지 않는다. 각 스케줄러는 spec.schedulerName이 자신의 이름과 일치하는 파드만 스케줄링 큐에 넣어 처리한다. 파드 자체는 전부 watch한다. kube-scheduler는 이미 노드가 정해진 파드를 schedulerName과 무관하게 캐시에 넣어 노드 자원 계산에 쓴다. 즉, schedulerName: default-scheduler인 파드는 기본 스케줄러만, schedulerName: my-custom-scheduler인 파드는 그 이름의 두 번째 스케줄러만 처리한다. 랜덤으로 스케줄러가 파드를 가져가는 것이 아니라, schedulerName 필드에 의해 1:1로 매칭되는 구조다.
단, 서로 다른 스케줄러 프로세스가 같은 schedulerName을 쓰는 것을 쿠버네티스가 막아 주지는 않는다. 이 경우에는 두 스케줄러가 같은 파드를 처리하려 시도한다(아래 schedulerName 고유성 메커니즘).
그리고 서로 다른 스케줄러가 처리한 파드들이 같은 노드의 리소스를 놓고 충돌하는 문제는 발생할 수 있다. 각 스케줄러가 독립적으로 리소스 상태를 계산하기 때문에, 스케줄러 A가 노드의 잔여 리소스를 보고 파드를 배치하는 사이에 스케줄러 B가 같은 노드에 다른 파드를 배치하면 스케줄링 결정이 노드의 리소스를 과할당하게 된다. API Server는 이를 막지 않고, 늦게 도착한 파드를 노드의 kubelet이 실행 거부한다. 선점이 얽히면 루프가 생길 수도 있다. 스케줄러 A가 스케줄러 B의 낮은 우선순위 파드를 선점하면, B의 컨트롤러가 해당 파드를 재생성하고, B가 다시 같은 노드에 스케줄링하고, A가 다시 선점하는 반복이 가능하다.
이 때문에 다중 스케줄러를 운영할 때는 노드 풀을 분리하거나, 스케줄러 간 리소스 경쟁이 없도록 설계하는 것이 일반적이다. 충돌이 구체적으로 어떤 메커니즘으로 발생하는지와 운영 권고는 아래 자원 뷰 충돌에서 다룬다. 자원 뷰 충돌은 프로필과 스케줄러 프로세스의 차이를 전제로 하므로 kube-scheduler 구조 절에 있다.
스케줄링 대상
스케줄러는 정확히 어떤 파드를 스케줄링 대상으로 인식하는가.
판단 기준: spec.nodeName
스케줄러의 판단 기준은 단 하나, spec.nodeName이 비어 있는지 여부다. 이 필드가 비어 있으면 스케줄링 대상이고, 값이 설정되어 있으면 스케줄러는 해당 파드를 무시한다.
apiVersion: v1
kind: Pod
metadata:
  name: my-pod
spec:
  nodeName: "" # 비어 있음 → 스케줄링 대상
status:
  phase: Pending
  conditions:
  - type: PodScheduled
    status: "False"
    reason: Unschedulable
    message: "0/10 nodes are available: 1 Insufficient nvidia.com/gpu, 9 node(s) didn't match Pod's node affinity/selector."
message는 스케줄링이 실패한 이유를 노드 수로 집계한 문자열이다. 읽는 방법은 다음과 같다.
0/10: 앞의 0은 고정값이다. 이 메시지는 적합 노드가 하나도 없을 때만 만들어진다. 뒤의 10은 스케줄러가 보고 있는 클러스터 전체 노드 수다. PreFilter에서 거절되면 노드별 집계 대신 PreFilter 메시지만 붙는다1 Insufficient nvidia.com/gpu: 그 이유로 탈락한 노드 수가 1개. 탈락 사유는 Filter 플러그인이 반환한 것이다- 사유가 여럿이면 쉼표로 이어 붙는다. 위 예시는 1개 노드가 GPU 부족으로, 9개 노드가 nodeSelector 불일치로 탈락한 상황이다
각 사유가 어떤 플러그인에서 나오는지와, 이 메시지로 실패 단계를 좁히는 절차는 6편 - Events 메시지 읽기에서 다룬다.
이 기준에 따라, Pending 상태의 파드들을 스케줄링 관점에서 세 가지로 분류할 수 있다.
| 분류 | spec.nodeName |
스케줄러 관여 | 위치 |
|---|---|---|---|
| 스케줄링 대상 | 비어 있음 | O | Active / Backoff / Unschedulable Queue |
| 수동 지정 | 수동 설정됨 | X | 큐에 없음 |
| 스케줄링 완료 | 스케줄러가 설정함 | 완료 | 큐에 없음 (컨테이너 시작 대기 중) |
스케줄러는 스케줄링 대상 파드를 세 개의 큐(Active / Backoff / Unschedulable)로 관리한다. 큐의 역할과 이동 규칙은 2편 - 스케줄러 큐에서 다룬다. 첫 번째 분류의 파드가 세 큐 중 어디에 있는지는 API로 직접 노출되지 않는다. Events와 메트릭으로 추정하는 방법은 6편 - 파드가 어느 큐에 있는지 판별에서 다룬다.
분류별 YAML 예시
1. 스케줄링 대상 — spec.nodeName이 비어 있음
spec:
  nodeName: ""  # 비어 있음 → 스케줄링 대상
status:
  phase: Pending
  conditions:
  - type: PodScheduled
    status: "False"
- 스케줄러가 감지하고 스케줄링을 시도하는 파드
- 스케줄링 큐(Active Queue, Backoff Queue, Unschedulable Queue)에 포함됨
2. 스케줄링 비대상 — spec.nodeName이 수동 지정됨
spec:
  nodeName: "worker-1"  # 수동 지정됨 → 스케줄러 개입하지 않음
status:
  phase: Pending  # 아직 Pending이지만 스케줄러가 처리하지 않음
  conditions:
  - type: PodScheduled
    status: "True"  # 스케줄러가 아니라 kubelet이 파드 상태를 보고하며 기록
- 수동으로 노드가 지정된 파드. 스케줄러가 관여하지 않음
- Pending 상태일 수 있지만(예: 이미지 pull 중, 컨테이너 시작 대기 중), 스케줄링과는 무관
3. 스케줄링 완료 — spec.nodeName이 스케줄러에 의해 설정됨
spec:
  nodeName: "worker-1"  # 스케줄러가 설정함
status:
  phase: Pending  # 컨테이너 시작 전까지는 여전히 Pending
  conditions:
  - type: PodScheduled
    status: "True"  # 스케줄링 완료
- 스케줄러가 이미 노드를 할당한 파드
- 컨테이너가 시작되기 전까지는 Pending 상태를 유지할 수 있음
판단 기준이 아닌 것
spec.nodeName 외에 스케줄링과 관련 있어 보이는 필드가 두 가지 더 있다. status.phase: Pending과 status.conditions[PodScheduled]다. 둘 다 스케줄러의 판단 기준이 아니다.
status.phase: Pending
Pending은 파드의 광범위한 상태를 나타낸다. 파드가 Pending이 되는 원인은 스케줄링 대기 외에도 다양하다.
- 스케줄링 완료 후 이미지 pull 중
- init container 실행 대기 중
- 스케줄링 완료 후 컨테이너 시작 대기 중
즉, Pending 상태라고 해서 반드시 스케줄링 문제인 것은 아니다. spec.nodeName이 이미 설정된 파드도 컨테이너가 시작되기 전까지는 Pending 상태를 유지한다. 파드가 Pending 상태에 빠졌을 때, 먼저 spec.nodeName이 비어 있는지 확인하여 스케줄링 문제인지 아닌지를 구분하는 것이 진단의 첫 단계다.
status.conditions: PodScheduled
status.conditions의 PodScheduled는 스케줄링 결과를 기록하는 지표다. 스케줄러가 이 값을 읽어서 판단하는 것이 아니라, 스케줄링 시도의 결과로 기록된다. 기록하는 주체가 경우마다 다르다.
동작 흐름은 파드가 스케줄러를 거치는지에 따라 두 경로로 나뉜다.
스케줄러를 거치는 파드
- 파드 생성(
nodeName비어 있음) →conditions는 아직 비어 있음 - 스케줄러가
nodeName이 비어 있는 파드를 감지하고 스케줄링 시도- 성공 시 → Binding 처리 과정에서 API Server가
PodScheduled: True를 기록 - 실패 시 → 스케줄러가 직접
PodScheduled: False(reason: Unschedulable, 실패 사유message)를 patch
- 성공 시 → Binding 처리 과정에서 API Server가
spec.nodeName을 직접 지정한 파드
- 스케줄러도 Binding도 거치지 않으므로, 해당 노드의 kubelet이 파드 상태를 보고하면서
PodScheduled: True를 기록한다. 그래서 수동 지정 파드와 스케줄러가 배치한 파드는 이 조건으로는 구분되지 않고, 스케줄러가 남기는Scheduled이벤트의 유무로 구분된다
즉, 위 예시 YAML에서 본 reason과 message는 스케줄러가 남긴 것이고, True 조건은 API Server(Binding)나 kubelet(수동 지정)이 남긴 것이다.
정리하면, spec.nodeName이 원인(입력)이고, Pending과 PodScheduled는 결과(출력)다. 스케줄러는 오직 spec.nodeName만 보고 스케줄링 대상 여부를 결정한다.
수동 스케줄링
스케줄러를 거치지 않고 파드를 특정 노드에 직접 배치하는 방법이다. 테스트, 디버깅, 또는 DaemonSet과 같이 스케줄러 개입 없이 노드에 파드를 배치해야 하는 상황에서 사용한다.
파드 생성 시 spec.nodeName 지정
가장 단순한 방법은 파드 생성 시 spec.nodeName을 직접 지정하는 것이다.
apiVersion: v1
kind: Pod
metadata:
  name: manual-pod
spec:
  nodeName: worker-1  # 스케줄러를 거치지 않고 worker-1에 직접 배치
  containers:
  - name: nginx
    image: nginx
이 경우 스케줄러는 해당 파드를 완전히 무시한다. spec.nodeName이 이미 설정되어 있으므로 스케줄링 대상이 아니다. kubelet이 자신의 노드에 할당된 파드를 감지하고 직접 실행한다.
다만, 스케줄러를 거치지 않으므로 Filter 단계가 실행되지 않는다. 존재하지 않는 노드명을 지정하면 그 파드를 실행할 kubelet이 없어 Pending에 머물다가, kube-controller-manager의 PodGC가 없는 노드에 바인딩된 파드(orphan)로 판단해 약 40초 유예한 뒤 Failed로 표시하고 삭제한다.
스케줄러의 Filter를 건너뛴다고 해서 아무 검증도 없는 것은 아니다. kubelet은 자신의 노드에 배정된 파드를 실행하기 전에 admission 검사를 수행하며, 여기서 리소스 충분 여부와 nodeSelector, NoExecute taint 등은 다시 판정한다. 그러나 배치 정책에 해당하는 것 — cordon, NoSchedule taint, 파드 간 affinity, 토폴로지 분산 — 은 스케줄러도 kubelet도 검사하지 않는다.
그래서 cordon된 노드에 spec.nodeName을 직접 지정하면 파드가 그대로 뜬다. cordon이 Filter 단계에서만 평가되고 kubelet은 NoSchedule taint를 보지 않기 때문이다(구조는 3편 - cordon의 기술적 의미). 버그가 아니라 설계된 경로이고, GPU 장애 노드를 cordon해 둔 채 검증용 probe만 밀어 넣는 식으로 활용할 여지도 있다.
kubelet이 다시 검사하는 항목과 하지 않는 항목의 전체 대조, cordon 우회의 주의점은 6편 - 수동 배치의 제약에서 다룬다.
이미 생성된 파드에 대한 수동 스케줄링: Binding 오브젝트
spec.nodeName은 파드가 생성된 이후에는 직접 수정할 수 없다. API Server가 이 필드의 업데이트를 거부하기 때문이다.
# 이미 생성된 파드의 nodeName을 변경하려고 하면 실패한다
kubectl patch pod my-pod -p '{"spec":{"nodeName":"worker-1"}}'
# The Pod "my-pod" is invalid: spec: Forbidden: pod updates may not change fields other than ...
이미 생성되어 spec.nodeName이 비어 있는 파드를 수동으로 노드에 배치하려면, Binding 오브젝트를 생성해야 한다. 이것은 실제로 스케줄러가 내부적으로 파드를 노드에 바인딩할 때 사용하는 것과 동일한 메커니즘이다.
# Binding 오브젝트를 API Server에 POST
curl -X POST http://<API_SERVER>/api/v1/namespaces/default/pods/my-pod/binding \
  -H "Content-Type: application/json" \
  -d '{
    "apiVersion": "v1",
    "kind": "Binding",
    "metadata": {
      "name": "my-pod"
    },
    "target": {
      "apiVersion": "v1",
      "kind": "Node",
      "name": "worker-1"
    }
  }'
Binding 오브젝트가 생성되면 API Server가 해당 파드의 spec.nodeName을 worker-1으로 설정하고 PodScheduled: True 조건을 기록하며, 해당 노드의 kubelet이 파드를 실행한다. spec.nodeName 직접 지정과 마찬가지로 스케줄러의 Filter는 실행되지 않고, kubelet의 admission 검사만 적용된다.
Binding 오브젝트의 핵심 특성은 다음과 같다.
- 1회성: 하나의 파드에 대해 한 번만 성공한다. 이미
spec.nodeName이 설정된 파드에 다시 Binding을 생성하면 실패한다. - 스케줄러 내부 동작과 동일: 스케줄러가 노드를 선택한 후 Bind 단계에서 수행하는 작업이 바로 이 Binding 오브젝트 생성이다. 수동 스케줄링은 스케줄러의 Filter/Score 단계를 건너뛰고 Bind 단계만 직접 실행하는 것과 같다.
kubectl에 전용 서브커맨드가 없다:kubectl bind같은 명령은 없다.kind: Binding매니페스트를kubectl create -f로 POST하거나, 위와 같이 API Server에 직접 요청을 보낸다.kubectl patch로spec.nodeName을 고치는 방식은 앞에서 본 것처럼 거부된다.
이 1회성이라는 성질에는 중요한 따름정리가 있다. 스케줄링이 완료된 파드의 배치는 바꿀 수 없다. 쿠버네티스에는 실행 중인 파드를 다른 노드로 옮기는 마이그레이션 기능이 없으므로, 배치를 바꾸려면 삭제 후 재생성이 유일한 경로다. 선점과 축출도 이 원칙의 예외가 아니다 — victim의 nodeName을 고치는 것이 아니라 삭제하고, 컨트롤러가 만든 새 파드가 스케줄링을 처음부터 다시 받는다.
Binding이 거부되는 세 가지 조건, 스케줄러와 경쟁하지 않고 Binding을 쓰는 방법, 변경 가능한 spec 필드 목록은 6편 - 수동 배치의 제약에서 다룬다.
수동 스케줄링 방식 비교
| 방식 | 시점 | 방법 | Filter 실행 | 비고 |
|---|---|---|---|---|
spec.nodeName 직접 지정 |
파드 생성 시 | YAML에 nodeName 명시 |
안 함 | 가장 단순. 존재하지 않는 노드를 지정하면 Pending으로 남다가 PodGC가 삭제 |
| Binding 오브젝트 | 파드 생성 후 | Binding 오브젝트 POST | 안 함 | 스케줄러 내부 동작과 동일한 메커니즘. 생성할 때 존재하지 않는 schedulerName을 지정해 두면(생성 후에는 바꿀 수 없다) 경쟁 없이 사용 가능 |
두 방식 모두 스케줄러를 우회하므로, cordon 여부와 NoSchedule taint, 배치 규칙은 사전에 직접 확인해야 한다.
사례: DaemonSet의 수동 → 스케줄러 위임 전환
DaemonSet은 클러스터의 모든(또는 특정) 노드에 파드를 하나씩 배치하는 워크로드 리소스로, 수동 스케줄링이 실제로 활용되었던 대표 사례이자 거기서 벗어나 kube-scheduler에 위임하게 된 전환의 대표 케이스다. DaemonSet의 스케줄링 방식은 Kubernetes 버전에 따라 크게 변화했다.
과거 (v1.12 이전): DaemonSet Controller가 직접 배치
ScheduleDaemonSetPods는 DaemonSet 파드의 스케줄링을 DaemonSet Controller가 아닌 kube-scheduler에 위임하도록 전환하는 Feature Gate다. 전환 이력은 다음과 같다.
| 버전 | 상태 |
|---|---|
| v1.11 | alpha (기본 비활성화) |
| v1.12 | beta (기본 활성화) — 이 시점부터 기본 동작이 스케줄러 위임으로 바뀐다 |
| v1.17 | GA (항상 활성화, 비활성화 불가) |
| v1.18 | 게이트 자체 제거 |
기본 활성화 시점이 v1.12이므로, 실제 동작이 전환된 것은 v1.12다. v1.12부터 v1.16까지는 게이트를 명시적으로 꺼서 과거 동작으로 되돌릴 수 있었고, v1.17 GA부터는 그것도 불가능해졌다.
이 기능이 도입되기 전, DaemonSet Controller는 파드를 생성하면서 직접 spec.nodeName을 설정해 노드에 배치했다. 앞에서 살펴본 두 가지 수동 스케줄링 방식 중 첫 번째(spec.nodeName 직접 지정)와 동일한 메커니즘이다.
- DaemonSet Controller가 각 노드에 대해 파드를 생성하면서
spec.nodeName을 직접 지정 kube-scheduler를 거치지 않으므로 taint/toleration, affinity 등 스케줄러의 필터 검증이 적용되지 않음- DaemonSet Controller가 자체적으로 taint/toleration 등을 확인해야 했는데, 이로 인해 스케줄러와 DaemonSet Controller의 로직이 중복되고, 동작이 불일치하는 문제가 있었음
현재 (v1.12 기본 활성화, v1.17 GA): kube-scheduler에 위임
ScheduleDaemonSetPods가 활성화되면서, DaemonSet Controller는 spec.nodeName을 직접 설정하지 않는다. 대신 파드의 spec.affinity.nodeAffinity에 matchFields로 특정 노드를 지정하여 kube-scheduler에 위임한다. 그 결과 DaemonSet 파드도 스케줄러의 모든 필터 검증(taint/toleration, 리소스 확인 등)을 거치게 되었고, 스케줄러와 DaemonSet Controller 사이의 로직 불일치 문제가 해소되었다.
이 경로는 스케줄러 내부에서 추가 최적화를 받는다. NodeAffinity 플러그인은 matchFields로 노드 이름이 고정된 경우 PreFilter 단계에서 해당 노드만 후보로 반환하므로, 전체 노드를 순회하지 않는다(6편 - Extension Point 결정권 분류).
NodeAffinity와 matchFields의 구체적인 YAML과 동작은 3편 - 사례: DaemonSet의 NodeAffinity 위임에서 다룬다.
kube-scheduler 구조
앞에서 본 스케줄러 지정(spec.schedulerName)과 바인딩(Binding)은 쿠버네티스 위의 모든 스케줄러가 따르는 규칙이다. 여기서부터는 그중 기본 스케줄러인 kube-scheduler의 내부 구조를 본다. 결론부터 말하면, kube-scheduler는 Scheduling Framework라는 고정된 처리 순서 위에서, 바이너리에 컴파일된 플러그인 가운데 프로필(Profile)이 고른 것을 실행하는 프로세스다. 용어의 관계는 다음과 같다. 표기는 0편 - 용어 정리를 따른다.
| 용어 | 정의 | 바꾸는 방법 |
|---|---|---|
kube-scheduler |
쿠버네티스 업스트림이 배포하는 기본 스케줄러 바이너리. in-tree 플러그인만 들어 있다 | 이미지·바이너리 교체 |
| Scheduling Framework | kube-scheduler 코드 안의 플러그인 아키텍처. 파드 하나를 배치하는 extension point(확장 지점)의 종류와 순서를 정한다 |
kube-scheduler 소스 자체를 바꿔야 한다 |
| 플러그인 | extension point에서 실제 판단을 하는 Go 코드. 바이너리를 빌드할 때 함께 컴파일된다 | 플러그인 코드를 넣어 바이너리를 다시 빌드 |
| 프로필 | 바이너리에 들어 있는 플러그인 중 무엇을 어느 extension point에서 켤지 정한 설정 묶음. schedulerName 하나에 프로필 하나가 대응한다 |
KubeSchedulerConfiguration 수정 후 재시작 |
| 커스텀 빌드 kube-scheduler | kube-scheduler 코드에 out-of-tree 플러그인을 추가 등록해 다시 빌드한 바이너리 |
아래 플러그인 절 |
커스텀 빌드 kube-scheduler와 kube-scheduler의 관계
Coscheduling 같은 플러그인을 넣은 스케줄러를 무엇이라고 불러야 하는지가 헷갈리기 쉽다. 결론부터 말하면, 코드와 구조로 보면 kube-scheduler이고, 바이너리로 보면 kube-scheduler가 아니다.
- 같은 점:
kube-scheduler의 코드를 라이브러리로 가져와 만들므로 Scheduling Framework, extension point 순서, 프로필 문법(KubeSchedulerConfiguration)이 모두 같다. 그래서 1~4편과 6편에서 다루는 동작은 커스텀 빌드 kube-scheduler에도 그대로 적용된다 - 다른 점: 업스트림이 배포하는 바이너리가 아니라 별도로 빌드한 이미지이고, 레지스트리에 out-of-tree 플러그인이 더 들어 있다. 기본 스케줄러를 교체하지 않는 한 두 번째 스케줄러로 따로 띄워야 한다
그래서 이 시리즈는 둘을 구분해 부른다. 백틱으로 쓴 kube-scheduler는 업스트림 기본 바이너리만 가리키고, out-of-tree 플러그인을 넣어 다시 빌드한 것은 커스텀 빌드 kube-scheduler라고 부른다. 둘을 함께 가리킬 때는 kube-scheduler 계열이라고 쓴다. 플러그인은 실행 중인 스케줄러에 설치하는 것이 아니라 빌드할 때 넣는 것이므로, “플러그인을 설치한다”는 표현도 쓰지 않는다(레지스트리와 프로필).
이 구조는 kube-scheduler 계열에만 해당한다. Volcano 같은 별도 구현 스케줄러는 쿠버네티스 위에서 같은 규칙(schedulerName, Binding)을 따르지만 내부 구조는 별개다. 구현체별 내부 구조의 차이는 0편 - 확장 구조에서 정리했다.
Scheduling Framework
Scheduling Framework는 kube-scheduler가 파드 하나를 배치하는 과정을 정해진 extension point의 순서로 고정해 두고, 각 지점의 실제 판단은 플러그인이 채우도록 만든 플러그인 아키텍처다. 파드 하나에 대해 어떤 순서로 어떤 판단을 호출하는지는 Scheduling Framework가 정하고, 각 질문에 어떻게 답할지는 플러그인과 프로필이 정한다.
| Scheduling Framework가 정하는 것 | 플러그인이 정하는 것 |
|---|---|
| extension point의 종류와 호출 순서 | Filter의 통과 조건, Score의 점수 계산 |
| Scheduling Cycle과 Binding Cycle의 분리 | Permit에서 승인할지, 기다리게 할지 |
extension point 사이의 상태 공유(CycleState) |
어떤 클러스터 이벤트에서 재시도할지(QueueingHint) |
| 실패 시 Unreserve로 예약을 되돌리는 흐름 | Bind를 어떤 방식으로 수행할지 |
Scheduling Framework는 KEP-624로 도입되었다. 그 이전의 확장 방식(Scheduling Policies, Scheduler Extender)과의 차이는 아래 Scheduling Framework 아키텍처에서 다룬다.
알아 둘 점이 하나 있다. v1.32 기준 extension point는 모두 파드 하나를 대상으로 호출된다. 큐에서 파드 하나를 꺼내 노드 하나를 고르고 바인딩 하나를 수행한 뒤 다음 파드로 넘어가는 처리 방식(0편 - 사이클 모델)이 코드 구조로 고정되어 있는 것이다. 그래서 “이 파드 그룹 전체가 동시에 들어갈 수 있는가”를 판단할 자리가 기본 구조에는 없다. 이 한계와 v1.36에서 추가된 그룹 단위 사이클은 5편에서 다룬다.
전체 구조: Scheduling Cycle과 Binding Cycle
하나의 파드를 스케줄링하는 과정은 Scheduling Cycle과 Binding Cycle, 두 단계로 나뉜다. 이 둘을 합쳐 하나의 Scheduling Context라고 한다.
- Scheduling Cycle: 파드에 적합한 노드를 선택하는 단계. 직렬로 실행된다(한 번에 하나의 파드만 처리).
- Binding Cycle: 선택된 노드에 파드를 실제로 바인딩하는 단계. 병렬로 실행될 수 있다.
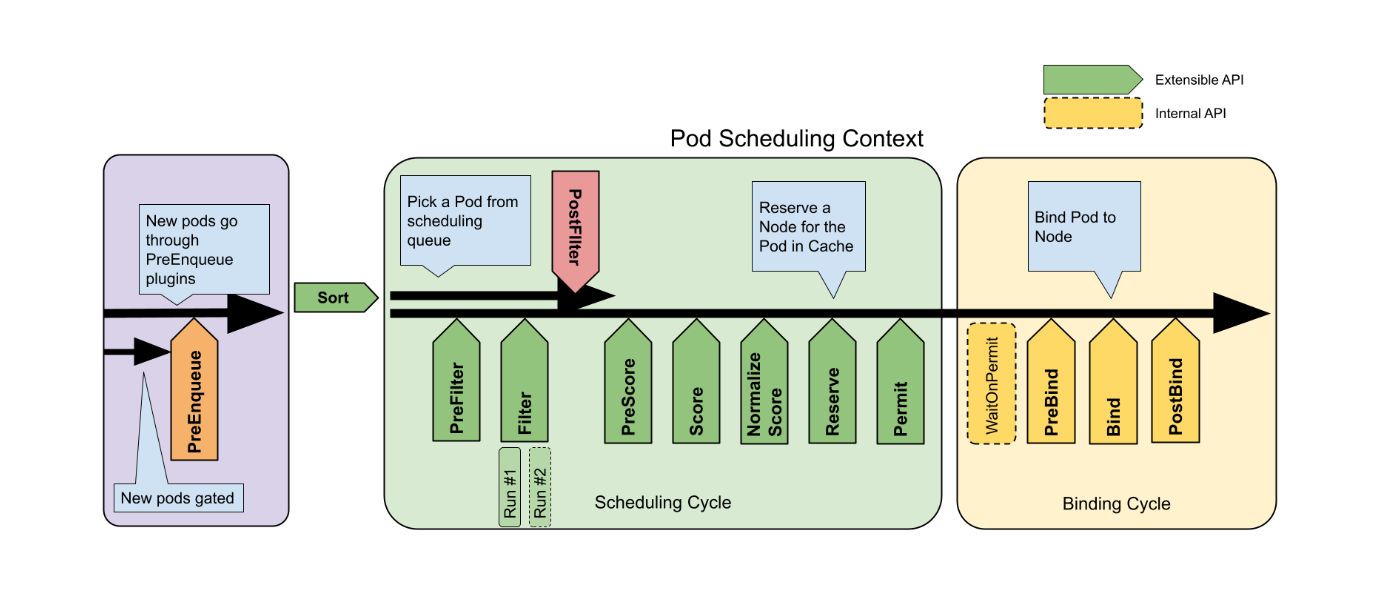
정상 경로의 extension point 순서는 다음과 같다.
[Scheduling Cycle]
PreEnqueue → QueueSort → PreFilter → Filter → PreScore → Score
           → NormalizeScore → Reserve → Permit
[Binding Cycle]
PreBind → Bind → PostBind
여기에 PostFilter는 포함되지 않는다. PostFilter는 PreFilter에서 파드가 거절되었거나 Filter에서 모든 노드가 탈락했을 때만 진입하는 실패 경로이므로, 정상적으로 배치되는 파드는 PostFilter를 거치지 않는다. 자세한 동작은 2편 - PostFilter에서 다룬다.
두 Cycle 모두, 파드가 스케줄링 불가능하다고 판단되거나 내부 오류가 발생하면 중단된다. 중단된 파드는 큐로 돌아가 재시도된다.
Scheduling Framework 아키텍처
Lightweight Core 설계 철학
Scheduling Framework의 핵심 설계 원칙은 코어를 가볍게 유지하는 것이다. 여기서 “가벼움”이란 바이너리 크기가 아니라, 코어가 담당하는 책임(로직)이 최소화되었다는 아키텍처 차원의 의미다.
- 코어(Scheduling Framework의 런타임): 스케줄링 사이클의 순서를 관리하는 오케스트레이터. QueueSort → PreFilter → Filter → … → PostBind까지 어떤 순서로 누구를 호출할지만 알고, 구체적인 판단 로직은 전혀 없다.
- 플러그인: 실제 판단 로직을 구현한다.
NodeResourcesFit,TaintToleration,NodeAffinity,InterPodAffinity,VolumeBinding등이 각자의 extension point에서 동작한다.
프레임워크 도입 이전에는 스케줄러 코어 코드 안에 모든 filtering, scoring 로직이 직접 들어가 있었다.
// 프레임워크 이전: 코어 코드에 모든 로직이 직접 구현
if !checkNodeResources(pod, node) { return false }
if !checkTaints(pod, node) { return false }
if !checkAffinity(pod, node) { return false }
// 새 기능 추가? → 코어 코드를 직접 수정해야 함
프레임워크 도입 이후, 코어는 등록된 플러그인을 순서대로 호출하는 루프만 돌린다.
// 프레임워크 이후: 코어는 플러그인 호출 루프만 담당
for _, plugin := range profile.FilterPlugins {
    status := plugin.Filter(ctx, state, pod, nodeInfo)
    if !status.IsSuccess() { return }
}
기능 하나를 추가하거나 수정할 때 코어 전체를 이해하고 건드릴 필요 없이, 해당 플러그인만 구현하면 된다.
In-Process Compilation
플러그인들은 Go 패키지로 구현되어 스케줄러 바이너리에 함께 컴파일된다. 런타임에 동적으로 로드하는 방식이 아니다. 이것은 의도적인 설계 결정이다. Go 언어 자체에는 plugin 패키지로 공유 객체(.so)를 런타임에 로드하는 방법이 있고, Volcano 스케줄러는 --plugins-dir 옵션으로 이 방식을 지원한다. kube-scheduler는 동적 로딩을 제공하지 않는다.
Scheduling Framework 이전부터 있던 확장 방식으로 Scheduler Extender가 있다. 스케줄러가 Filter·Score 등의 판단을 HTTP로 외부 프로세스에 물어보는 웹훅 방식이다. Extender는 지금도 KubeSchedulerConfiguration의 extenders 필드로 지원되지만, 다음과 같은 한계가 있다.
| 문제 | 설명 |
|---|---|
| HTTP 호출 오버헤드 | 노드 수천 개 × 파드 수천 개 filtering마다 네트워크 왕복이 발생해 스케줄링 지연이 커진다 |
| 에러 핸들링 복잡 | 외부 프로세스가 응답하지 않으면 그 extender를 거치는 파드의 스케줄링이 실패한다. ignorable: true로 두면 실패한 extender를 건너뛰지만, 그만큼 extender의 판단이 빠진 채 배치된다 |
| 상태 공유 불가 | PreFilter에서 계산한 결과를 Filter에서 재사용할 수 없음 |
이러한 문제를 해결하기 위해, 성능과 안전성을 위해 같은 프로세스에 넣되, 인터페이스로 관심사를 분리하여 코어를 가볍게 유지하는 전략을 선택했다. 같은 프로세스 안이므로 함수 호출로 플러그인을 실행하고, CycleState를 통해 extension point 간 상태를 공유할 수 있다.
CycleState는 하나의 스케줄링 사이클 동안만 유지되는 메모리 저장소다. 앞 단계에서 계산한 값을 키로 저장해 두면 뒤 단계에서 꺼내 쓸 수 있다. 어떤 플러그인이 무엇을 저장하는지는 6편 - PreScore 역할에서 다룬다.
Interface와 Extension Point
Scheduling Framework가 정의하는 Go 인터페이스와, 운영자가 KubeSchedulerConfiguration에서 조작할 수 있는 extension point는 1:1이 아니다.
Interface (Go 인터페이스, 플러그인이 구현할 수 있는 것)
├── 설정에 노출된 extension point (KubeSchedulerConfiguration의 plugins 필드)
│   └─ PreEnqueue, QueueSort, PreFilter, Filter, PostFilter, PreScore,
│      Score, Reserve, Permit, PreBind, Bind, PostBind
│
└── 설정에 노출되지 않은 인터페이스
    └─ ScoreExtensions(NormalizeScore), EnqueueExtensions(QueueingHint) 등
- 설정에 노출된 extension point:
KubeSchedulerConfiguration의plugins섹션에서 enable/disable/weight 조정이 가능하다. 클러스터 운영자와 플러그인 개발자 모두의 관심사다. v1 설정 타입 기준으로preEnqueue도 여기에 포함된다. v1.36부터는 PodGroup 스케줄링용placementGenerate·placementScore, v1.37부터는podGroupPostFilter가 추가되었다(5편) - 설정에 노출되지 않은 인터페이스: 프레임워크가 내부적으로 호출하며, YAML 설정으로 따로 조작할 수 없다. 플러그인 개발자만 관심을 가진다. NormalizeScore는 공식 문서에서 extension point로 소개되지만, 설정에
normalizeScore필드는 없다. Score 플러그인이ScoreExtensions()로 함께 제공하므로, Score에 등록하면 따라온다 - 프레임워크 내부 단계: Permit이 대기(wait)를 반환한 파드를 Binding Cycle 입구에서 기다리게 하는
WaitOnPermit은 플러그인이 구현하는 인터페이스가 아니라 프레임워크가 수행하는 단계다
앞 절에서 본 Extension Point 종류와 API 분류 그림은 실선 상자(Extensible API)와 점선 상자(Internal API)로 나뉜다. 실선 상자는 플러그인이 구현할 수 있는 extension point이고, 점선 상자는 프레임워크 내부 단계인 WaitOnPermit 하나다. 상자의 색은 단계 묶음(Scheduling Cycle, Binding Cycle, 실패 경로 등)을 구분한다. 그림의 Extensible API는 “플러그인이 구현할 수 있다”는 뜻이라, 위 트리의 설정 노출 여부와 정확히 일치하지는 않는다. 그림에는 v1.36 이후의 PodGroup용 extension point도 없다.
실무적으로는 interface ≈ extension point로 이해해도 크게 문제없다. 대부분의 인터페이스가 extension point이고 내부 전용인 것은 소수이기 때문이다. 다만 정확히는, extension point는 interface의 부분집합(= configurable한 것들)이다.
참고: Scheduling Policies (레거시)
현재의 Scheduling Framework 이전에는 Scheduling Policies라는 방식으로 스케줄러의 filtering과 scoring을 설정했다. Predicates(Filtering 단계의 boolean 평가식)와 Priorities(Scoring 단계의 점수 함수)를 정의하는 구조였다.
- Predicates: “이 노드에 이 파드를 놓을 수 있는가”에 대한
true/false판정. 예:PodFitsResources,MatchNodeSelector,NoTaintsTolerated - Priorities: feasible 노드(Filter를 통과해 배치가 가능한 노드)들에 0~10 점수를 매기고, 가중치를 곱하여 최고 점수 노드를 선택. 예:
LeastRequestedPriority,BalancedResourceAllocation,ImageLocalityPriority
이 방식은 v1.23에서 제거되었으며, 현재는 Scheduling Profiles + Scheduling Framework가 표준이다. 개념적으로 filtering/scoring 2단계는 동일하나, 단순한 predicate/priority 함수 목록이 아니라 plugin point 기반으로 세분화된 것이 핵심 차이다. 현재 Score 단계의 점수 범위는 0~10이 아니라 0~100이다.
플러그인
플러그인은 Scheduling Framework의 extension point 인터페이스(FilterPlugin, ScorePlugin 등)를 구현한 Go 코드다. 하나의 플러그인이 여러 인터페이스를 구현해 여러 extension point에 걸쳐 동작할 수 있다. v1.32 기본 플러그인과 extension point의 전체 매핑은 2편 - 기본 플러그인과 Extension Point 매핑에 있다.
레지스트리와 프로필
kube-scheduler는 기동할 때 바이너리에 들어 있는 플러그인의 이름과 생성 함수를 레지스트리(registry)에 올려 두고, 프로필에 적힌 플러그인 이름을 이 레지스트리에서 찾는다. 따라서 프로필은 레지스트리에 있는 플러그인만 고를 수 있다. 레지스트리에 없는 이름을 적은 설정 파일은 작성은 되지만, 스케줄러가 그 설정으로 기동하지 못한다.
// pkg/scheduler/framework/runtime/framework.go (v1.37.0)
// 프로필에 적힌 플러그인 이름이 레지스트리에 없으면 프레임워크 생성이 실패한다
// 예: 기본 kube-scheduler 설정에 Coscheduling을 적으면 `QueueSortPlugin "Coscheduling" does not exist`
return fmt.Errorf("%s %q does not exist", pluginType.Name(), ep.Name)
이 오류는 프로필 생성 실패(creating profile for scheduler name ...)로 감싸져 올라오고, 스케줄러 프로세스가 종료된다. 설정 오류로 기동에 실패했을 때 클러스터에서 벌어지는 일은 4편 - 설정 적용과 롤백에서 다룬다.
in-tree 플러그인과 out-of-tree 플러그인
결론부터 말하면, 둘의 차이는 기본 kube-scheduler 바이너리에 들어 있느냐이고, out-of-tree 플러그인을 쓰려면 스케줄러 바이너리를 다시 빌드해야 한다.
| 구분 | 위치 | 기본 kube-scheduler에 포함 |
예 |
|---|---|---|---|
| in-tree | kubernetes/kubernetes 저장소 |
포함 | NodeResourcesFit, TaintToleration, DefaultPreemption 등 |
| out-of-tree | 별도 저장소 | 미포함 | Coscheduling, CapacityScheduling, NodeResourceTopology, Trimaran 등 |
out-of-tree 플러그인을 쓰는 스케줄러는 kube-scheduler의 코드를 라이브러리로 가져와, 기본 레지스트리에 플러그인을 추가 등록한 새 바이너리로 만든다. 이것이 커스텀 빌드 kube-scheduler다.
// out-of-tree 플러그인을 추가 등록해 새 스케줄러 바이너리를 만드는 구조
// (scheduler-plugins 저장소의 스케줄러 진입점이 이 방식이다)
command := app.NewSchedulerCommand(
    app.WithPlugin(coscheduling.Name, coscheduling.New), // 기본 플러그인에 Coscheduling 추가 등록
    // ... 다른 out-of-tree 플러그인
)
이렇게 만든 커스텀 빌드 kube-scheduler도 내부 구조는 Scheduling Framework 그대로다. extension point의 종류와 순서는 같고, 레지스트리에 플러그인이 더 있을 뿐이다. 그래서 프로필 문법(KubeSchedulerConfiguration)도 그대로 쓴다. 별도 바이너리라는 점은 Volcano와 같지만, Volcano는 Scheduling Framework 자체를 쓰지 않는 별도 구현 스케줄러라는 점에서 다르다(다중 프로필과 다중 스케줄러).
위 표의 out-of-tree 예시는 kubernetes-sigs/scheduler-plugins에 있다. SIG Scheduling이 관리하는 저장소로, 코어에 넣기에는 이르거나 특정 워크로드에 한정된 플러그인을 모아 둔다. 플러그인을 포함해 빌드한 스케줄러 이미지, PodGroup 같은 CRD를 다루는 컨트롤러, Helm 차트를 함께 제공한다. Koordinator의 koord-scheduler처럼 같은 방식으로 자체 플러그인을 넣어 빌드한 스케줄러도 있다.
커스텀 빌드 kube-scheduler 배포 방식
커스텀 빌드 kube-scheduler를 쓰는 방법은 두 가지다. 기본 스케줄러 교체는 컨트롤 플레인에 접근할 수 있을 때만 가능하고, 그렇지 않으면 두 번째 스케줄러로 띄운다.
| 방식 | 방법 | 제약 |
|---|---|---|
| 두 번째 스케줄러로 함께 띄우기 | Deployment 등으로 별도 배포하고, 대상 파드에 spec.schedulerName을 지정한다 |
기본 스케줄러와 같은 노드를 쓰면 자원 뷰 충돌이 생길 수 있다. 리더 선출용 lease 이름(leaderElection.resourceName)을 기본값(kube-scheduler)과 다르게 두고 RBAC에서 그 이름을 허용해야 한다. 그대로 두면 기본 스케줄러와 리더 자리를 다퉈 한쪽 스케줄링이 멈춘다 |
| 기본 스케줄러 교체 | 컨트롤 플레인의 kube-scheduler 이미지와 설정을 커스텀 빌드 kube-scheduler로 바꾼다 |
관리형 컨트롤 플레인(EKS, GKE 등)은 스케줄러 설정에 접근할 수 없는 경우가 많다. 모든 프로필이 같은 queueSort를 써야 하므로(4편 - 다중 프로필의 제약), queueSort를 바꾸는 플러그인(Coscheduling 등)을 넣으면 default-scheduler 프로필의 큐 정렬도 함께 바뀐다. kubeadm 클러스터는 kubeadm upgrade 때 매니페스트를 다시 쓰므로, 이미지 교체를 kubeadm patches 등으로 유지해야 한다 |
두 방식 모두 버전 스큐 정책을 따른다. 커스텀 빌드 kube-scheduler는 kube-apiserver보다 새로우면 안 되고, 최대 한 마이너까지 낮을 수 있다. 그래서 컨트롤 플레인을 올릴 때마다 같은 마이너의 쿠버네티스 코드로 다시 빌드한 이미지로 바꿔야 한다. scheduler-plugins도 쿠버네티스 마이너 버전에 맞춰 릴리스를 낸다.
설정 계층 구조
스케줄러 설정을 이해하려면 먼저 스케줄러 프로세스, Configuration, 프로필 세 개념의 계층 관계를 잡아야 한다.
Scheduler 프로세스 (kube-scheduler 바이너리)
  └── Configuration (1개)
        ├── 글로벌 설정 (leaderElection, clientConnection, parallelism 등)
        └── Profiles[] (1개 이상)
              ├── Profile "default-scheduler"
              │     └── Extension Points
              │           ├── filter: [Plugin A, Plugin B, ...]
              │           ├── score: [Plugin C (weight:2), ...]
              │           └── ...
              └── Profile "gpu-scheduler"
                    └── Extension Points
                          ├── filter: [Plugin A, Plugin E, ...]
                          └── ...
| 개념 | 범위 | 뭘 설정하나 |
|---|---|---|
| Configuration | 스케줄러 프로세스 전체 | 글로벌 설정 + 프로필 목록 |
| 프로필 | 하나의 schedulerName 단위 |
어떤 extension point에 어떤 플러그인을 켜고/끄고/weight를 줄지 |
하나의 스케줄러 프로세스는 하나의 Configuration을 가지며, 그 안에 여러 프로필을 포함할 수 있다. 파드의 spec.schedulerName이 프로필의 schedulerName과 매칭되어, 같은 프로세스 안에서 서로 다른 플러그인 구성으로 스케줄링할 수 있다(다중 정책 구성 방식 참고). 프로필이 고를 수 있는 플러그인은 레지스트리에 등록된 것으로 한정된다. 이 Configuration 파일을 스케줄러에 전달하고 적용하는 방법은 4편 - 설정 전달 방법에서 다룬다.
다중 프로필과 다중 스케줄러
스케줄링 정책을 여러 개 두는 방법은 두 가지다. 같은 kube-scheduler 프로세스 안에 프로필을 늘리는 방법과, 스케줄러 프로세스 자체를 늘리는 방법이다. 결론부터 말하면, 기본 바이너리의 플러그인으로 충분하면 프로필을 늘리는 쪽이 자원 뷰 충돌이 없어 적절하다. 프로세스를 늘리는 것은 기본 바이너리에 없는 플러그인이 필요하거나, Scheduling Framework와 다른 구조의 스케줄러가 필요할 때다.
다중 정책 구성 방식
1. 다중 프로필: 단일 kube-scheduler 안에 프로필 여러 개
KubeSchedulerConfiguration에서 여러 프로필을 정의할 수 있다. 각 프로필은 고유한 schedulerName을 가지고, 서로 다른 플러그인 구성을 적용할 수 있다.
apiVersion: kubescheduler.config.k8s.io/v1
kind: KubeSchedulerConfiguration
profiles:
  - schedulerName: default-scheduler     # 기본 프로필
  - schedulerName: no-scoring-scheduler  # 같은 프로세스 안의 두 번째 프로필
하나의 프로세스에서 여러 프로필을 운영하므로 리소스 경쟁 문제가 적다. 프로필별로 플러그인을 켜고 끄는 문법과, 기본 플러그인을 전부 끈 뒤 순서를 재배치하는 * 패턴은 4편 - * 패턴: 전체 비활성화와 순서 재배치에서 다룬다. 프로필별로 바꿀 수 없는 설정도 있다(4편 - 다중 프로필의 제약).
2. 다중 스케줄러: 스케줄러 프로세스 여러 개
별도의 스케줄러 바이너리를 Deployment 등으로 배포한다. 커스텀 빌드 kube-scheduler(커스텀 빌드 kube-scheduler 배포 방식)나 별도 구현 스케줄러(Volcano, YuniKorn 등)가 이 방식에 해당한다. 같은 kube-scheduler 바이너리를 다른 설정으로 하나 더 띄우는 것도 여기에 속한다.
Kueue는 이 방식에 속하지 않는다. Kueue는 파드를 바인딩하지 않고, 스케줄러 앞단에서 워크로드를 들여보낼 시점을 정하는 워크로드 admission 컨트롤러다. 노드 배치는 뒤에 있는 스케줄러(대개 기본 스케줄러)가 한다. Topology Aware Scheduling(TAS)을 켜면 Kueue가 배치할 토폴로지 도메인까지 정해 nodeSelector로 넘기지만, 바인딩은 여전히 뒤의 스케줄러가 한다(5편 - Volcano vs Kueue).
프로필만으로 충분한 경우와 별도 바이너리가 필요한 경우의 판단 기준은 아래에서 다룬다.
다중 스케줄러 활용 사례
| 사례 | 설명 |
|---|---|
| GPU 워크로드 전용 스케줄러 | GPU 토폴로지를 인식하는 두 번째 스케줄러로 GPU 파드만 스케줄링. 프로필 분리로 해결되는 경우는 4편 - 워크로드 성격에 따른 프로필 분리 참고 |
| 배치 작업 스케줄러 | Volcano, YuniKorn 등 배치/ML 워크로드에 특화된 스케줄러. Kueue는 스케줄러가 아니라 기본 스케줄러 앞에 붙는 워크로드 admission 컨트롤러다 |
| gang scheduling | 파드 그룹을 한꺼번에 배치하는 플러그인(Coscheduling 등)을 넣은 커스텀 빌드 kube-scheduler. 5편 참고 |
| 테스트/실험 | 새 스케줄링 정책을 테스트하면서 기존 워크로드에는 영향을 주지 않음 |
| 스코어링 비활성화 | 특정 워크로드에 대해 Score 단계를 건너뛰어 스케줄링 속도를 높임 |
프로필과 별도 바이너리의 선택 기준
판단 기준은 두 가지다. 필요한 로직이 이미 바이너리에 있느냐, 그리고 그 로직이 파드 단위 사이클 안에 들어가느냐다.
"다른 플러그인 조합·가중치를 쓰고 싶다"
  → 프로필만 추가하면 됨 (바이너리 동일)

"기본 바이너리에 없는 플러그인이 필요하다" (예: Coscheduling)
  → 커스텀 빌드 kube-scheduler (Scheduling Framework는 그대로)

"파드 단위 사이클과 다른 구조가 필요하다" (예: 잡 단위로 묶어 한 번에 배치)
  → 별도 구현 스케줄러 (Volcano, YuniKorn: Scheduling Framework를 쓰지 않음)

"스케줄러는 그대로 두고, 들여보낼 시점만 제어하고 싶다"
  → 워크로드 admission 컨트롤러 (Kueue: 스케줄러를 수정하지 않고 큐 진입 시점을 제어)
프로필만으로 가능한 경우는 kube-scheduler 바이너리에 이미 컴파일되어 있는 플러그인들의 조합만 바꾸는 것이다.
# 프로필로 충분한 예: 기본 플러그인의 weight만 변경
profiles:
  - schedulerName: gpu-scheduler
    plugins:
      score:
        enabled:
          - name: NodeResourcesFit
            weight: 5    # GPU 노드는 bin-packing 강하게
같은 구성을 pluginConfig까지 포함해 쓴 예시는 4편 - 워크로드 성격에 따른 프로필 분리에 있다.
기본 플러그인으로 불가능한 기능은 다음과 같다.
| 기능 | kube-scheduler 기본 플러그인으로 가능? |
|---|---|
| Gang scheduling (파드 그룹이 동시에 자원 확보되어야 스케줄링) | v1.35 alpha부터 네이티브 지원 시작, v1.37 beta(기본 비활성) (5편 - 네이티브 Workload API) |
| Fair-share queue (팀별 자원 할당량 관리) | X |
| Job-level preemption (개별 파드가 아닌 Job 단위 preemption) | v1.32 기준 X. v1.36 alpha(KEP-5710), v1.37 beta(기본 비활성) |
| Borrowing/Lending (큐 간 자원 대여) | X |
이런 로직은 새로운 플러그인 코드를 Go로 작성해야 하고, 플러그인은 바이너리에 컴파일되어야 하므로 별도 빌드/배포가 필요하다. 2편의 PostFilter 절에서 본 out-of-tree 플러그인들도 같은 이유로 별도 바이너리가 필요하다. 다른 길도 있다. 큐 정책과 쿼터는 스케줄러 앞단의 워크로드 admission 컨트롤러(Kueue)가 맡을 수 있고, 그룹 단위 배치는 처음부터 잡 단위로 설계된 별도 구현 스케줄러(Volcano)가 맡을 수 있다. 문제별로 어느 레이어가 맡는지는 5편 - 문제별 도구에서 다룬다.
schedulerName 고유성 메커니즘
하나의 스케줄러 내부에서 프로필 간 schedulerName 중복은 스케줄러 시작 시 validation error로 강제 거부된다.
그러나 서로 다른 스케줄러 프로세스 간에는 이름 중복을 검증하는 중앙 메커니즘이 없다. 각 스케줄러가 독립적으로 API server를 watch하기 때문이다.
클러스터 전역의 schedulerName 공간:
├── "default-scheduler"  ← kube-scheduler가 소유
├── "volcano"            ← volcano-scheduler가 소유
├── "gpu-scheduler"      ← kube-scheduler의 두 번째 프로필
└── ...

규칙: 서로 다른 스케줄러 프로세스 간에 이름이 겹치지 않도록
      운영자가 관리해야 함 (K8s가 enforce하지 않음)
만약 두 스케줄러가 같은 schedulerName을 가지면, 둘 다 같은 Pod을 스케줄링하려고 시도한다. Binding은 하나만 성공한다. 먼저 바인딩한 쪽이 spec.nodeName을 채우고, 늦은 쪽의 Binding 요청은 이미 노드가 지정된 파드라는 이유로 409 Conflict로 거부된다(6편 - Binding이 거부되는 조건). 동작은 하지만 비효율적이고 결과를 예측하기 어렵다.
Volcano는 이를 의도적으로 피한다. 기본 schedulerName으로 volcano를 사용하고, VolcanoJob controller가 Pod을 생성할 때 spec.schedulerName: volcano를 자동으로 설정한다.
default-scheduler 부재 시나리오
default-scheduler라는 이름의 프로필이 클러스터에 없으면 어떻게 되나?
spec.schedulerName을 지정하지 않은 Pod은 kube-apiserver가 자동으로 default-scheduler로 설정한다(앞의 schedulerName 지정). 이 이름을 처리할 스케줄러가 없으면, 해당 파드는 아무도 pick up하지 않으므로 영구 Pending 상태가 된다.
| 시나리오 | 결과 |
|---|---|
kube-scheduler를 끄고 volcano만 운영 + 모든 파드에 schedulerName: volcano 명시 |
문제 없음 |
| kube-scheduler를 끄고 volcano만 운영 + 일부 파드가 schedulerName 미지정 | 해당 파드 영구 Pending |
| kube-scheduler를 끄고 volcano만 운영 + 시스템 파드 (coredns 등) | 시스템 파드도 Pending → 클러스터 기능 장애 |
kube-scheduler를 끄고 volcano의 --scheduler-name에 default-scheduler도 추가 |
미지정 파드도 Volcano가 처리한다. 다만 kube-scheduler를 다시 켜면 같은 이름을 두 프로세스가 처리하게 된다(검증 범위 밖) |
마지막 케이스는 영향 범위가 클러스터 전체로 넓어진다. coredns, kube-proxy 같은 시스템 컴포넌트도 기본적으로 schedulerName을 생략하기 때문에 default-scheduler를 기대한다. 이것이 실무에서 기본 스케줄러(kube-scheduler)를 완전히 끄는 구성이 드문 이유이며, 대부분 병행 운영하는 이유다.
자원 뷰 충돌
앞의 파드와 스케줄러의 매칭에서 다중 스케줄러 간 리소스 경쟁 문제를 언급했다. 구체적인 메커니즘은 다음과 같다.
| 비교 | 프로필 여러 개 (하나의 스케줄러 안) | 스케줄러 여러 개 |
|---|---|---|
| 프로세스 | 1개 | 2개 이상 |
| Configuration | 1개 | 각각 1개씩 |
| 바이너리 | 동일 (kube-scheduler) | 다를 수 있음 |
| 플러그인 | 같은 바이너리에 컴파일된 것만 사용 | 각 바이너리가 다른 플러그인 세트 가능 |
| 자원 뷰 | 하나의 프로세스라 일관된 상태 | 각자 독립적으로 API server를 watch → race condition 가능 |
스케줄러가 2개면 같은 노드에 동시에 파드를 배치하려다 충돌(자원 뷰 충돌, race condition)이 날 수 있다. 예를 들어 두 스케줄러가 모두 노드의 남은 GPU를 4개로 보고 각자 GPU 4개짜리 파드를 바인딩하면, 실제 GPU는 4개인데 8개를 배치하는 결정이 나온다.
이 충돌은 API Server에서 걸러지지 않는다. Binding 요청은 6편 - Binding이 거부되는 조건의 세 경우(이미 nodeName이 있음, 삭제 중, 게이트가 남음)만 거부하고, 노드의 남은 자원은 보지 않는다. 그래서 두 Binding이 모두 성공하고, 충돌은 노드의 kubelet admission에서 드러난다. 먼저 수락된 파드가 자원을 차지하고, 늦게 도착한 파드는 실행이 거부되어 Failed로 끝난다. 이렇게 걸러지는 것은 자원뿐이다. 파드 간 anti-affinity나 토폴로지 분산처럼 kubelet이 다시 보지 않는 규칙은 두 스케줄러가 서로의 배치를 모르면 깨진 채로 실행된다(수동 스케줄링과 같은 이유).
| 자원 종류 | kubelet이 거부할 때의 사유 |
|---|---|
| CPU·메모리 | OutOfcpu, OutOfmemory |
device plugin 자원 (nvidia.com/gpu 등) |
UnexpectedAdmissionError (device manager의 할당 단계에서 먼저 실패) |
Failed가 된 파드는 스케줄러가 다시 배치하지 않는다. Deployment나 Job 같은 컨트롤러가 관리하는 파드라면 컨트롤러가 새 파드를 만들고, 그 파드가 스케줄링을 처음부터 다시 받는다. 노드 자원이 실제로 과할당된 채 실행되지는 않지만, 스케줄링 결정 단계에서는 과할당이 일어나고(공식 문서 표현으로 overcommitting a node’s resources) 그 결과가 파드 실패와 재생성으로 나타난다.
충돌 가능 구간은 각 스케줄러가 “예약됨(assumed)”으로 잡아 둔 파드가 다른 스케줄러에게 보이지 않는 동안이다. Reserve로 자원을 잡은 파드는 Binding이 API Server에 반영되어 다른 스케줄러의 watch에 도착하기 전까지 그 스케줄러의 캐시 안에만 있다. Permit 단계에서 그룹이 모일 때까지 파드를 붙잡아 두는 gang 스케줄러는 이 구간이 길어지므로, 기본 스케줄러와 같은 노드를 쓸 때 충돌 가능성이 더 커진다(5편). 이 구조는 0편 - 동시성 모델에서 본 공유 상태 모델에 가깝되, 결정을 반영하는 Binding 단계에서 자원 충돌을 검사하지 않는 형태다.
실무 권장
아래는 앞의 구조에서 도출한 방향이고, 실제 클러스터에서 구성별로 비교 검증한 결과는 아니다.
- 가능하면 하나의 스케줄러 + 여러 프로필로 두는 편이 적절하다. 하나의 프로세스 안에서 일관된 자원 뷰를 가지므로 race condition이 없다.
- 기본 플러그인에 없는 로직이 필요할 때만 두 번째 스케줄러를 추가하는 편이 적절하다 (커스텀 빌드 kube-scheduler, Volcano 등). 이때는 노드 풀을 taint·nodeSelector로 분리해 스케줄러끼리 같은 노드를 나눠 쓰지 않게 하는 편이 적절하다. 다만 DaemonSet 파드와 모든 taint를 tolerate하는 파드는 기본 스케줄러가 계속 그 풀에 배치하므로, GPU 같은 확장 자원의 충돌은 피해도 CPU·메모리 충돌 가능성은 남는다.
- Kueue(워크로드 admission 컨트롤러)는 아예 스케줄러를 추가하지 않고, 기본 스케줄러 앞에서 진입 시점만 제어한다. 뒤의 스케줄러가 기본 스케줄러 하나라면 race condition 문제를 설계 단계에서 회피한다.
정리
이 글에서 다룬 핵심 내용을 정리한다.
- 스케줄링은 배치 작업이다. 파드 생성, 파드 실행, 리소스 할당은 스케줄링이 아니다. 스케줄러는 노드가 결정되지 않은 파드를 감지하여, 스케줄링 요구 사항에 맞는 노드를 필터링하고 스코어링하여 “어느 노드에서 실행할지”를 결정한다.
kube-scheduler는 교체 가능하고 다중 운영이 가능하다. 단일kube-scheduler에 프로필을 늘리거나(다중 프로필), 두 번째 스케줄러 프로세스를 배포할 수 있다(다중 스케줄러). 각 스케줄러는spec.schedulerName이 자신의 이름과 일치하는 파드만 처리하므로, 이름이 겹치지 않는 한 하나의 파드를 두고 여러 스케줄러가 경쟁하는 일은 없다.- 스케줄러의 판단 기준은
spec.nodeName이다.status.phase: Pending이나PodScheduled조건이 아니다.spec.nodeName이 비어 있는 파드만 스케줄링 대상이 된다. - 수동 스케줄링은 두 가지 방법이 있다. 파드 생성 시
spec.nodeName을 직접 지정하거나, 이미 생성된 파드에 Binding 오브젝트를 생성한다. 두 방식 모두 스케줄러의 Filter를 건너뛰지만, kubelet이 리소스·nodeSelector·NoExecutetaint는 다시 검사한다. cordon과NoScheduletaint, 파드 간 배치 규칙은 아무도 검사하지 않는다. DaemonSet은 v1.12부터 NodeAffinity(matchFields) 기반으로 전환되어kube-scheduler에 위임되며(v1.17 GA), 이 덕분에 스케줄러의 필터 검증과 일관된 스케줄링 동작이 보장된다. - 이미 스케줄링된 파드는 옮길 수 없다.
spec.nodeName은 변경 불가 필드이고 쿠버네티스에 마이그레이션 기능이 없으므로, 배치를 바꾸려면 삭제 후 재생성이 유일한 경로다. 선점과 축출도 예외가 아니라 “삭제 후 재생성”이다. kube-scheduler는 Scheduling Framework, 플러그인, 프로필로 나뉜다. Scheduling Framework는 extension point의 종류와 순서를, 플러그인은 각 지점의 판단을, 프로필은schedulerName별로 어떤 플러그인을 켤지를 정한다. v1.32 기준 extension point는 모두 파드 하나를 대상으로 호출된다.- Scheduling Framework는 코어를 가볍게 유지하는 설계다. 코어는 extension point 호출 순서만 관리하는 오케스트레이터이고, 구체적 판단 로직은 모두 플러그인에 격리된다. 플러그인은 in-process로 컴파일되며, 이는 Scheduler Extender의 HTTP 오버헤드·상태 공유 불가 문제를 해결하기 위한 의도적 결정이다.
- 프로필은 바이너리에 있는 플러그인만 고를 수 있다. 레지스트리에 없는 플러그인을 적으면 기동이 실패한다. out-of-tree 플러그인(Coscheduling 등)을 쓰려면 커스텀 빌드 kube-scheduler를 만들어 두 번째 스케줄러로 띄우거나 기본 스케줄러를 교체한다. 커스텀 빌드 kube-scheduler는 구조와 설정 문법이
kube-scheduler와 같지만, 업스트림 바이너리는 아니다. - 스케줄러 프로세스가 여러 개면 자원 뷰가 갈린다. API Server는 노드 자원 충돌을 검사하지 않으므로, 같은 노드를 나눠 쓰면 늦게 도착한 파드가 kubelet에서 거부된다. 기본 플러그인으로 충분하면 한 프로세스 안의 여러 프로필로, 아니면 노드 풀을 분리해 운영하는 편이 적절하다. Kueue는 스케줄러가 아니라 스케줄러 앞단의 워크로드 admission 컨트롤러다.
파드가 Pending 상태에 빠졌을 때는 먼저 spec.nodeName이 비어 있는지 확인하여 스케줄링 문제인지 아닌지를 구분한다. 스케줄링 문제라면 어느 큐에 있는지를 좁혀 나가는데, 큐 구조는 2편 - 스케줄러 큐에서, Events 메시지와 메트릭으로 큐를 판별하는 구체적인 절차는 6편 - 스케줄링 실패 진단에서 다룬다.
참고 링크
- kube-scheduler - Kubernetes 공식 문서
- Assigning Pods to Nodes - Kubernetes 공식 문서
- Configure Multiple Schedulers - Kubernetes 공식 문서
- Feature Gates - Kubernetes 공식 문서
- Well-Known Labels, Annotations and Taints - Kubernetes 공식 문서
- Scheduling Framework - Kubernetes 공식 문서
- Scheduler Configuration - Kubernetes 공식 문서
- KEP-624: Scheduling Framework
- kubernetes-sigs/scheduler-plugins
- KEP-548: Graduate ScheduleDaemonSetPods to GA
이 글을 참조하는 글
- [Kubernetes] Kubernetes Deployment 재배포 실패 원인과 해결 - 1. Deployment 업데이트 전략
- [Kubernetes] 쿠버네티스 스케줄링 - 0. 스케줄링 일반 개념과 쿠버네티스
- [Kubernetes] 쿠버네티스 스케줄링 - 2. 프로세스와 선점
- [Kubernetes] 쿠버네티스 스케줄링 - 3. 스케줄링 제어
- [Kubernetes] 쿠버네티스 스케줄링 - 4. 스케줄러 설정과 최적화
- [Kubernetes] 쿠버네티스 스케줄링 - 5. 파드 단위 스케줄링의 한계와 Gang Scheduling
- [Kubernetes] 쿠버네티스 스케줄링 - 6. Extension Point 심화와 스케줄링 실패 진단
- [LLM] LLM 서빙과 최적화: vLLM on Trainium 워크샵 - 8.2.2. Trainium 디바이스가 쿠버네티스에 노출되는 경로
댓글남기기