[MLflow] 시스템 메트릭 로깅 - 1. 컨테이너 안에서 잰 값은 누구의 것인가: psutil, 네임스페이스, cgroup
TL;DR
- 학습 플랫폼 SDK에 MLflow 시스템 메트릭 로깅을 얹으려 했다. 함수 하나만 열어 주면 끝일 줄 알았다
- MLflow는 실제 메트릭을 측정하지 않는다.
start_run을 부른 프로세스 안의 스레드가 psutil로/proc파일을 읽고 pynvml로 NVML을 불러서 측정한다 - 제출 경로에서 그 프로세스는 워커 pod의 컨테이너 안이다. 따라서 측정되는 값은 그 컨테이너가 무엇을 볼 수 있느냐로 정해진다
/proc/net/dev는 network namespace로 격리되고 NVML은 런타임이 넣어 준 장치만 세지만,/proc/stat과/proc/meminfo는 어떤 namespace로도 격리되지 않는다- 실측 run의
system_memory_usage_megabytes는 워커 한도 100 GiB를 넘어 14만 MB까지 올라갔고, 두 계열로 역산한 분모는 노드 용량과 0.002%로 일치했다. pod가 아니라 노드를 잰다 - 요구의 배경이 OOM 진단이었으므로, 노드 기준 24.5%를 자기 컨테이너 사용률로 읽으면 반대 방향의 판단을 부른다
- 같은 노드에 뜬 rank끼리는 그 노드 값이 rank 수만큼 복제되어 각자의 이름으로 남는다
- 플랫폼 쪽 대응은 2편, 다른 도구와 런타임의 대응은 3편에서 다룬다
배경
학습 플랫폼 구조
회사에서 ML 엔지니어들이 학습을 제출하고 실험을 기록하는 데 쓰는 학습 플랫폼을 만들어 운영하고 있다. 이 플랫폼은 Kubernetes 위에 있다. KubeRay가 RayJob 하나마다 Ray 클러스터(head pod 하나 + worker pod 여럿)를 띄우고, 그 위에서 Ray Train의 TorchTrainer가 워커마다 학습 함수를 실행한다. 분산학습에서 rank는 학습 프로세스 하나에 붙는 번호이고, 보통 GPU 한 장에 프로세스 하나를 둔다. 이 플랫폼에서는 그 프로세스 하나가 Ray Train 워커(Ray Actor) 하나이고, KubeRay가 워커마다 pod 하나를 띄우며, 각 pod가 GPU 1장을 받는다. 그래서 여기서는 rank, 워커 프로세스, pod, GPU가 전부 1:1이다.
rank의 정의는 분산학습 배경 글에서, KubeRay와 Ray Train의 스케줄링 구조는 Ray/KubeRay 글에서 다룬 적이 있다.
이 대응 관계를 미리 잡아 두는 이유는 이 구조에서 rank 하나가 컨테이너 하나에서 돌기 때문이다. 격리의 단위는 pod가 아니라 컨테이너다. pod는 네트워크 namespace처럼 일부를 공유하는 컨테이너 묶음이고, 같은 pod의 사이드카는 자기 cgroup 한도와 루트 파일시스템을 따로 갖는다. 그래서 어느 rank가 무엇을 보는가는 그 rank가 사는 컨테이너가 무엇을 보는가로 정해지며, 계열에 따라 컨테이너 것(GPU, cgroup 한도)과 pod 것(네트워크)으로 나뉜다. 종합에서 rank마다 GPU는 다르게 보이고 CPU·메모리는 같게 보인다고 하는데, 그것이 전부 이 대응 위에 있다.
graph TB
    subgraph N1["gpu-node-1"]
        W0["worker pod<br/>rank 0 · GPU 1장"]
        W3["worker pod<br/>rank 3 · GPU 1장"]
    end
    subgraph N2["gpu-node-2"]
        W1["worker pod<br/>rank 1 · GPU 1장"]
    end
    subgraph N3["gpu-node-3"]
        W2["worker pod<br/>rank 2 · GPU 1장"]
    end
    H["head pod<br/>(driver)"] --> W0 & W1 & W2 & W3
    W0 & W1 & W2 & W3 --> M["MLflow 서버"]
여기서 하나 눈여겨 볼 것은, 한 노드에 워커 pod가 여러 개 뜰 수 있다는 점이다. 위 그림은 실제 플랫폼에서 제출된 4워커 학습의 배치 양상을 도식화한 것인데, rank 0과 rank 3이 같은 노드에 있다. 이 배치는 두 층의 스케줄링을 거쳐 나온다. 먼저 KubeRay가 만든 워커 pod를 어느 물리 노드에 놓을지는 Kubernetes 스케줄러가 자원 요청(GPU 1장, CPU, 메모리)을 보고 정한다. 그 뒤로 Ray 스케줄러가 이미 노드에 놓인 pod들, 즉 Ray 노드들 위에서 일한다. Ray Train이 워커 액터를 띄우면 Ray 스케줄러가 각 액터를 GPU가 남은 Ray 노드에 배치하고 rank 번호를 매긴다. pod마다 GPU가 1장이고 워커마다 GPU 1장을 요구하므로 pod 하나에 액터 하나가 들어간다. 결과적으로 어느 pod가 rank 몇이 될지는 Ray가 정하지만, 그 pod가 어느 물리 노드에 있는지는 그 전에 Kubernetes가 정한 것이고 Ray는 그것을 바꾸지 못한다. 사용자는 어느 쪽도 통제하지 않는다. 이 사실은 분산학습에서의 복제에서 다시 나온다.
기록 표면의 분업
실험 기록은 플랫폼이 MLflow를 감싸서 제공한다. ML 엔지니어는 인터랙티브 세션에서 로컬로 실험을 돌리든(이하 로컬 경로), 플랫폼에 제출하든(이하 제출 경로) 같은 코드를 쓴다.
# ML 엔지니어가 쓰는 코드 — 로컬과 제출 양쪽에서 동일
from mlplatform_sdk import tracking

tracking.log_metric('val/acc', 0.91, step=epoch)
tracking.log_params({'lr': 3e-4})
tracking.log_artifact_dir('/tmp/fit_out', to='out')
run의 생명주기
MLflow를 직접 쓰게 하지 않는 이유는 run의 생명주기를 플랫폼이 소유하기 때문이다. Ray Train은 워커마다 학습 함수를 호출하는데, 플랫폼은 그 함수를 감싸서 앞에는 준비 코드를, 뒤에는 정리 코드를 둔다. 제출 경로에서 run은 이 순서로 산다. driver가 run을 만들고, 준비 코드가 그 run에 붙고, ML 엔지니어의 학습 함수가 돌고, 정리 코드가 flush하고 떼어낸다. 이 글에서 워커 준비 단계는 학습 함수 앞에서 도는 그 준비 코드를 가리킨다. 학습 함수가 도는 동안 ML 엔지니어가 mlflow.start_run()을 직접 부르면 run이 둘이 되거나, rank마다 같은 지표를 중복 기록하게 된다.
sequenceDiagram
    participant D as driver (head)
    participant P as 워커 준비 단계 (플랫폼)
    participant U as 학습 함수 (ML 엔지니어)
    participant S as MLflow 서버
    D->>S: run 생성
    D->>P: MLFLOW_RUN_ID 전파
    P->>S: rank 0만 run 부착
    P->>U: 학습 함수 호출
    U->>S: tracking.log_metric(...)
    U-->>P: 반환
    P->>S: flush, detach
플랫폼이 소유하는 이유
로컬 경로에서처럼 사용자가 start_run()을 직접 부르게 두면 되지 않을까 싶기도 하다. 로컬에서는 실제로 그렇게 둔다. 제출 경로에서 그렇게 두지 않는 이유는 크게 두 가지다.
첫째, run은 프로세스 단위다. mlflow.start_run()은 부른 프로세스에 활성 run을 하나 만드니, 워커 4개가 각자 부르면 run이 4개 생긴다. 로컬 분산학습에서의 실험 추적 시 대표적인 방식은 rank 0만 run을 만들고 나머지 rank는 아무것도 기록하지 않는 것이다. Lightning의 MLFlowLogger, Hugging Face Trainer의 MLflowCallback, Ray 자체의 setup_mlflow가 전부 이 방식이다(2026년 9월 기준 소스 확인. 각각 rank_zero_only 데코레이터, is_world_process_zero 조건, rank_zero_only=True 기본값).
Ray의 것을 보면 아래와 같다.
# ray/air/integrations/mlflow.py — setup_mlflow (발췌, 2026-09 master)
class _NoopModule:
    def __getattr__(self, item):
        return _NoopModule()

def setup_mlflow(..., rank_zero_only: bool = True):
    context = ray.train.get_context()
    if rank_zero_only and context.get_world_rank() != 0:
        return _NoopModule()        # rank 0이 아니면 무엇을 불러도 아무 일도 없다
    ...
    mlflow_util.start_run(...)      # rank 0만 여기 도달해 run을 만든다
이 플랫폼의 SDK도 같다. tracking.log_metric류는 rank 0이 아니면 아무 일도 하지 않는다. 전 rank가 함께 불러야 하는 log_metrics_collective만 나머지 rank가 값을 보태는데, 그것도 모은 값을 rank 0이 한 번 쓴다. 이 분업은 아래 표에서 정리한다. loss처럼 rank 0이 대표로 기록하면 되는 지표에는 이것으로 충분하다.
이 플랫폼도 기록 함수는 같은 게이트를 쓴다. 다만 run을 만드는 주체가 rank 0이 아니라 driver인데, 그 이유는 게이트가 아니라 아래 둘째 항목에 있다.
둘째, 죽는 프로세스는 자기 죽음을 기록할 수 없다. cgroup 한도를 넘어 OOM으로 죽는 프로세스는 커널이 SIGKILL로 끝내므로 finally도 atexit도 돌지 않고, MLflow에는 run에 대한 heartbeat나 시간 초과가 없어(3.15 기준) 그 run은 RUNNING으로 남는다. 요구사항의 배경이 된 OOM이 정확히 이 경우다. 반대 방향도 있다. 전 워커를 한 run에 붙였다면 먼저 끝난 워커의 atexit이 아직 도는 잡을 FINISHED로 만든다. 그래서 run의 상태는 그 프로세스보다 오래 살면서 잡 전체를 보는 쪽이 써야 한다. 이 플랫폼에서는 driver가 run을 만들고 TorchTrainer.fit()의 결과로 FINISHED와 FAILED를 쓰며, 워커는 붙었다가 떼기만 한다.
이 소유 구조에는 부수 효과가 하나 있다. driver가 run을 먼저 만들면 그 id를 워커에 실어 보낼 수 있고, MLflow는 환경변수 MLFLOW_RUN_ID로 그 채널을 지원한다. 이 값이 있으면 start_run()은 새 run을 만드는 대신 그 run에 붙는다. 전 워커가 한 run에 각자의 이름으로 기록하는 것이 이것으로 가능해지는데, rank 0 게이트만 두는 방식으로는 안 되는 일이다.
이 글이 다루는 시스템 메트릭이 그 통로를 처음으로 필요로 한 통로이기도 하다. loss는 rank 0이 대표로 써도 되지만 시스템 메트릭은 rank마다 재는 값이 다를 수 있어서, rank 0 하나만 기록하면 나머지 워커가 무엇을 쓰고 있었는지가 통째로 빠진다. 소유가 사용자 쪽에 있었다면 ML 엔지니어가 학습 코드마다 run id 전파를 직접 짜야 했을 것이다. 다른 이유로 잡아 둔 구조가 이번 요구를 그대로 받은 셈이다.
플랫폼이 처리하는 것, SDK가 노출하는 것
| 플랫폼이 처리하는 것 | SDK가 노출하는 것 |
|---|---|
| run 생성(driver)과 워커의 run 부착 | 스칼라 log_metric |
| rank 0만 기록하도록 게이트 | 파라미터 log_params |
MLFLOW_RUN_ID·MLFLOW_TRACKING_URI를 전 워커에 전파 |
이미지·파일 log_artifact_* |
| 아티팩트 목적지(오브젝트 스토리지) 해소 | start_run (로컬에서만 run 생성, 제출에서는 부착) |
| 종료 시 flush → detach 순서 | 전 rank 집계 log_metrics_collective |
참고: rank 0 기록 게이트
표의 rank 0 게이트는 학습 지표 이야기다. 동기 데이터 병렬에서는 rank마다 파라미터가 같고 검증 지표도 보통 rank 0이 모아서 계산하므로, 전 rank가
log_metric을 부르면 같은 키, 같은 step에 같은 값이 워커 수만큼 쌓인다. 그래서 SDK의 기록 함수는 rank 0이 아니면 아무 일도 하지 않는다. rank마다 값이 다른 지표(로컬 배치의 loss, 처리량 등)를 위해서는 전 rank가 함께 불러 mean·sum·max로 모은 뒤 rank 0이 한 번 기록하는log_metrics_collective가 따로 있다.이 글의 주제인 시스템 메트릭은 이 둘과 다르다. rank마다 값이 다를 수 있고 모을 이유도 없어서, 워커마다 자기 이름을 붙여 따로 기록한다. 같은 노드의 워커끼리 노드 값이 겹치는 문제(2편의 중복 처리)는 그 위에서 생기는 별개 이야기다.
즉 “ML 엔지니어가 함수를 부르면, 어느 프로세스가 어느 run에 어떤 이름으로 쓰고 언제 정리할지는 플랫폼이 정한다”는 분업이다. 플랫폼에 제출된 run은 전부 이 표면으로 기록되고 있고, 인터랙티브 세션의 로컬 실험도 같은 함수를 쓴다.
요구사항
이 위에 신규 요구사항이 들어왔다. 학습 지표 옆에 시스템 메트릭도 기록해서 같은 화면에서 보고 싶다는 것이다. 배경이 있다. 플랫폼에 제출한 실험이 OOM으로 실패했고, 어떤 상황에서 죽는지 loss 곡선과 나란히 놓고 보고 싶다는 것이다.
여기서 경계를 하나 그어 두자. OOM 자체는 플랫폼이 대신 막아 줄 영역이 아니다. 배치 크기, 모델 크기, 데이터 로더의 워커 수 등은 학습 코드가 정한다. 플랫폼이 하는 일은 컨테이너에 한도를 걸고(cgroup), 한도를 넘으면 죽었다는 사실을 알려 주는 것까지다. 다만 어디까지 썼는지를 올바르게 보여 주는 것은 플랫폼 몫이다. 이 요구는 정확히 그 몫을 달라는 것이었다.
레퍼런스와 검토한 대안
학습 지표와 하드웨어 지표를 같은 run에 두는 것은 대부분의 ML 실험 추적 도구들이 기본으로 제공하는 기능이다.
MLflow allows users to log system metrics including CPU stats, GPU stats, memory usage, network traffic, and disk usage during the execution of an MLflow run. — MLflow System Metrics
wandb automatically logs system metrics every 15 seconds. — W&B System Metrics
그래서 첫 번째 안은 MLflow가 이미 가진 이 기능을 그대로 켜는 것이었다. 새로 만들 것이 없고, 기록되는 자리도 학습 지표와 같은 run이다.
다른 안도 검토했다. 사실 pod 관점의 자원 사용량은 플랫폼에서 운영 중인 Grafana의 워크로드 대시보드에 이미 있다. cAdvisor가 노출하는 container_memory_working_set_bytes를 pod 한도와 나란히 그리는 패널이다.
이런 패널을 읽는 예는 FFmpeg 튜닝 실험 글에 있다.
그러니 MLflow run 페이지에 Grafana 링크를 달아 주면 되지 않을까.
충분히 가능한 대안이지만, 세 가지 이유로 채택하지 않았다.
- 편의성: ML 엔지니어가 가장 자주 보는 화면은 MLflow다. 실험 하나를 보려고 두 화면을 오가야 하고, Grafana 대시보드 읽는 법까지 익혀야 한다. 실제로 그렇게 안내한 적이 있었는데 잘 쓰이지 않았다
- 대조의 번거로움: MLflow 차트의 x축은 기록할 때 넘긴
step(epoch든 iteration이든 학습 코드가 정한 정수)이고 Grafana는 벽시계 시각 축이다. “이 step에서 메모리가 얼마였나”를 맞춰 보려면 매번 시각을 환산해야 한다 - 보존 기간: Grafana가 보여 주는 값은 Prometheus에 있고, 이 클러스터의 Prometheus 보존 기간은 10일이다(
--storage.tsdb.retention.time=10d. 기본값은 15일). 며칠짜리 run을 몇 주 뒤에 다시 보면 이미 없다. Prometheus 보존 기간을 늘릴 수도 있지만, 그것은 실험 몇 개를 위해 클러스터 전체의 시계열을 다 오래 들고 있는 일이다- 뒤집어 말하면 실험 기록과 시스템 메트릭의 보존 기간이 서로 맞아야 한다. loss 곡선은 MLflow에 남는데 그 옆에 둘 자원 사용량이 열흘 뒤 사라지면, 한 달 뒤 OOM run을 다시 열었을 때 절반만 남는다. MLflow는 run 지표에 보존 기간을 두는 설정 자체가 없어서(3.15 기준. 보존 설정은 트레이스 보관에만 있고,
mlflow gc는 삭제 표시된 run만 정리한다) run과 지표의 수명이 같다. 이 서버에서 지표를 가진 가장 오래된 run은 196일 전 것인데 시계열이 그대로 조회된다. 시스템 메트릭을 MLflow에 넣으면 이 조건이 저절로 맞는다
- 뒤집어 말하면 실험 기록과 시스템 메트릭의 보존 기간이 서로 맞아야 한다. loss 곡선은 MLflow에 남는데 그 옆에 둘 자원 사용량이 열흘 뒤 사라지면, 한 달 뒤 OOM run을 다시 열었을 때 절반만 남는다. MLflow는 run 지표에 보존 기간을 두는 설정 자체가 없어서(3.15 기준. 보존 설정은 트레이스 보관에만 있고,
그래서 위에서 살펴본 것처럼 MLflow가 이미 제공하는 시스템 메트릭 기능을 SDK에 얹기로 했다. 방식은 앞서 본 기록 표면의 분업 그대로다. ML 엔지니어는 함수 하나를 부르고, 어느 프로세스가 어느 run에 어떤 이름으로 쓸지는 플랫폼이 정한다. 함수 하나를 추가하고 켤 프로세스만 고르면 끝일 것 같았다.
그런데 시스템 메트릭은 loss와 성질이 다르다. loss는 코드가 계산해 넘기는 값이라 어디서 부르든 같지만, 시스템 메트릭은 재는 프로세스가 어디에 있느냐에 따라 값이 달라진다. 그리고 제출 경로에서 그 프로세스는 컨테이너 안에 있다. 이 글은 여기서 마주친 문제를 다룬다. pod 안에서 잰 CPU·메모리가 왜 노드 값으로 기록되는지다. 그것을 지표 이름으로 드러내고 cgroup 수집기를 더한 설계와 구현은 2편에서 다룬다.
MLflow 시스템 메트릭의 동작 원리
활성화와 기록 지표
MLflow 시스템 메트릭 기록은 세 가지 방법으로 활성화할 수 있다.
# 1. 프로세스 전역
mlflow.enable_system_metrics_logging()
# 2. run 단위
mlflow.start_run(log_system_metrics=True)
# 3. 환경변수
# MLFLOW_ENABLE_SYSTEM_METRICS_LOGGING=true
By default, system metrics are sampled every 10 seconds and are directly logged after sampling. — MLflow System Metrics
기록되는 지표는 system/ 접두 아래 13계열이다. 이 목록은 MLflow의 기본값이자 전부다. 어떤 계열을 켤지 고르는 옵션은 없고, 조절할 수 있는 것은 샘플링 주기와 표본 수뿐이다. GPU 계열만 그 프로세스에 보이는 GPU 장수만큼 5계열씩 늘어난다. 컨테이너에서는 할당받은 장수이고 베어 호스트에서는 노드에 장착된 장수라, 아래 표는 GPU가 1장 보일 때 기준이다.
| 계열 | 키 | 개수 |
|---|---|---|
| CPU | cpu_utilization_percentage |
1 |
| 메모리 | system_memory_usage_megabytes, system_memory_usage_percentage |
2 |
| 디스크 | disk_usage_megabytes, disk_usage_percentage, disk_available_megabytes |
3 |
| 네트워크 | network_receive_megabytes, network_transmit_megabytes |
2 |
| GPU | gpu_0_utilization_percentage, gpu_0_memory_usage_*(2), gpu_0_power_usage_*(2) |
5 × 장수 |
gpu_0_의 0은 rank가 아니라 그 프로세스에 보이는 장치의 인덱스다. MLflow 원본 코드가 nvmlDeviceGetCount()로 센 개수만큼 f"gpu_{i}_..."를 만든다.
측정 위치
시스템 메트릭이 어디서 측정되는지를 정확히 해 두자. 이것이 이 글이 다루고자 하는 문제의 출발점이다.
MLflow의 log_metric은 호출한 스레드가 서버에 REST 요청을 보내는 것이다. 기본은 동기 호출이고, MLFLOW_ENABLE_ASYNC_LOGGING을 켜면 별도 큐 스레드가 보낸다. 어느 쪽이든 값은 호출자가 넘긴 것이고, MLflow는 측정하지 않는다.
시스템 메트릭은 다르다. start_run(log_system_metrics=True)가 실행되는 자리에서 SystemMetricsMonitor 객체가 만들어지고(fluent.py), start()가 daemon 스레드 하나를 띄운다.
MLflow 3.15.1 기준 원본 코드는 이렇다(system_metrics_monitor.py).
# mlflow/system_metrics/system_metrics_monitor.py (발췌)
def start(self):
    self._process = threading.Thread(
        target=self.monitor, daemon=True, name="SystemMetricsMonitor",
    )
    self._process.start()

def monitor(self):
    while not self._shutdown_event.is_set():
        for _ in range(self.samples_before_logging):
            self.collect_metrics()
            self._shutdown_event.wait(self.sampling_interval)
            run = MlflowClient(self._tracking_uri).get_run(self._run_id)
            if run.info.status != "RUNNING":
                return
        metrics = self.aggregate_metrics()
        self.publish_metrics(metrics)
이 스레드는 start_run을 부른 프로세스 안에 산다. MLflow 서버가 재는 것도 아니고, 노드에 뜬 에이전트가 재는 것도 아니다. 그러니 start_run을 부르는 프로세스마다 스레드가 하나씩 생기고, 각 스레드는 자기가 사는 프로세스의 환경에서 잰다.
graph TB
    subgraph WHERE["프로세스가 사는 곳 (베어 호스트 또는 컨테이너)"]
        subgraph PROC["start_run을 부른 프로세스 (학습 프로세스)"]
            L["학습 루프"] -->|"log_metric(loss)<br/>값은 호출자가 넘긴다"| API["MLflow 클라이언트"]
            T["SystemMetricsMonitor<br/>daemon 스레드"]
        end
        T -->|"10초마다 잰다"| M["이 프로세스가 사는 곳의<br/>CPU · 메모리 · 디스크 · 네트워크 · GPU"]
    end
    API --> S["MLflow 서버"]
    T -->|"log_batch"| S
제출 경로에서 이 프로세스는 Ray 워커 pod의 컨테이너 안이다. 로컬 경로에서는 베어 호스트이거나 인터랙티브 세션 pod다. 같은 코드가 어디서 도느냐에 따라 스레드가 보는 세계가 달라진다.
측정 수단
어디서 재는지를 정했으니 다음은 무엇으로 재는지다. 그 스레드가 값을 어디서 얻는가. MLflow 클라이언트에도, 서버에도 측정 코드는 없다. SystemMetricsMonitor는 수집기 리스트를 들고 주기적으로 부를 뿐이다(원본).
# mlflow/system_metrics/system_metrics_monitor.py (발췌)
self.monitors = [CPUMonitor(), DiskMonitor(), NetworkMonitor()]
if gpu_monitor := self._initialize_gpu_monitor():
    self.monitors.append(gpu_monitor)
실제 측정은 각 수집기가 psutil과 pynvml에 위임한다(cpu_monitor.py, gpu_monitor.py).
# mlflow/system_metrics/metrics/cpu_monitor.py (발췌)
def collect_metrics(self):
    cpu_percent = psutil.cpu_percent()
    self._metrics["cpu_utilization_percentage"].append(cpu_percent)

    system_memory = psutil.virtual_memory()
    self._metrics["system_memory_usage_megabytes"].append(system_memory.used / 1e6)
    self._metrics["system_memory_usage_percentage"].append(
        system_memory.used / system_memory.total * 100
    )
디스크는 psutil.disk_usage(os.sep), 네트워크는 psutil.net_io_counters(), GPU는 pynvml.nvmlDeviceGetHandleByIndex(i)로 얻은 핸들이다. MLflow는 psutil을 의존성에 넣지 않았다는 점도 문서에 명시되어 있다.
To log system metrics in MLflow, please install
psutil. We explicitly don’t includepsutilin MLflow’s dependencies becausepsutilwheel is not available for linux aarch64, and building from source fails intermittently. — MLflow System Metrics, Extra Dependencies
그리고 psutil은 리눅스에서 파일을 읽는다. cpu_percent()는 /proc/stat, virtual_memory()는 /proc/meminfo, net_io_counters()는 /proc/net/dev, disk_usage('/')는 statvfs('/')다. Everything is a File 글에서 /proc 루트에 시스템 전체 정보가 파일로 놓이는 구조를 다룬 적이 있는데, 그 글의 Kubernetes pod 모니터링 예시가 읽는 파일이 바로 /proc/stat과 /proc/net/dev다.
종합 측정 구조
정리하면 사슬은 이렇다. MLflow 스레드 → psutil/pynvml → /proc 파일과 NVML → 커널. 측정 위치 절의 그림에서 스레드 아래를 채우면 이렇게 된다.
graph TB
    subgraph NODE["노드 (호스트 커널)"]
        subgraph POD["워커 pod / 컨테이너"]
            subgraph PROC["학습 프로세스"]
                L["학습 루프"] -->|"log_metric(loss)"| API["MLflow 클라이언트"]
                T["SystemMetricsMonitor<br/>daemon 스레드"] --> PS["psutil"]
                T --> NV["pynvml"]
            end
            PS -->|"읽기"| PROC_FS["/proc/stat<br/>/proc/meminfo<br/>/proc/net/dev<br/>statvfs('/')"]
            NV --> NVML["NVML"]
        end
    end
    API --> S["MLflow 서버"]
    T -->|"log_batch"| S
MLflow가 기록하는 값은 결국 “그 프로세스가 사는 곳에서 /proc 파일을 열면 무엇이 보이는가”로 결정된다.
노드 값으로 기록되는 CPU와 메모리
앞의 원리를 컨테이너 환경에 놓으면 세 가지가 걸린다. psutil과 pynvml이 컨테이너 안에 있어야 한다는 의존성, 누가 어디서 켜느냐는 활성화 지점, 그리고 컨테이너 안에서 잰 값이 누구의 것이냐는 측정 범위다. 앞의 둘은 플랫폼 쪽 문제라 2편에서 다루고, 이 글은 셋째를 따라간다.
컨테이너는 자원이 격리되어 보인다. 컨테이너 안에서 nvidia-smi를 치면 할당받은 GPU만 보이고, ip addr를 치면 자기 인터페이스만 보인다. 그렇다면 MLflow 시스템 메트릭이 컨테이너 안에서 켜지면 그 컨테이너의 사용량을 재는가. 달리 말해, psutil이 읽는 /proc 파일에도 같은 격리가 적용되는가.
계열마다 답이 다르다. 그리고 그 사실이 이름에 드러나지 않는다.
실측
system_memory_usage_*가 무엇을 재는지 MLflow에 기록된 값으로 직접 확인했다. 이 확인을 위해 학습 하나를 실측용으로 제출해 돌렸다. rank 0 워커에서 MLflow의 enable_system_metrics_logging()을 직접 불러 시스템 메트릭을 켠 채로다. 16 GPU, 109시간, 1rank, 13계열, 38,867 step.
그 run의 System metrics 탭이다. system/ 접두 아래 13계열이 있고, GPU는 gpu_0_ 다섯 계열뿐이며 이름에 rank 표기는 없다.
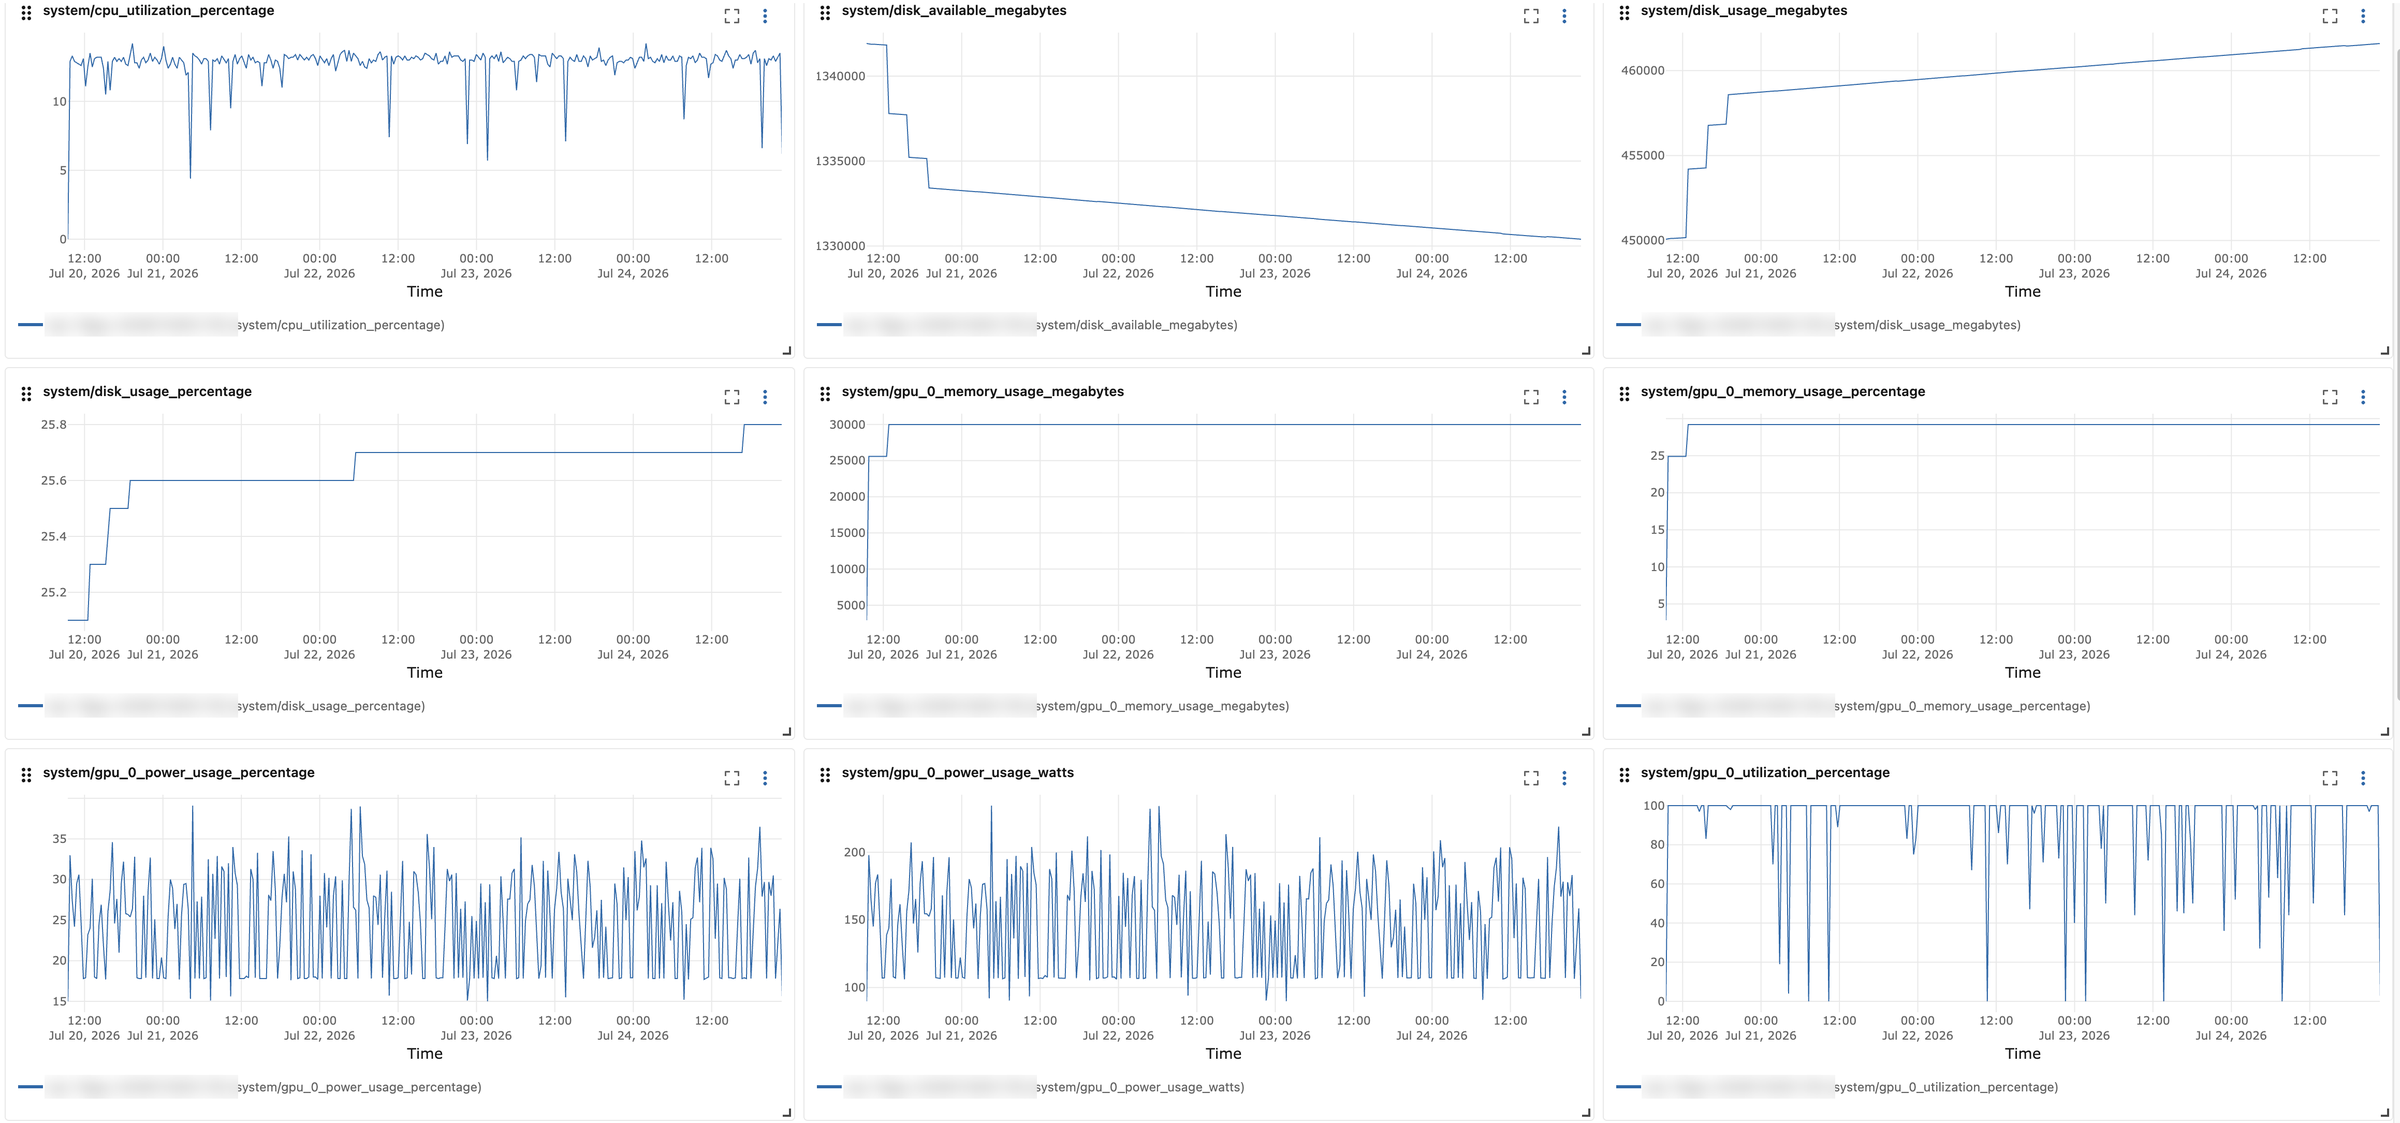
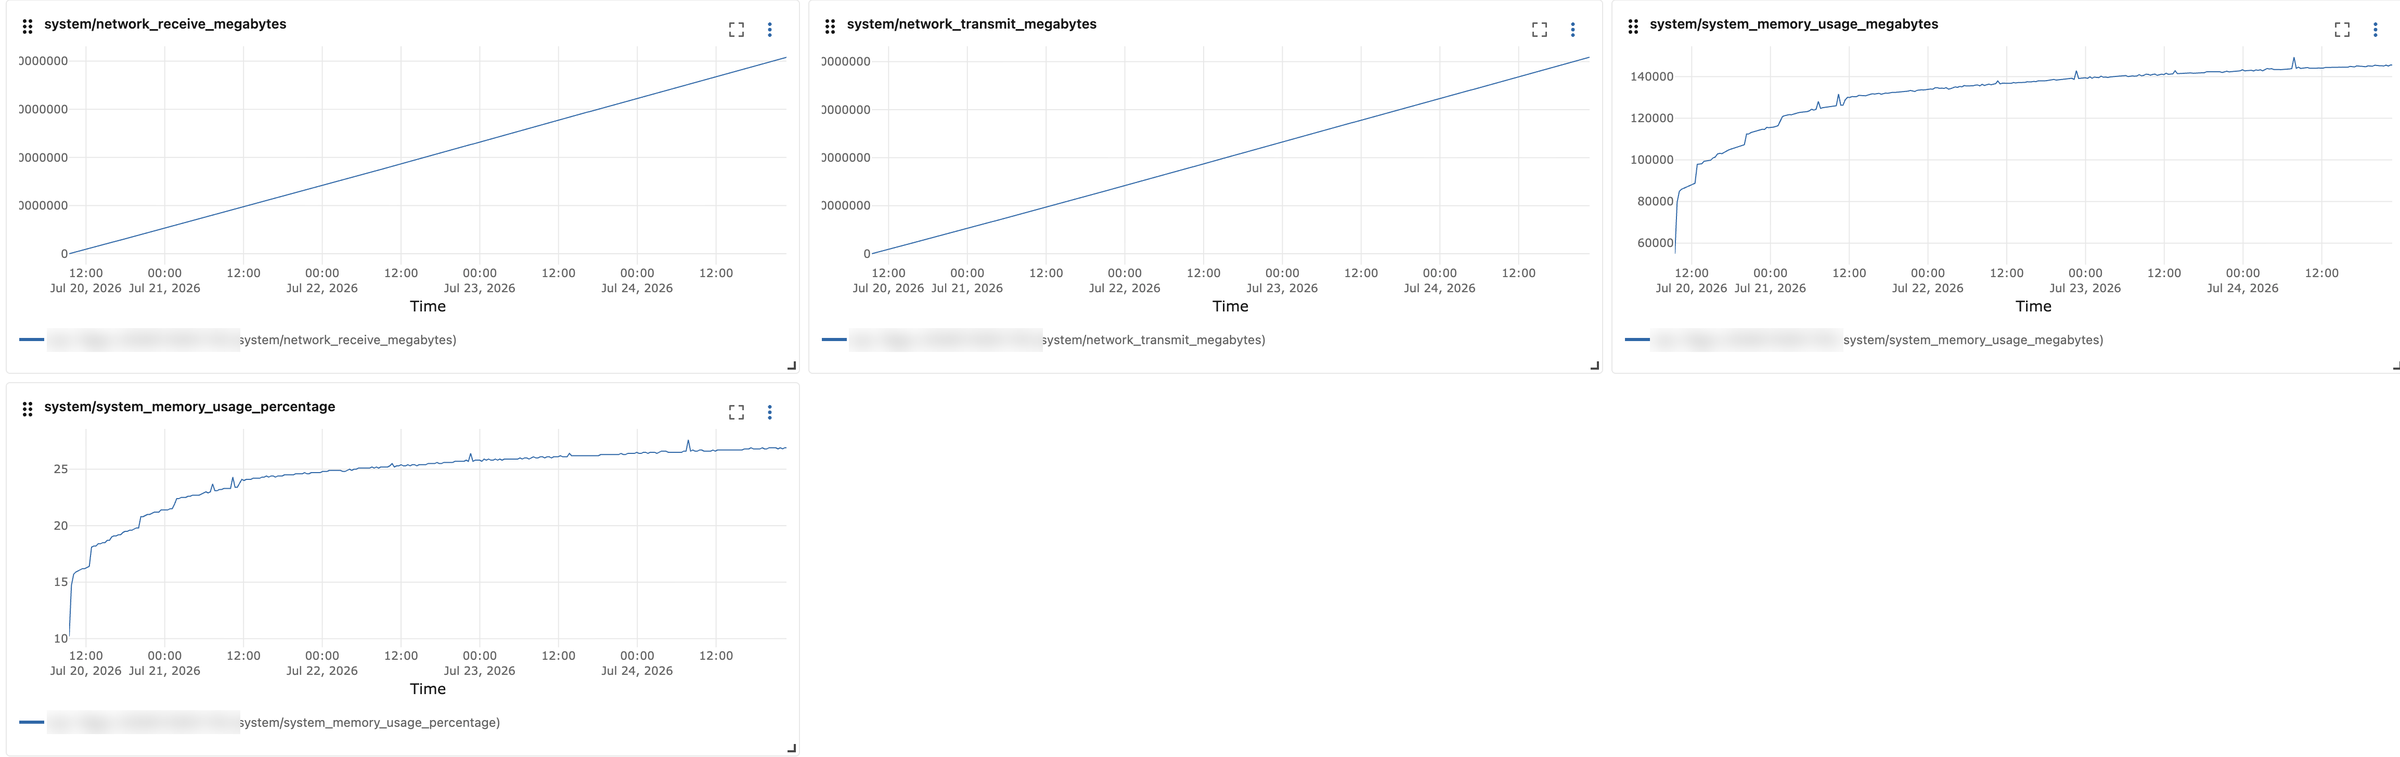
오른쪽 아래 system_memory_usage_megabytes를 보자. 6만 MB에서 시작해 14만 MB를 넘는다. 이 run의 워커 pod 한도는 100 GiB(107,374 MB)였다. 컨테이너가 도달할 수 없는 값이 “사용량”으로 찍혀 있다.
이 값이 무엇인지 역산해 보자. 방법은 간단하다. system_memory_usage_megabytes와 system_memory_usage_percentage는 같은 시각에 같은 psutil.virtual_memory() 결과에서 나온다. 전자는 used, 후자는 used / total * 100이다. 두 계열을 step별로 짝지으면 total을 역산할 수 있다.
# 두 계열에서 역산한 total (전 구간 38,867점)
implied total MB   median=540,576   p05=539,579   p95=541,556

# 그 run이 뜬 노드의 용량
gpu-node-1 capacity = 540,565 MB   (144 논리 코어)
0.002% 차이로 노드 용량과 일치한다. 이 run의 워커 pod 한도는 100GiB였고, 같은 플랫폼의 다른 레포는 64GiB(68,719 MB)를 쓴다. 어느 쪽과도 관계없는 숫자다. system_memory_usage_*는 pod가 아니라 노드를 잰다.
한도 대조
화면은 위 캡처 그대로다. 그 값을 워커 한도와 나란히 놓아 보면 이렇게 된다. 값은 위 run의 전 구간 평균이다.
| 지표 | 보이는 값 | 워커 한도가 64GiB·8코어라면 |
|---|---|---|
system_memory_usage_megabytes |
132,688 MB | 한도 68,719 MB. 한도의 1.9배에 이르는 값이 “사용량”으로 보인다 |
system_memory_usage_percentage |
24.5% | 분모가 노드 540 GB. 한도와 무관 |
cpu_utilization_percentage |
12.7% | 노드 144코어 대비. 환산하면 약 18코어. 예산 8코어와 비교 불가 |
그런데 이 표의 오른쪽 열은 ML 엔지니어의 화면에 없다. 워커 자원은 제출 설정에 적긴 하지만, 그 값이 컨테이너 한도로 걸린다는 것과 그 한도가 이 지표의 분모와 무관하다는 것까지 알고 차트를 보는 사람은 드물다. 그러니 132 GB가 찍혀도 “내 학습이 그만큼 쓰나 보다”로 읽을 뿐, 한도 64 GiB와 견줘 이상하다고 느낄 계기가 없다. 값이 틀려 보이지 않는다는 것이 이 문제의 성질이다.
한도와 견줘 보면 사용량이 한도보다 크게 나오지만, 그렇다고 측정된 값이 틀린 것은 아니다. 노드 전체가 132 GB를 쓰고 있었다는 뜻이고, 거기엔 같은 노드의 다른 pod와 호스트 프로세스가 전부 들어 있다.
cpu_utilization_percentage도 마찬가지다. psutil.cpu_percent()는 노드 전체 논리 코어 대비 백분율이라, 12.7%는 노드의 논리 코어 144개가 그 시간의 12.7%만큼 바빴다는 뜻이다. 코어 18개 분량의 CPU 시간이 노드 전체에서 쓰였다는 것이지, 이 pod의 프로세스가 CPU 시간을 얼마나 받았다는 뜻이 아니다.
오판 가능성
문제는 이 값이 요구사항의 배경과 정확히 반대로 작용한다는 점이다.
노드 기준 메모리 24.5%를 보면 “여유가 많다”로 읽힌다. 배치를 올려도 되겠다는 판단으로 이어진다. 그렇게 올리면 자기 컨테이너는 64 GiB에서 죽는다. 노드 540 GB의 24.5%는 컨테이너가 도달할 수 없는 숫자다. 값 자체는 틀리지 않았지만, 지표 이름을 곧이곧대로 읽고 판단하면 정확히 반대 방향의 결론에 이른다.
요구의 출발이 OOM 진단이었다는 점을 고려해 보면, OOM을 피하려고 기록한 지표를 해석한 결과가 오히려 OOM을 부르는 쪽으로 읽히는 셈이다.
메모리만의 문제도 아니다. 13계열 가운데 컨테이너 자기 몫을 재는 것은 GPU 5개와 네트워크 2개뿐이고, CPU·메모리 3개는 노드 값, 디스크 3개는 노드 디스크 값이다. 어느 계열이 무엇을 재는지는 종합 절에서 하나씩 가른다.
분산학습에서의 복제
여기에 분산학습이 얹히면 문제가 한 번 더 커진다. 학습 플랫폼 구조 절에서 한 노드에 워커 pod가 여러 개 뜰 수 있다고 했다. 4워커 제출의 실제 배치를 확인했더니 노드 셋에 2·1·1로 흩어져 있었다. rank 0과 rank 3이 같은 노드였다.
같은 노드에 뜬 두 rank가 각각 시스템 메트릭을 켜면, 둘 다 같은 /proc/meminfo를 읽는다. 읽는 시각이 조금 달라 절대값은 어긋나지만, 같은 노드의 같은 사실이다. 그런데 이름은 각각 “rank 0의 메모리”, “rank 1의 메모리”로 붙는다. 노드 하나의 값이 rank 수만큼 복제되어 각각 자기 사용량처럼 보이는 것이다. 워커가 16개면 노드 값이 최대 16번 중복 기록된다.
/proc 파일별 격리 차이
왜 /proc/meminfo는 컨테이너 안에서도 노드 값을 보여 주는가. 이 답은 MLflow에도, Kubernetes에도 없다. 원인은 둘이다. 리눅스 커널이 /proc의 파일마다 격리를 다르게 하는 방식, 그리고 psutil이 그 가운데 격리되지 않는 파일을 읽고 cgroup은 읽지 않는다는 사실이다. 앞의 것부터 본다.
namespace와 cgroup
컨테이너는 별도의 커널을 갖지 않는다. 호스트 커널의 두 기능, namespace와 cgroup의 조합이다. namespace가 “무엇이 보이는지”를 제어하고, cgroup이 “얼마나 쓸 수 있는지”를 제어한다.
Pod CPU Limit 배경지식 글에서 이 구분을 다룬 적이 있다.
namespace의 정의를 man 페이지에서 가져오면 이렇다.
A namespace wraps a global system resource in an abstraction that makes it appear to the processes within the namespace that they have their own isolated instance of the global resource. — namespaces(7)
핵심은 “a global system resource”다. namespace는 자원 종류별로 감싼다. 리눅스에는 8종이 있다.
| namespace | 격리하는 것 |
|---|---|
| mount | 마운트 포인트 |
| PID | 프로세스 ID |
| network | 네트워크 장치, 스택, 포트, 라우팅 |
| IPC | System V IPC, POSIX 메시지 큐 |
| UTS | 호스트명, 도메인명 |
| user | UID, GID |
| cgroup | cgroup 루트 디렉토리 |
| time | 부팅 시각, 단조 시계 |
이 목록에 “메모리 통계”나 “CPU 통계”는 없다. namespace가 감싸는 것은 네트워크 스택, 마운트 트리, PID 공간 같은 커널 객체이지, “이 기계의 메모리가 얼마나 쓰이고 있나” 같은 시스템 전체 통계가 아니다. 컨테이너 몫의 사용량을 세는 것은 namespace가 아니라 cgroup이다. 그래서 통계가 파일로 나오는 창도 둘이다. 시스템 전체 통계는 /proc(/proc/meminfo, /proc/stat)이 내보이고, cgroup 단위의 사용량과 한도는 /sys/fs/cgroup(memory.current, memory.max, cpu.stat)이 내보인다. 어느 창을 읽느냐가 곧 무엇을 재느냐다.
격리되는 파일, 격리되지 않는 파일
두 창 가운데 psutil이 읽는 것은 /proc 쪽이다. /sys/fs/cgroup은 애초에 cgroup마다 디렉토리가 나뉘어 있고, cgroup namespace를 쓰는 이 클러스터에서는 컨테이너 안에서 자기 cgroup이 루트로 보이므로 따질 것이 없다.
문제는 /proc이고, 그 파일마다 왜 다른지를 보려면 /proc이 무엇인지부터 떠올려야 한다. /proc은 디스크에 없다. Everything is a File 글에서 다룬 대로 커널이 런타임에 만드는 가상 파일 시스템이라, 파일을 읽을 때마다 커널이 그 순간의 상태를 조회해 내용을 만들어 돌려준다. 그러니 컨테이너 안에서 무엇이 보이는가는 그 파일의 내용을 만드는 커널 코드가 어떤 namespace를 참조하는가로 정해진다. /proc/net/dev를 만드는 코드는 읽는 프로세스가 속한 network namespace의 인터페이스 목록을 돌고, /proc/meminfo를 만드는 코드는 커널 전역의 메모리 통계를 읽는다. 같은 /proc 아래 있어도 한쪽은 격리되고 한쪽은 격리되지 않을 수 있는 이유다.
/proc/net/dev는 격리된다. 네트워크 인터페이스 통계는 network namespace 소속이라, 컨테이너 안에서 열면 자기 namespace의 인터페이스만 나온다. 네임스페이스 네트워킹 글에서 ip netns exec로 각 namespace가 자기 인터페이스만 보는 것을 실습했다. 그래서 MLflow의 network_* 계열은 pod 값이다. 아래 실측 pod 안에서 /proc/net/dev에는 lo와 eth0 두 줄뿐이었다. 같은 노드에서 hostNetwork로 뜬 컨테이너에서 같은 파일을 열면 물리 NIC 네 개와 calico 가상 인터페이스 십여 개가 전부 나온다.
/proc/stat과 /proc/meminfo는 격리되지 않는다. 시스템 전체의 CPU 시간 누적과 메모리 총량·사용량은 어떤 namespace에도 속하지 않는 전역 정보다. 컨테이너 안에서 열어도 호스트 파일 그대로다. 컨테이너 안에서 free -m이나 top을 쳤을 때 노드 전체 메모리가 보이는 것과 같은 현상이고, Docker에서도 똑같다. Kubernetes와는 무관하다.
이 사실은 오래됐다. 2014년의 글이 정확히 이 문장을 쓰고 있다.
Unfortunately
/proc/meminfo,/proc/vmstatand friends are not containerized. — Fabio Kung, Memory inside Linux containers (2014)
Kubernetes 문서도 kubelet이 free -m을 쓰지 않는 이유로 이것을 든다.
On Linux nodes, the value for
memory.availableis derived from the cgroupfs instead of tools likefree -m. This is important becausefree -mdoes not work in a container. — Kubernetes, Node-pressure Eviction
2012년에 /proc/meminfo를 memory cgroup 기준으로 보여 주자는 커널 패치가 올라온 적이 있는데(“cgroup and namespaces are used for creating containers but some of information is not isolated/virtualized”), 머지되지 않았다. psutil 메인테이너는 2024년에 Fabio Kung의 글을 인용하며 “The article is from 2014 but it seems nothing has changed”라고 썼다.
컨테이너 안에서 두 파일을 나란히 열어 보면 차이가 바로 보인다. 학습 노드(144 논리 코어, 540 GB)에 워커와 같은 한도(메모리 64Gi, CPU 8, GPU 1장)로 pod를 하나 띄워 안에서 읽은 실제 출력이다.
# 실측 pod 안. 노드는 커널 5.15, cgroup v2
$ head -3 /proc/meminfo
MemTotal:       527895940 kB      # 노드 전체. 540,565 MB
MemFree:        85196080 kB
MemAvailable:   506045624 kB

$ free -m | head -2
               total        used        free      shared  buff/cache   available
Mem:          515523       17939       83198          10      414385      494185

$ nproc; grep -c '^cpu[0-9]' /proc/stat
144
144

$ cat /sys/fs/cgroup/memory.max /sys/fs/cgroup/memory.current
68719476736                        # 이 컨테이너의 한도. 64 GiB
46043136                           # 이 컨테이너가 지금 쓰는 양. 46 MB
$ cat /sys/fs/cgroup/cpu.max
800000 100000                      # 100ms마다 800ms. 8코어 쿼터

$ python3 -c "import psutil; vm = psutil.virtual_memory(); print(round(vm.total/1e6), round(vm.used/1e6), vm.percent, psutil.cpu_count())"
540565 22378 4.1 144               # psutil이 보는 total, used, percent, cpu_count. 전부 노드 값
같은 컨테이너 안에서 psutil은 “540 GB 중 22 GB, 4.1%”라고 답하고, cgroup은 “64 GiB 중 46 MB”라고 답한다. 두 답이 같은 프로세스에서 나온다. MLflow의 CPUMonitor가 부르는 것은 앞의 것이다.
참고: cgroup namespace는 이름 때문에 오해하기 쉽다. cgroup namespace가 격리하는 것은
/proc/self/cgroup에 보이는 cgroup 경로뿐이다. 위 pod 안에서/proc/self/cgroup은0::/로 자기가 루트인 것처럼 보이지만, 같은 자리에서 연/proc/meminfo는 노드 값이다. 한편 이 문제를 사용자 공간에서 우회하는 도구로 lxcfs가 있다. FUSE 파일시스템으로/proc/meminfo,/proc/stat등을 덮어써 cgroup 값을 보여 준다. README는 목적을 “making Linux containers feel more like a virtual machine”으로 적고 있다. Kubernetes에서는 DaemonSet으로 띄우고 pod에 마운트를 주입하는 방식으로 쓰이지만, 기본 제공은 아니다.
psutil은 cgroup을 읽지 않는다
psutil은 시스템 레벨 라이브러리다. “이 프로세스가 사는 컨테이너”라는 개념을 갖고 있지 않고, 갖지 않기로 한 것이 설계다. 컨테이너의 한도는 /proc이 아니라 cgroup에 있다. /sys/fs/cgroup/memory.max(한도), memory.current(현재), cpu.max(CPU 쿼터)다. psutil의 virtual_memory()는 이 파일들을 읽지 않는다. 버그가 아니다. 이 라이브러리가 답하는 질문이 “이 기계가 얼마나 쓰나”이지 “이 컨테이너가 얼마나 쓰나”가 아닐 뿐이다. 컨테이너 안에서 이 cgroup 파일들을 직접 읽는 예시는 Everything is a File 글에 있다. CPU도 같다. 실측 pod에서 psutil.cpu_count()와 nproc은 둘 다 144를 돌려줬다. cpu.max의 8코어 쿼터는 코어 수 어디에도 반영되지 않는다.
디스크와 GPU의 격리 방식
CPU·메모리는 /proc 가운데 격리되지 않는 파일을 읽는 문제였다. 나머지 두 계열은 격리가 되긴 하는데, 그 방식이 /proc 이야기와 다르다. 디스크는 mount namespace로 격리된 자기 루트 파일시스템을 보지만 용량 숫자는 노드 디스크의 것이고, GPU는 namespace가 아니라 장치 파일로 격리된다.
디스크
disk_* 계열은 CPU·메모리와 또 다르다. CPU·메모리는 노드 전체의 값이었다. 디스크는 노드 값도 컨테이너 값도 아닌, 컨테이너의 루트 파일시스템이 얹혀 있는 노드 파티션의 값이다. 왜 그런지 한 단계씩 보자.
먼저 psutil이 무엇을 부르는가. psutil.disk_usage('/')는 statvfs('/') 시스템 콜을 부른다. statvfs는 경로 하나를 받아 그 경로가 속한 파일시스템의 통계, 즉 블록 크기·전체 블록 수·남은 블록 수를 돌려주는 시스템 콜이다. df가 쓰는 것과 같다. 어느 파일시스템의 통계를 돌려줄지는 커널의 VFS(Virtual File System) 층이 경로를 보고 정한다. VFS는 ext4·NFS·overlay 같은 구체 파일시스템 위에 놓인 공통 인터페이스로, open·read·statvfs 같은 호출을 그 경로를 맡은 파일시스템 구현으로 넘긴다. 그래서 호출이 실제로 무엇을 돌려줄지는 그 파일시스템 구현이 결정하고, psutil 같은 호출자는 아래가 어느 파일시스템인지 모른 채 statvfs('/')만 부르면 된다. 이 구조 때문에 psutil은 자기가 overlay 위에 있다는 것도, 그 overlay가 무엇을 돌려주는지도 모른다.
VFS 관련 내용은 컨테이너 파일 시스템 글의 VFS 절에서 다룬 적이 있다.
다음은 컨테이너의 /가 어떤 파일시스템인가다. mount namespace로 격리된 컨테이너의 /는 overlay 마운트다. 컨테이너 파일 시스템 글에서 본 대로 overlay는 이미지 레이어(lower)와 컨테이너의 쓰기 레이어(upper)를 겹쳐 하나의 트리(merged)로 보여 준다. 그런데 overlay는 자기 디스크 공간을 갖지 않는다. lower도 upper도 결국 노드 디스크의 컨테이너 런타임 저장소 아래 디렉토리이고, overlay는 그 위에 놓인 보기일 뿐이다.
이제 두 사실을 합치면 된다. psutil이 부른 statvfs('/')는 VFS를 거쳐 컨테이너의 /를 맡은 overlayfs에 도착한다. 그런데 overlayfs는 자기 공간이 없으므로, 이 호출을 자기가 얹혀 있는 파일시스템에 위임하도록 구현되어 있다. 커널 overlayfs의 statfs 구현(ovl_statfs)은 upper 디렉토리가 있는 파일시스템(upper가 없으면 첫 lower)의 루트에 다시 statfs를 부르고, 그 결과에서 파일시스템 종류만 overlay로 바꿔 돌려준다. 용량 숫자는 손대지 않는다. 그래서 결과적으로는 upper가 놓인 노드 파티션(보통 ext4)의 용량이 반환된다. 실측 pod 에서 확인해 본 결과, df -h /는 overlay 1.8 TB 중 970 GB 사용을 보여 줬고, psutil.disk_usage('/')도 총 1,888 GB를 돌려줬다. 그 pod가 디스크에 쓴 것이 사실상 없었는데도 그렇다. 이 파티션은 그 노드의 컨테이너 이미지와 쓰기 레이어가 저장되는 곳이지, 학습이 실제로 읽고 쓰는 곳이 아니다.
여기서 오독이 생길 수 있다. ML 엔지니어에게 “디스크”는 데이터셋이 있는 곳과 체크포인트를 쓰는 곳이다. 이 플랫폼에서 데이터셋은 NFS 마운트에, 체크포인트는 오브젝트 스토리지에 있다. 실험 화면에 disk_available_megabytes가 1.3 TB로 찍혀 있으면, 데이터셋 볼륨이나 체크포인트 목적지에 그만큼 여유가 있다고 읽기 쉽다. 그러나 이 값은 그 둘과 무관한 노드 파티션의 여유다. NFS 볼륨이 꽉 차서 데이터 로더가 멈추거나 체크포인트 업로드가 실패해도 이 차트는 1.3 TB를 그대로 보여 준다. 반대로 disk_usage_percentage가 오르는 것을 보고 “내 학습이 디스크를 채우고 있다”고 읽어도 틀린다. 그 노드에 새 이미지가 pull됐거나 다른 컨테이너가 쓰기 레이어에 쓴 것이다. 이 값이 급격히 오르면 그 노드의 컨테이너 저장소가 차오르고 있다는 뜻이라 플랫폼에는 의미 있는 신호지만, 실험 진단용은 아니다.
GPU
gpu_* 계열은 pod 값이다. 다만 그 이유가 namespace가 아니다. Kubernetes의 NVIDIA device plugin은 pod에 GPU를 할당할 때 Allocate 응답에 어느 장치를 넣을지 표시하고, 컨테이너 런타임의 NVIDIA 훅이 그 표시를 읽어 해당 장치 파일만 컨테이너에 넣는다. 표시하는 방식은 둘이다. 기본은 장치 UUID를 NVIDIA_VISIBLE_DEVICES 환경변수에 넣는 것이고(NVIDIA Device Plugin 글에서 다룬 흐름), 다른 하나는 장치 마운트 목록을 응답에 직접 넣고 환경변수는 void로 두는 것이다. 후자는 사용자가 환경변수를 덮어써 남의 GPU를 가져가는 것을 막으려는 설정이고, 이 클러스터가 쓰는 방식이다. 어느 쪽이든 결과는 같다. 컨테이너에는 할당된 장치 파일만 들어오고, pynvml의 nvmlDeviceGetCount()는 그 장치만 센다.
여기서 NVML이 무엇인지 짚고 가자. pynvml이 부르는 NVML은 libnvidia-ml.so, 즉 유저 공간 라이브러리다. 디바이스 드라이버 3계층 구조 글에서 본 대로 유저 라이브러리는 장치 파일(/dev/nvidia*)을 열어 커널 모듈(nvidia.ko)에 닿는다. 그러니 NVML이 셀 수 있는 GPU는 그 컨테이너에 장치 파일이 들어와 있는 GPU다. Everything is a File 글의 장치 주입 확인처럼 컨테이너 안에서 ls -l /dev/nvidia*를 치면 NVML이 보게 될 목록이 그대로 나온다.
실측 pod(GPU 1장 할당)에서 확인한 모습이다.
# 실측 pod 안. 노드에는 GPU가 4장 있다
$ ls -l /dev/nvidia*
crw-rw-rw- 1 root root 195,   3 /dev/nvidia3        # 노드의 3번 장치 하나만 들어와 있다
crw-rw-rw- 1 root root 195, 255 /dev/nvidiactl
crw-rw-rw- 1 root root 506,   0 /dev/nvidia-uvm
$ nvidia-smi -L
GPU 0: NVIDIA RTX PRO 6000 Blackwell Server Edition (UUID: GPU-cd61...)
$ python3 -c "import pynvml; pynvml.nvmlInit(); print(pynvml.nvmlDeviceGetCount())"
1
노드의 3번 장치가 컨테이너 안에서는 GPU 0이고, NVML은 1을 센다.
GPU에는 “보이는 장치를 고른다”는 뜻의 환경변수가 둘 있고, 이 둘을 갈라야 위 결과가 읽힌다. 읽는 주체가 다르다.
| 환경변수 | 누가 읽나 | 언제 | 효과 |
|---|---|---|---|
NVIDIA_VISIBLE_DEVICES |
컨테이너 런타임의 NVIDIA 훅 | 컨테이너를 만들 때 | 어느 장치 파일을 컨테이너에 넣을지 정한다. 컨테이너 안의 모든 프로세스가 영향을 받는다 |
CUDA_VISIBLE_DEVICES |
CUDA 런타임(libcuda.so) |
프로세스가 CUDA를 초기화할 때 | 그 프로세스의 CUDA 코드가 쓸 장치를 거른다. 장치 파일은 그대로 있다 |
첫째 줄이 위에서 본 device plugin의 표시다. 이 클러스터는 마운트 목록 방식이라 컨테이너 안의 NVIDIA_VISIBLE_DEVICES가 void였고, 환경변수 방식이었다면 장치 UUID가 들어 있었을 것이다. 어느 쪽이든 장치 파일이 들어온 뒤의 일은 같다. 덧붙이면 이 환경변수는 GPU가 배정됐는지의 근거로도 쓸 수 없다. 이 클러스터의 CPU 워커에서도 베이스 이미지가 세워 둔 NVIDIA_VISIBLE_DEVICES=all이 그대로 들어 있었다. 배정 여부를 말하는 것은 장치 파일뿐이다.
남는 것은 둘째 줄이다. GPU를 다루는 유저 라이브러리가 둘인데, 둘 다 장치 목록의 출발점은 같다. 컨테이너에 들어와 있는 장치 파일이다. 차이는 그 위에 CUDA_VISIBLE_DEVICES라는 필터를 얹느냐다.
| 라이브러리 | 누가 쓰나 | 장치 목록의 출발점 | CUDA_VISIBLE_DEVICES |
|---|---|---|---|
CUDA 런타임(libcuda.so) |
PyTorch 같은 CUDA 프로그램 | 컨테이너에 있는 장치 파일 | 그중 환경변수에 적힌 것만 남기고 번호를 0부터 다시 매긴다 |
NVML(libnvidia-ml.so) |
nvidia-smi, pynvml |
컨테이너에 있는 장치 파일 | 보지 않는다. 아래에서 확인한다 |
그래서 같은 환경에서도 PyTorch가 세는 GPU 수와 nvidia-smi가 세는 GPU 수는 다를 수 있다. 시스템 메트릭의 GPU 계열을 세는 것은 뒤쪽, NVML이다. 이 환경변수로 GPU를 골라 쓰는 데 익숙하다 보니 컨테이너에서 1장만 보이는 것도 그것 때문이 아니냐는 의문이 들 수 있는데, 만약 NVML도 이 필터를 본다면 시스템 메트릭의 GPU 계열은 장치 파일이 아니라 사용자가 바꿀 수 있는 환경변수 하나에 기대는 셈이 된다.
그래서 확인했다. GPU 4장인 호스트에서 컨테이너 밖에서, CUDA_VISIBLE_DEVICES만 바꿔 가며 NVML에 장치 수를 물었다.
# GPU 4장 호스트, 컨테이너 밖
$ CUDA_VISIBLE_DEVICES=0   python3 -c "import pynvml; pynvml.nvmlInit(); print(pynvml.nvmlDeviceGetCount())"
4
$ CUDA_VISIBLE_DEVICES=1   python3 -c "import pynvml; pynvml.nvmlInit(); print(pynvml.nvmlDeviceGetCount())"
4
$ CUDA_VISIBLE_DEVICES=0,2 python3 -c "import pynvml; pynvml.nvmlInit(); print(pynvml.nvmlDeviceGetCount())"
4
어느 경우에도 4다. NVML은 CUDA_VISIBLE_DEVICES를 무시한다. pod 안에서 1장만 보이는 것은 장치 파일이 하나만 들어와서다. 이 사실은 격리와 전 rank 수집에서 다시 쓴다. 컨테이너 밖 베어 호스트에서는 같은 이유로 NVML이 노드의 GPU를 전부 센다.
이것이 gpu_0_의 0이 항상 0인 이유다. 컨테이너마다 GPU가 1장이니 인덱스는 늘 0이고, rank를 구분하는 것은 인덱스가 아니라 이름에 따로 붙일 rank 표기여야 한다.
계열별 성질 종합
파일 기준 분류
13계열을 psutil이 읽는 파일 기준으로 다시 나누면 이렇게 된다.
| 계열 | psutil 호출 | 읽는 것 | 여는 프로세스의 namespace에 따라 내용이 다른가 | 재는 범위 | 같은 노드 rank끼리 |
|---|---|---|---|---|---|
cpu_utilization_percentage |
cpu_percent() |
/proc/stat |
아니오 | 노드 | 같은 사실 |
system_memory_usage_* |
virtual_memory() |
/proc/meminfo |
아니오 | 노드 | 같은 사실 |
disk_* |
disk_usage('/') |
컨테이너 rootfs statvfs |
mount ns | 컨테이너 루트 FS (노드 디스크가 backing) | 같은 사실 |
network_* |
net_io_counters() |
/proc/net/dev |
예 (network ns) | pod | 다른 값 |
gpu_0_* |
pynvml | NVML | 아니오 (namespace 아님 — 런타임이 넣어 준 장치 파일) | 그 컨테이너의 GPU | 다른 값 |
system/이라는 하나의 접두 아래 성질이 넷인 계열이 섞여 있다. 노드, 컨테이너 루트 파일시스템, pod, 장치. 이름은 그 사실을 말하지 않는다. 이것이 문제의 정체다.
격리와 전 rank 수집
이 표에서 한 가지가 더 읽힌다. “전 rank가 수집한다”는 것의 값어치가 어디서 나오는가다.
| 계열 | 제출 (컨테이너) | 로컬 (베어 호스트) |
|---|---|---|
gpu_* |
rank마다 다름 (device plugin이 1장씩) | 같음 (NVML이 호스트 전 장치를 센다) |
network_* |
rank마다 다름 (pod netns) | 같음 (호스트 netns 하나) |
cpu_·system_memory_ |
같은 노드끼리 같음 | 같음 |
disk_* |
같은 노드끼리 같음 | 같음 |
제출 경로에서 GPU를 전부 보려면 전 rank가 수집하는 것 외에 방법이 없다. 한 프로세스가 1장만 보기 때문이다. 반면 로컬에서는 컨테이너 격리가 없어 어느 계열도 rank마다 다르지 않다. rank를 늘려도 정보가 늘지 않고 복제만 는다. rank를 늘리는 것 자체가 정보를 늘리는 것이 아니라, 컨테이너 격리가 프로세스마다 다른 것을 보게 만들어서 늘어나는 것이다. 그래서 플랫폼 SDK는 격리가 없는 환경에서 전 워커 수집 옵션을 받아도 한 줄 안내하고 무시한다.
다만 제출 경로에도 남는 것이 있다. 같은 노드에 뜬 rank끼리는 노드 계열과 루트 파일시스템 계열이 같은 값이다. 이 중복을 어떻게 다루는지는 2편의 중복 처리에서 다룬다.
정리
pod 안에서 켠 MLflow 시스템 메트릭이 무엇을 재는지를 따라온 결과, 남는 것은 둘이다.
- 측정 위치가 값을 정한다. MLflow는 재지 않고
start_run을 부른 프로세스 안의 스레드가 psutil과 pynvml을 부르므로, 같은 코드가 베어 호스트에 있느냐 컨테이너 안에 있느냐로 값이 갈린다 - 컨테이너 격리는 “보이는 것”과 “쓸 수 있는 것”이 따로다. namespace는 자원 종류별로 감싸고
/proc/stat·/proc/meminfo는 어디에도 속하지 않는다. 한도는 cgroup에 있고 psutil은 그것을 읽지 않는다. 그래서system/하나의 접두 아래 노드·컨테이너 루트 파일시스템·pod·장치 네 범위가 섞인다
이 위에서 플랫폼이 한 일, 즉 노드를 재는 계열에 node_·rootfs_ 접두를 붙이고 cgroup 한도 대비 working set을 재는 container_ 계열을 더한 설계와 구현은 2편에서 다룬다. 이 문제가 MLflow만의 것이 아니라는 것과 다른 도구·언어 런타임의 대응은 3편에서 다룬다. 이 글의 실측 중 GPU 격리의 기제는 호스트에서 NVML을 직접 불러 확인한 것이다.
참고 자료
- MLflow System Metrics — 활성화 방법, 샘플링 주기, 추가 의존성
- MLflow 원본 코드 v3.15.1 —
system_metrics_monitor.py,metrics/cpu_monitor.py,metrics/gpu_monitor.py,tracking/fluent.py - W&B System Metrics — 수집 주기와 지표 정의
- Fabio Kung, Memory inside Linux containers (2014)
- lxc/lxcfs —
/proc파일을 cgroup 값으로 덮어쓰는 FUSE 파일시스템 - Alibaba Cloud, Using LXCFS to Improve Container Resource Visibility
- Linux cgroup v2 admin guide —
memory.current,memory.max,memory.stat,cpu.max,cpu.stat - Kubernetes, Node-pressure Eviction — working set 정의
- Lightning MLFlowLogger, Hugging Face MLflowCallback, Ray
setup_mlflow— 셋 다 rank 0만 run을 만든다 - MLflow
tracking/fluent.pyv3.15.1 —MLFLOW_RUN_ID부착,ActiveRun.__exit__의 FAILED, atexit의end_run - namespaces(7)
- LKML, meminfo: show /proc/meminfo base on container’s memcg (2012) (미러)
- Everything is a File 철학
- 디바이스 드라이버: 3계층 구조
- Pod CPU Limit과 FFmpeg Thread 최적 조정 - 2. 배경지식: cgroup, 컨테이너, 쿠버네티스
- 컨테이너 파일 시스템
- 컨테이너 네트워킹 기본 원리: 네임스페이스 네트워킹
- NVIDIA Device Plugin 동작 원리
- NCCL Communicator 초기화 시점: Lazy vs Eager Init
- 2편: [MLflow] 시스템 메트릭 로깅 - 2. 플랫폼 SDK에 얹기: 이름, cgroup 수집기, 원본 무수정 확장
- 3편: [MLflow] 시스템 메트릭 로깅 - 3. 다른 도구와 런타임의 컨테이너 대응
댓글남기기