[MLOps] 머신러닝 플랫폼 엔지니어링: MLflow와 Feast - 4.1.1. 들어가며: 비전 AI 데이터와 플라이휠 관점에서 본 MLOps 도구
서종호(가시다)님의 Machine Learning Platform Engineering Study 2주차 학습 내용을 기반으로 합니다.
TL;DR
- 2주차는 책 4장의 MLflow(실험 추적·모델 레지스트리)와 Feast(피처 저장소), 5장의 Kubeflow Pipelines(KFP)를 다룬다. 1주차에 만든 실행·배포 기반 위에서, 무엇을 어떤 데이터로 학습했고 어느 모델을 쓰기로 했는지를 남기는 층이다
- MLOps는 DevOps의 CI/CD에서 출발하지만 거기서 끝나지 않는다. 데이터가 바뀌면 모델이 낡으므로 다시 학습해 배포하는 지속적 학습(CT)이 더해지고, 코드만이 아니라 데이터와 모델의 버전과 성능을 추적해야 한다. 결국 수집부터 배포까지 이어지는 루프 전체가 빠르고 안전하게 돌아야 하고, 이 루프를 데이터 플라이휠이라고 부른다
- 학습 플랫폼을 운영하는 자리에서 보면 이 루프에는 사람의 판단이 꼭 끼어드는 구간이 둘 있다고 생각한다. 전처리된 데이터로 학습을 걸지 정하는 학습 트리거 구간(검증과 트리거)과 등록된 모델을 넘기는 모델 승격 구간이다. 두 구간이 자동화되지 않는 것은 도구가 없어서가 아니라, 자동화하려면 먼저 갖춰야 할 조건이 있기 때문이다
- 비전 AI 데이터에는 평균·중앙값 같은 요약 통계가 의미 없다고 느껴 왔는데, 데이터셋 논문과 현장이 실제로 측정하는 항목을 모아 보니 요약 통계가 의미 없는 것은 픽셀뿐이었다. 클래스 롱테일, 박스 크기·거리·가림, 장면·날씨·시간대·지역 커버리지, 센서 구성은 분위수와 비율로 재고, 운행 설계 영역(ODD)이 그 좌표계다. 어려움의 절반은 플랫폼에 그 메타데이터가 셀 수 있는 형태로 모여 있지 않다는 점에 있다
- MLflow는 모델 승격 구간의 재료(레지스트리·alias)까지 주고 규칙은 주지 않는다. Feast는 서빙 축의 도구라 이미지 입력 모델에는 전제가 맞지 않는다. KFP는 검증 스텝을 둘 자리이지만 캐시와 조립 무게라는 운영 조건이 붙는다
2주차 도구의 자리
책의 2부는 4장 “신뢰할 수 있는 머신러닝 시스템 설계”로 시작한다. 소득 구간을 분류하는 이진 분류기 하나를 소재로 삼아 4.1절에서 MLflow에 실험을 기록하고 모델을 등록하고, 4.2절에서 Feast에 피처를 등록해 조회하고, 5장 “머신러닝 파이프라인 오케스트레이션”에서 그 모델과 피처로 KFP 추론 파이프라인을 만든다. 1장에서 그렸던 ML 플랫폼 그림에 이 도구들을 올려놓으면 실험 추적(C), 모델 레지스트리(B), 피처 저장소(D), 파이프라인 오케스트레이션(A) 자리가 채워진다. 1주차가 “어디서 어떻게 실행하나”의 기반이었다면, 이번에는 그 위에서 무엇을 남겨야 하는지가 주제다.
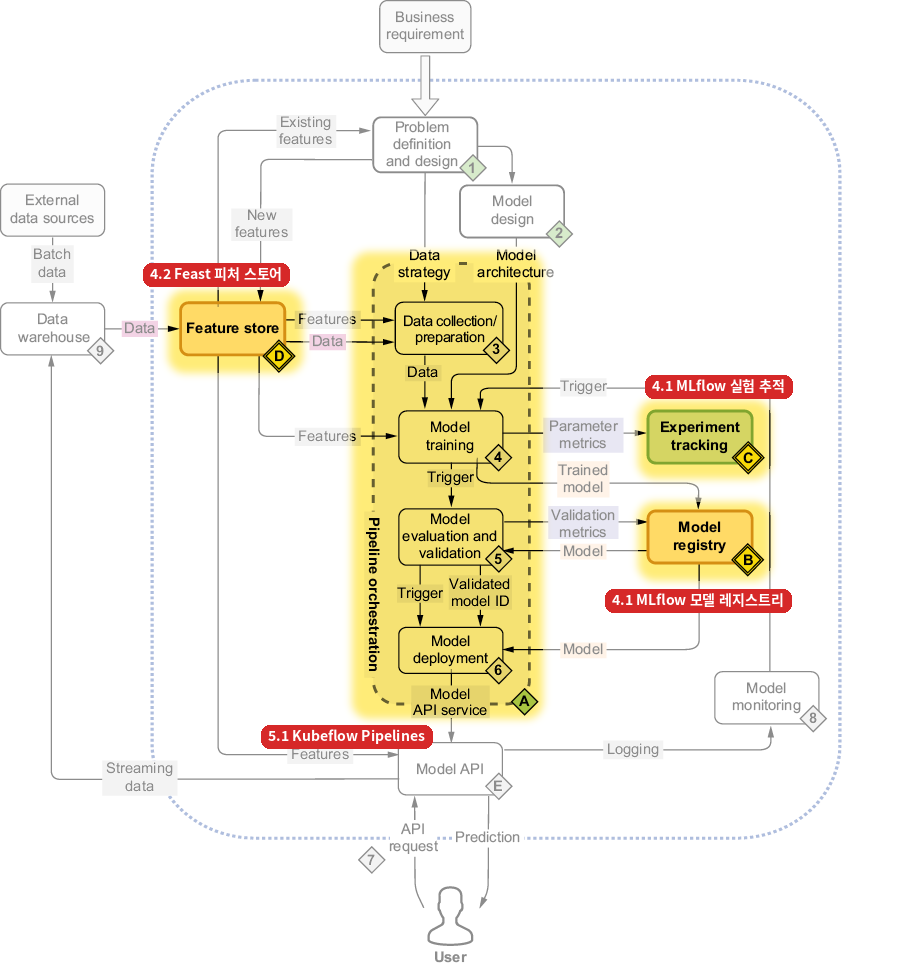
이 그림을 보면서 든 생각은 도구가 낯설지 않다는 것이었다. 나는 지금 회사에서 ML 엔지니어가 사용하는 학습 플랫폼을 만들고 운영한다. ML 엔지니어가 제출한 학습 작업을 GPU 클러스터에서 돌리고, 실험을 MLflow에 남기고, 끝난 모델을 레지스트리에 올리고, 승격하는 경로를 관리하는 자리다. MLflow는 거의 매일 보는 도구이고, 파드 안에서 잰 시스템 메트릭이 누구 것인지 가리려고 수집기를 플랫폼 SDK에 직접 얹어 보기도 했다(MLflow 시스템 메트릭 로깅 2편). Feast와 KFP도 올해 KodeKloud의 MLOps 100일 챌린지와 GenAI on K8s 시리즈를 따라가며 한 번씩 만져 봤다.
도구보다 눈에 들어온 것은 책이 전제로 두고 있는 데이터였다. 책은 CSV 한 장에 담긴 표를 다루는데, 내가 거쳐 온 데이터는 그와 사뭇 달랐다. 이전의 영상 관제 회사에서는 수백에서 수천 채널의 카메라에서 들어오는 영상을, 지금은 차량에 실린 카메라와 LiDAR가 찍은 이미지와 포인트 클라우드의 시퀀스를 주로 보게 된다. 특히 자율주행 인지 도메인에서는 그 시퀀스에 차량 위치(odometry), 센서 간 보정(calibration), 타임스탬프, 운행 설계 영역(Operational Design Domain, ODD) 태그까지 따라붙는다. 데이터 한 건이 여러 센서와 시간, 공간이 묶인 덩어리라는 점이 이 도메인을 어렵게도, 흥미롭게도 만든다.
도구 사용법을 익히는 것도 물론 중요하고, 실습 편은 책대로 도구를 따라간다. 그런데 운영 환경의 MLOps에서 먼저 부딪히는 것은 도구가 아니라 데이터다. 책의 흐름(EDA → 실험 기록 → 피처 등록 → 파이프라인)이 내 데이터에서는 어디서 갈라지는지, 그 데이터를 파악하려면 무엇이 먼저 있어야 하는지, 그리고 이 도구들 가운데 어떤 것을 어디에 쓸 수 있는지에 대한 소회를 실습에 앞서 적어 두려 한다. 환경 구성은 4.1.2편에 따로 두었다.
DevOps가 배포를 다루는 방식
데이터가 먼저라는 생각이 어디서 왔는지 되짚어 보면 MLOps라는 말 자체에서 시작한다. MLOps라는 말을 처음 들었을 때는 DevOps에 ML을 붙인 조어 정도로 받아들였다. 일을 하다 보니 그 이해로는 부족한 부분이 보였고, 이번에 문서를 다시 읽으며 그 부족함이 어디였는지 정리할 수 있었다. 직접 DevOps 엔지니어로 일해 본 적은 없지만, DevOps가 지향하는 것은 코드 변경이 사용자에게 닿기까지의 시간을 줄이면서도 실패를 줄이는 것이라고 이해하고 있다. MLOps는 분명 여기서 출발한다.
Google의 MLOps 문서는 “you can apply DevOps principles to ML systems (MLOps)”라고 쓴다. 그런데 바로 이어서 ML이 다른 점을 넷으로 든다. 개발이 실험적이고, 테스트가 더 복잡하며, 모델을 다시 학습해 배포하는 다단계 파이프라인이 필요하고, 모델은 일반 소프트웨어보다 더 많은 방식으로 낡는다(decay). 그래서 같은 문서는 CI·CD 옆에 지속적 학습(continuous training, CT)을 “a new property, unique to ML systems”로 두고, 성숙도도 수동 과정(레벨 0), 파이프라인 자동화로 CT를 수행(레벨 1), 파이프라인 자체의 CI/CD(레벨 2)로 나눈다. DevOps 원칙을 그대로 옮긴 것이 아니라 코드 배포 루프 옆에 데이터·모델 루프가 하나 더 생기는 것이고, 그 루프를 어떻게 돌릴지(전체를 다시 학습할지 점진적으로 학습할지, 무엇이 재학습을 촉발할지)가 새로 생기는 설계 변수다.
왜 루프가 하나 더 필요한가 하면 결국 데이터 때문이다. Sculley 등의 2015년 논문은 ML 시스템에서 학습·예측 코드는 아주 작은 부분이라고 하면서, 데이터 의존성이 코드 의존성보다 비싸고(3절 제목이 “Data Dependencies Cost More than Code Dependencies”다), 무엇 하나를 바꾸면 모든 것이 바뀌며(CACE, Changing Anything Changes Everything), 외부 세계가 안정적인 경우는 드물다고 적는다. 코드는 고정해 두면 그대로지만 데이터는 수집되는 순간부터 바뀐다. 그러니 ML에서 “빠르고 안전한 배포”는 코드 배포 파이프라인 하나로 끝나지 않고, 데이터가 들어와 모델이 되고 다시 데이터를 만드는 루프 전체가 빠르고 안전해야 한다는 말이 된다. 2주차 도구는 모두 이 루프의 어딘가를 기록하거나 자동화하는 도구다. 그래서 도구에 앞서, 그 루프가 내가 맡은 플랫폼에서는 어떤 단계로 돌아가는지부터 그려 봤다.
데이터 플라이휠
공개된 정의
회사에서 자주 듣는 말이 데이터 플라이휠(data flywheel)이다. 들을 때마다 머릿속에 루프 하나가 그려지기는 하는데, 그 루프의 단계가 정확히 무엇이고 내가 맡은 플랫폼이 어느 단계인지는 흐릿했다. 그래서 공개된 정의부터 찾아봤다. 데이터 엔진(data engine)이라고도 부르며, 원형은 Tesla의 Data Engine이다. Karpathy가 CVPR 2021 Workshop on Autonomous Driving 키노트(영상)에서 설명한 루프를 Dynamically Typed의 정리 글은 이렇게 옮긴다.
The loop of the Tesla Data Engine is then: (1) deploy models in ghost mode; (2) observe their predictions; (3) fine-tune triggers for collecting new training data; (4) create new unit tests out of wrong predictions; (5) add similar examples to the dataset; (6) retrain; and repeat.
같은 글은 첫 릴리스 데이터셋이 이 루프를 일곱 번 돌아 만들어졌고(“went through this shadow mode loop seven times”), 차량에서 돌아가는 트리거가 221개이며(“221 manually-implemented triggers”), 데이터셋에 “six billion labeled objects across one million 10-second videos”가 들어 있다고 적는다.
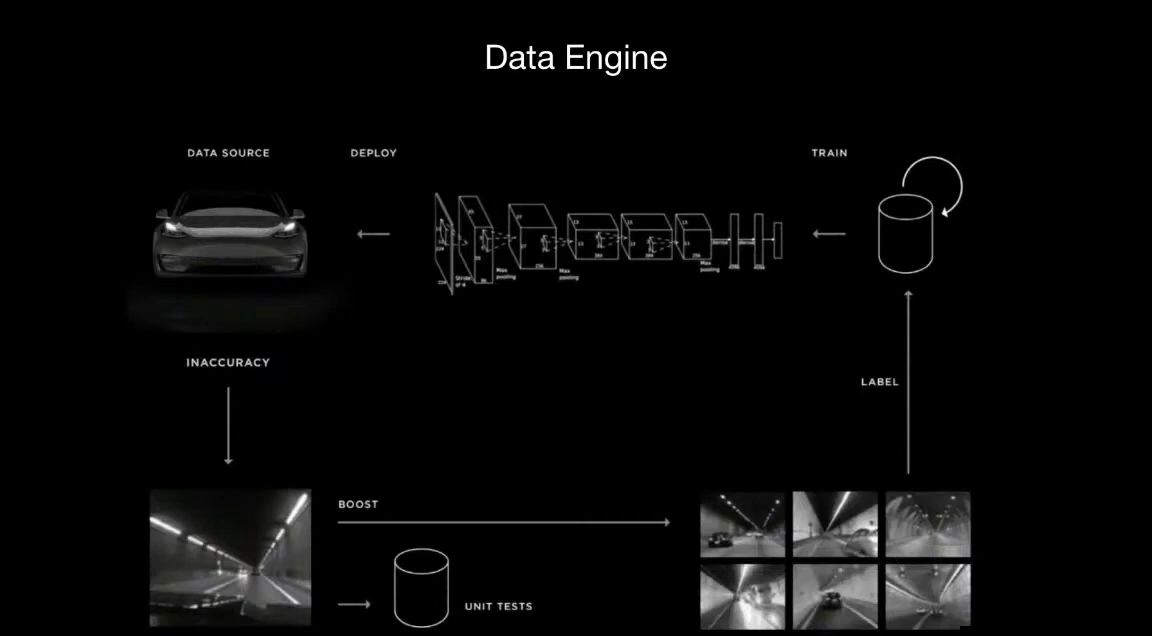
업계 용어로는 Voxel51의 용어집이 가장 간결하다. 단계를 Deploy, Mine, Curate and label, Retrain, Redeploy로 나누고 다음 두 문장으로 정의한다.
A data engine is a closed-loop process for improving models by mining production data for failures.
A data engine is a loop, not a pipeline.
NVIDIA의 정의는 더 일반적이다. LLM 에이전트 맥락의 글이지만 정의 문장은 도메인을 가리지 않는다.
A data flywheel is a self-reinforcing loop in which data from human feedback, real-world, and AI interactions continuously enhances the system, enabling it to adapt and refine decision-making.
정의를 읽고 나니 각 단계에서 무엇을 고르느냐가 성능을 가른다는 점이 눈에 들어왔다. Waymo의 희귀 사례 마이닝 논문은 3D 검출기의 롱테일을 개선하는 열쇠가 어려움이 아니라 희귀함이라고 쓴다.
rareness, as opposed to difficulty, is the key to data-centric improvements for 3D detectors
NVIDIA의 액티브 러닝 논문은 모델 앙상블의 불일치를 기준으로 라벨링할 데이터를 고르는 방식을 수백만 장 규모의 후보 풀에서 돌린 결과를 보고한다. 이 둘이 플라이휠에서 “mine”에 해당하는 단계이고, 데이터셋 자체를 제품으로 보는 데이터 중심 AI(data-centric AI)의 주장과 이어진다.
같은 결론을 올여름 다른 자리에서도 만났다. Superb AI가 연 연속 학습(continual learning) 온라인 세미나(AI 딥다이브 4회: 산업 AI는 어떻게 새 지식을 계속 배우는가, 2026-07-30)였다. 연속 학습은 이미 배포된 모델에 새 태스크를 순차적으로 더해 가는 학습 방식이고, 이전 지식을 잊지 않게 하는 가장 직관적인 방법은 이전 데이터 일부를 섞어 다시 학습하는 리플레이(replay)다. 발표자가 가장 큰 병목으로 꼽은 것은 학습 기법(어디를, 어떻게 학습할지)이 아니라 그 리플레이 데이터를 고르는 일이었다. 사전 학습 데이터와 새 데이터의 분포 차이를 재는 데이터 프로파일링, 한정된 비율 안에서 이전 태스크를 대표하는 샘플을 고르는 큐레이션, 그걸 가능하게 하는 데이터 리니지가 필요하다는 말이었다. 어떤 데이터가 효과적인지 판별하는 지표와 리플레이 비율을 어떻게 정하는지 질문했더니, 도메인 차이가 작으면 새 데이터 대비 5% 안팎에서 시작해 차이가 클수록 비율을 키우고, 클래스별 평균 임베딩에 가까운 샘플을 고른다는 답이 돌아왔다. 플라이휠의 mine과 curate 단계가 연속 학습에서는 리플레이 셋 구성이라는 이름으로 다시 나타난 셈이고, 그때 메모 끝에 적어 둔 것도 “결국 데이터다. MLOps는 뭘 해야 하나”였다.
현장의 루프와 사람이 잇는 두 구간
이 정의를 내가 일하는 자리에 적용해 보면 어떻게 될까. 자율주행 인지 모델의 루프를 그려 보면 이렇다. 차량이 주행하며 데이터를 수집하고, 반입된 데이터는 센서 동기화·위치 추정·샘플링 같은 전처리를 거쳐 ODD 태그가 붙고, 자동 라벨과 선별을 지나 사람이 라벨링하고, 학습하고, 평가하고, 차량에 배포된다. 배포된 모델이 약한 장면이 다음 수집 요구가 되면 루프가 닫힌다.
flowchart LR
  %% 자율주행 인지 모델의 데이터 루프. 점선은 사람이 잇는 구간
  A[차량 수집] --> B[반입과 전처리]
  B --> C[자동 라벨과 선별]
  C --> D[사람 라벨링]
  D -.->|학습 트리거 구간: 검증과 트리거| E[학습]
  E --> F[실험 기록과 모델 등록]
  F -.->|모델 승격 구간: 승격 기준| G[평가와 배포]
  G -.->|약한 장면의 수집 요구| A
그려 놓고 보니 앞단은 자동으로 잘 돌아갈 수 있는 구간이라고 생각한다. 수집, 전처리, 자동 라벨, 라벨링, 대규모 평가는 각각 파이프라인과 도구로 받칠 수 있는 일이다. 내가 보기에 사람의 판단이 꼭 끼어드는 구간은 둘이다.
첫째는 데이터에서 학습으로 넘어가는 구간이다. 이 글에서는 학습 트리거 구간이라고 부른다. 학습을 언제 걸지는 결국 사람이 정하게 된다고 생각한다. 자동으로 걸려면 조건이 둘 필요한데, 비전 AI에서는 둘 다 쉽게 갖춰지지 않는다. 하나는 신호다. 차량에 올라간 모델이 온라인 서빙이 아니면 “이 장면에서 인식이 흔들린다”는 drift 신호가 실시간으로 올라오지 않고, “데이터가 이만큼 쌓였다”를 조건으로 삼기도 어렵다. 다른 하나는 데이터 자체다. 전처리 파이프라인이 십수 단계여도 그걸 통과한 데이터에 센서 보정이 어긋나거나, 카메라와 LiDAR의 타임스탬프가 맞지 않거나, odometry가 비어 있는 시퀀스가 섞일 수 있다. 그래서 ML 엔지니어가 학습 전에 데이터를 직접 확인하는 일이 사라지지 않는다. 이 확인을 건너뛰면 문제가 모델 품질로 새어 나가고, 결국 이슈로 돌아온다. 자동 트리거는 이 확인이 코드가 된 뒤에야 가능하다고 본다.
신호 쪽은 Tesla를 떠올리게 된다. 개인적인 생각이지만, 일론 머스크가 정말 잘한 일은 모델이 아니라 차량 자체를 데이터를 모아 올리는 플랫폼으로 만들어 둔 것이라고 본다. 도로 위의 차 한 대 한 대가 수집기이고, 틀린 장면을 트리거로 걸어 올려 보내는 구조가 처음부터 설계에 들어 있다. 여기에 SpaceX의 위성 인터넷 Starlink까지 쥐고 있으니, 차가 언제 어디에 있든 신호가 올라오는 루프를 상상하게 된다. 플랫폼을 만드는 입장에서는 그 설계가 모델 성능보다 더 대단해 보인다.
둘째는 등록된 모델을 승격하는 구간이다. 이 글에서는 모델 승격 구간이라고 부른다. 학습이 끝나면 MLflow에 run이 기록되고 모델이 레지스트리에 등록되며 지표가 가장 좋은 모델에 표시가 붙는 데까지는 도구가 해 준다. 그 모델을 “이제 이걸 쓴다”로 넘기는 승격과 배포는 도구가 아니라 기준의 문제라고 생각한다. 어떤 지표를, 어떤 평가셋에서, 이전 모델과 어떻게 비교해 넘길지가 먼저 정의돼야 하고, 그 정의가 없는 동안은 사람이 판단할 수밖에 없다.
공개 사례도 같은 순서로 만들어졌다는 점이 위안이기도 했다. 앞에서 인용한 Tesla의 루프도 첫 릴리스 데이터셋이 shadow mode 루프를 여러 번 돌아 만들어졌고 트리거는 손으로 구현했다고 하니, 루프를 닫는 쪽(배포된 모델의 실패를 신호로 되먹이는 쪽)이 가장 나중에, 가장 많은 수작업으로 만들어진다. 플라이휠을 빠르게 만드는 지표를 데이터 생성량이 아니라 루프 한 바퀴의 소요 시간과 그 바퀴가 만든 성능 개선으로 두는 이유도 여기 있다. 2주차 도구가 이 두 구간에 무엇을 주는지는 뒤에서 정리한다.
비전 AI 데이터에서의 EDA
실무에서의 학습 데이터 검토 경험
학습 트리거 구간의 “ML 엔지니어가 직접 확인한다”가 사실 책이 말하는 탐색적 데이터 분석(Exploratory Data Analysis, EDA)이다. 책 4.1.1절은 소득 데이터의 열마다 분포를 그리고 범주형 변수를 더미 변수로 바꾸는 것으로 EDA를 시작한다. ML을 처음 배울 때도 EDA가 중요하다는 말을 많이 들었고, 모델을 학습시킬 때는 garbage in, garbage out이니 학습 데이터를 잘 봐야 한다는 것도 알고 있다.
그런데 내가 두 회사에서 본 EDA는 이번 주차 스터디의 책에서 볼 수 있는 그것과 꽤 달랐다. 이전 환경에서는 Label Studio에서 라벨 전 이미지를 넘겨 보거나 MinIO에 수집된 원본을 열어 봤고, 지금 환경에서는 사내 라벨링 도구에서 라벨을 덧그려 보거나 데이터 엔지니어링·운행 설계 쪽에서 전달된 원본 시퀀스를 직접 열어 무엇이 문제인지 본다. 두 환경의 공통점은 셋이었다. 결국 이미지를 하나하나 열어 보게 되고, 픽셀에 평균이나 중앙값 같은 요약 통계를 내는 것이 의미가 없으며, 그나마 셀 수 있는 것은 언제 어디서 어떤 카메라로 찍혔는지 같은 메타데이터뿐이라는 것이다.
그래서 플랫폼을 만드는 입장에서 바랐던 것도 분명했다. 데이터가 쌓여 학습이 걸리는 시점에 “이번 데이터는 어떤 장면 구성이고, 분포가 지난번과 어떻게 다르며, 이상치는 무엇이니 어떻게 처리할지”를 ML 엔지니어에게 제공하고 싶었다. 특히 센서 보정 파라미터가 빠진 시퀀스, 카메라와 LiDAR 타임스탬프가 어긋난 구간, odometry가 누락된 프레임과 같이, 지금은 엔지니어와 라벨러가 눈으로 거르는 것들을 플랫폼이 먼저 잡아 주면 좋겠다고 생각했다. 그런데 막상 만들려고 하면, 눈으로 거르던 기준을 어떤 수치와 조건으로 적어야 할지부터 막혔다. 그래서 비전 데이터는 EDA를 정량화하거나 자동화하기 어렵다고 느꼈다. 다만 그것이 비전만의 문제인지, 비정형 데이터 전반의 문제인지, 아니면 내가 데이터를 덜 알아서인지는 알 수 없었다. 힌트를 두 군데에서 찾았다. 자율주행 데이터셋 논문이 통계 절에서 보고하는 항목과, 현장에서 실제로 재고 있는 항목이다.
데이터셋 논문과 현장의 측정 항목
먼저 논문 쪽이다. nuScenes는 수집 지역별 비율(보스턴 55%, 싱가포르 세 지역 45%), 비 19.4%·야간 11.6%, 클래스 불균형(최소 클래스 대 최다 클래스 1:10k), 자차 거리별 박스 분포, 거리별 LiDAR 포인트 수를 그린다. Waymo Open Dataset은 도시별 장면 수와 낮·밤·새벽 분포에 더해 자차 궤적을 150m로 넓힌 영역의 합집합 면적을 지리 커버리지 지표로 정의한다. BDD100K는 인스턴스의 절반이 가려져 있다고 쓰고, 날씨·장면·시간대 분포와 박스 크기 누적분포를 보인다.
세 논문이 공통으로 재는 축을 모으면 다음과 같다.
| 축 | 예 |
|---|---|
| 클래스 분포와 롱테일 | 클래스별 인스턴스 수, 최소·최다 클래스 비율 |
| 객체 기하 | 박스 크기, 자차와의 거리, 가림·잘림 비율 |
| 장면 커버리지 | 지역, 날씨, 시간대, 도로 유형, 지리 영역 |
| 센서 구성 | 카메라 수·해상도·화각(FOV), LiDAR 채널 수·주기 |
다음으로, 현장의 측정 항목이다. 현장의 측정 항목도 여기서 크게 벗어나지 않는다. 오히려 조금 더 깊이 들어간다. LiDAR가 섞인 3D 검출 데이터를 검토할 때 보는 것을 묶어 보면 네 가지다.
| 묶음 | 측정 항목 | 해석 |
|---|---|---|
| 센서 사양 | 채널 수와 빔 간격, 프레임당 포인트 수, 포인트가 닿는 반경의 분위수, intensity 값의 스케일 | 같은 클래스 분포라도 센서가 다르면 같은 데이터가 아니다. 스케일이 다른 데이터는 단순 정규화로 합칠 수 없다 |
| 라벨 분포 | 클래스별 정답(GT) 박스 수와 비율, GT까지의 거리 분위수와 거리 구간별 비율 | 상위 몇 클래스가 대부분을 차지하는 롱테일이 보인다. 거리 분위수를 센서의 관측 반경과 겹쳐 보면 포인트가 닿지 않는 자리에 박스가 있는지가 드러난다 |
| 라벨 생성 방식과 정책 | 관측 반경 밖의 GT 박스, 포인트가 없는 박스, 센서별 가시성 대비 라벨 유무 | 라벨을 어떻게 만들었는지(시퀀스 단위인지 프레임 단위인지)와 어떤 객체에 라벨을 달지 않았는지가 분포에 남는다. 멀티센서 모델을 학습하기 전에 확인해야 하는 축이다 |
| 결과의 슬라이스 | 데이터 출처·수집 조건·모델별로 나눈 미검출과 오검출 | 한 슬라이스에만 오류가 몰리면 그 조건이 곧 분포 축이다. 합산 지표는 이런 실패를 숨긴다 |
참고: 분위수와 꼬리 표의 분위수(percentile)는 값을 작은 순서로 늘어놓았을 때 50%, 90%, 99% 지점의 값(p50·p90·p99)이고, p50이 중앙값이다. p95나 p99 너머 최댓값까지의 구간이 꼬리(tail)이고, 클래스 분포처럼 빈도가 낮은 항목이 길게 이어지는 모양을 롱테일(long tail)이라고 부른다.
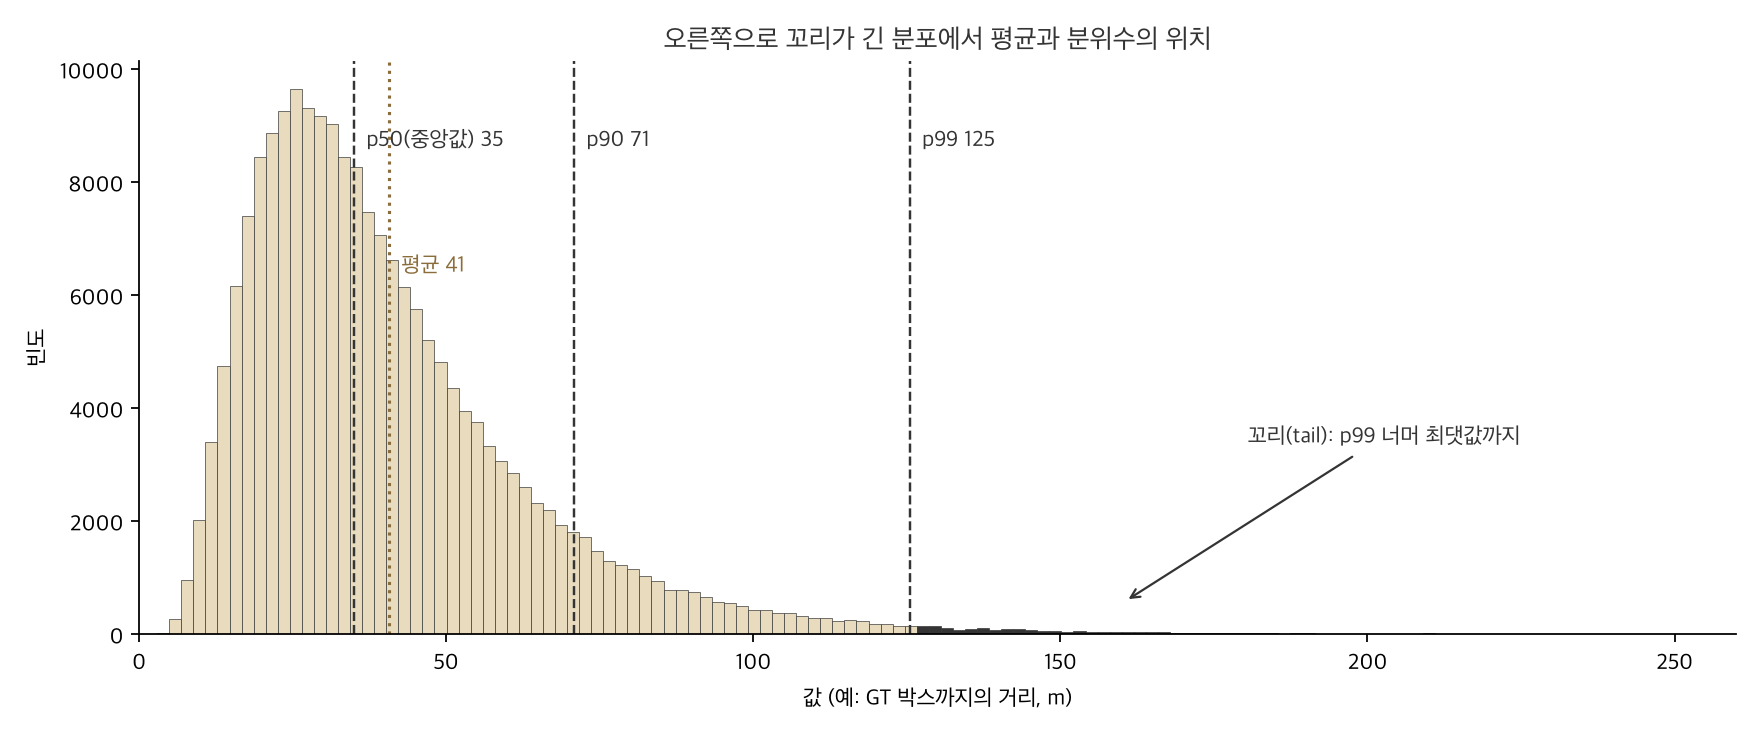
평균 하나로는 이 꼬리가 보이지 않는다. GT 거리가 평균 40m라는 말보다 p99가 관측 반경 밖에 있다는 말이 라벨의 문제를 드러내고, 클래스 비율이 평균적으로 고르다는 말보다 하위 열 종이 합쳐서 몇 % 안 된다는 말이 학습이 안 되는 이유를 드러낸다. 현장에서 분위수와 꼬리를 먼저 보는 이유다.
외부 데이터셋을 들여올 때도 유사한 종류의 검사를 먼저 한다. 센서 구성과 샘플링 주기, 센서와 라벨의 시각 정합, 클래스 체계를 자기 체계로 매핑하는 표를 만든 뒤 시퀀스를 전수로 훑어 이상한 것을 거른다. 보유 데이터에도 어느 구간에 어떤 메타데이터가 비어 있는지 결손 메모가 붙는다.
이 네 묶음은 공개 데이터셋 논문이 이미 같은 방식으로 다루는 축이다. nuScenes는 LiDAR나 레이더 포인트가 하나 이상 닿는 객체만 라벨링하고 가시성(visibility)을 속성으로 달며 거리별 라벨 밀도와 클래스 불균형을 보고하고, Waymo는 포인트가 없는 3D 라벨을 평가에서 제외하고 포인트 수로 난이도 등급을 나누며 결과를 거리 구간(0~30m, 30~50m, 50m 이상)별로 쪼개고, BDD100K는 가림·잘림 비율을 보고한다. 센서 구성과 수집 지역이 다른 데이터셋 사이의 성능 차이는 Train in Germany, Test in the USA(CVPR 2020)가 지역별 차량 크기 차이를 주된 원인으로 짚어 다룬다.
비전 EDA의 재해석
이 목록을 보고 나서 “비전 데이터는 정량화가 어렵다”던 내 생각이 틀렸다고 판단했다. 어려운 것이 아니라 아직 자동화되지 않았을 뿐이었다. 값은 전부 분위수와 비율과 유무로 잴 수 있고, 실제로 재고 있다. 다만 그 계산이 사람이 그때그때 돌리는 스크립트와 손으로 적는 표에 있지, 데이터가 들어올 때마다 자동으로 도는 단계에 있지 않을 뿐이다. 평균과 중앙값이 의미를 잃는 것은 픽셀이지 메타데이터와 기하가 아니었다.
남는 것은 장면 축이다. 거리나 포인트 수는 분위수로 재면 되지만, 장면·날씨·시간대·도로 유형은 수치가 아니라 범주라서, 어떤 장면이 얼마나 있는지를 세려면 범주의 체계가 먼저 있어야 한다. 자율주행에서는 그 체계가 앞에서 데이터에 따라붙는 태그로 언급한 운행 설계 영역(ODD)이다. ODD는 SAE J3016이 정의한 자율주행의 일반 용어로, 시스템이 동작하도록 설계된 조건(도로·환경·지리·시간대·교통 특성)의 집합이다. ISO 34503은 그 조건을 적는 방법을 도로·구조물 같은 정적 요소(scenery), 날씨·조명 같은 환경 조건(environmental conditions), 교통 참여자 같은 동적 요소(dynamic elements) 세 범주로 명세한다. “이 데이터가 운행 설계의 어느 장면에 해당하는지”라는, 내가 답하기 어렵다고 느꼈던 질문은 ODD 속성의 조합으로 쓰면 셀 수 있는 질문이 된다. 수집 계획은 “보유 데이터에 없는 조합”으로, 선별은 “조합별 비율 맞추기”로 정의된다. 표 데이터의 group-by가 여기서는 ODD 속성 조합의 AND·OR 분해다.
EDA를 도구와 플랫폼으로 옮기면
도구들의 세 층
책 4.1.1절의 EDA 노트북이 하는 일은 describe와 히스토그램이다. 비전 데이터에서 그 자리에 무엇이 오는지는 업계 도구들이 이 일을 어떻게 나눠 놓았는지를 보면 드러난다. FiftyOne Brain, Lightly, Encord Active, Scale Nucleus, Cleanlab Datalab의 문서를 나란히 놓아 보니 세 층으로 나뉘었다. 이 구분은 어느 한 문서의 명제가 아니라 도구 설명을 기반으로 추론한 것이다.
| 층 | 대상 | 답하는 질문 |
|---|---|---|
| 메타데이터 통계 | 태그·박스·센서 메타의 분포 | 어떤 장면이 얼마나 있나, 빠진 조합은 무엇인가 |
| 임베딩 | 이미지 임베딩의 유사도·클러스터·중복·outlier | 비슷한 장면이 몇 벌인가, 동떨어진 샘플은 무엇인가 |
| 모델 점수 | 라벨 오류 추정(mistakenness), 난이도(hardness), 앙상블 불일치 | 라벨이 틀렸을 가능성이 높은 것, 모델이 못 보는 것은 무엇인가 |
표 데이터의 describe가 대체하는 것은 첫 층뿐이다. 둘째·셋째 층은 픽셀을 직접 요약하는 대신 임베딩 모델이나 학습 중인 모델을 통과시킨 값으로 본다. 내가 “픽셀에는 통계가 의미 없다”고 느낀 것은 맞았지만, 그 대신 무엇을 통계의 대상으로 삼는지를 몰랐던 것이다.
텍스트는 더 쉬운가
앞에서 이것이 비전만의 문제인지 비정형 데이터 전반의 문제인지 물었다. 책의 뒤쪽 장이 표 데이터에서 LLM으로 넘어가기도 해서, LLM을 학습시킬 텍스트라면 글자니까 조금 낫지 않을까 하는 생각도 했었다. 큐레이션 논문들을 보니 반은 맞다. FineWeb은 문서 길이·반복률·구두점 비율 같은 50여 개 문서 통계의 히스토그램이 고품질·저품질 코퍼스에서 갈라지는 지점으로 필터 임계값을 정했고, What's In My Big Data?는 세기(count)와 찾기(search) 두 연산만으로 대형 코퍼스의 중복과 벤치마크 오염을 드러냈다. 텍스트는 문서에서 열을 뽑아 히스토그램을 그릴 수 있어 표 EDA 기법이 상당 부분 옮겨 간다. 반면 이미지·텍스트 쌍 데이터셋 설계를 다룬 DataComp의 최고 성능 필터는 CLIP 점수와 이미지 기반 필터의 교집합이었다. 이미지는 모델 점수 없이는 내용 기반 필터가 사실상 어렵다. 텍스트와 이미지의 탐색 난이도를 직접 비교한 논문은 찾지 못했고, 이 판단은 양쪽 큐레이션 논문이 쓰는 도구의 차이에서 추론한 것이다.
플랫폼이 할 수 있는 일
여기까지 모으고 나니 “비전 데이터는 EDA를 어떻게 해야 할지 모르겠다”는 질문이 둘로 갈라졌다. 어떤 수치를 봐야 하는지는 ML 엔지니어와 도메인의 몫이고, 그 수치를 잴 수 있게 만드는 것은 플랫폼의 몫이다. 후자가 내 자리다. 책의 노트북은 EDA를 한 사람이 한 번 돌리는 셀로 두지만, 운영 환경의 플랫폼 쪽에서 할 일은 셋이다.
- 메타데이터를 셀 수 있는 형태로 모은다. 센서 스펙, 타임스탬프, odometry, calibration 파라미터, ODD 태그가 주행 세션 단위의 요약표와 이벤트 단위의 타임스탬프 로그로 나뉘어 있으면, 복합 조건(비 오는 야간의 젖은 노면)은 세션 요약에 세 값이 다 있다고 만족되지 않고 이벤트의 시간 구간이 겹쳐야 한다. 조회 가능한 저장소에 프레임 단위로 들어가야 group-by가 된다
- 검증을 파이프라인의 스텝으로 옮긴다. 센서와 라벨의 시각 정합, odometry 결측, calibration 파라미터 유무, 센서별 가시성 대비 라벨 유무 같은 항목은 지금 사람이 전수 스캔으로 거르지만 전부 규칙으로 쓸 수 있다. 표 데이터의 스키마·결측 검증에 해당한다
- 분포 요약을 학습 기록에 붙인다. 학습이 걸릴 때 그 데이터셋의 클래스·거리·장면 분포와 검증 결과를 실험 기록에 남기면, 나중에 “이 모델은 어떤 데이터로 학습됐나”에 답할 수 있고 다음 학습과 비교할 수 있다
이 세 가지가 갖춰져야 학습 트리거 구간이 사람 손을 떠날 수 있다. 책의 EDA 노트북은 이 가운데 세 번째의 가장 작은 형태라고 보면 된다.
세 도구의 역할과 한계
MLflow
MLflow는 모델 승격 구간의 재료를 준다. run마다 파라미터·지표·아티팩트가 남고, 모델 레지스트리에 버전이 쌓이며, alias로 “지금 쓰는 모델”을 가리킬 수 있다. 승격은 alias를 옮기는 일이 된다. Stage에서 alias로 넘어온 경위와 champion·challenger 패턴은 GenAI on K8s 11.3에 정리돼 있다. 운영하는 입장에서 하나 더 좋아하는 점은 tracking 서버가 아티팩트 저장소의 프록시 역할을 할 수 있다는 점이다. 학습 노드와 서빙 노드에 객체 저장소 자격 증명을 뿌리지 않고 서버 한 곳에만 두면 된다.
못 주는 것은 승격 규칙이다. 어떤 지표를 어느 평가셋에서 이전 모델과 비교할지, 지표 하나가 아니라 가드레일 지표 묶음을 볼지, 같은 데이터로 비교했는지, 롤백용 alias를 둘지, 승격 근거를 태그로 남길지는 MLflow 밖에서 정해야 한다. 100일 챌린지 때 이 체크리스트를 정리해 둔 적이 있는데, 그때는 표 데이터의 사기 탐지 모델이 소재였고 평가셋이 하나였다. 비전 모델에서는 평가셋을 출처별(실데이터·합성, 지역, 시간대)로 쪼개야 합산 지표가 숨기는 슬라이스 실패가 보이므로 규칙이 더 길어질 것이다.
4.1절 실습에서 보고 싶은 것은 MLflow 3의 모델 등록 경로(run 기준이 아니라 logged model 기준)와, 노트북이 남기는 데이터셋 정보가 “어떤 데이터로 학습했나”에 얼마나 답하는지다.
Feast
Feast는 2주차에서 가장 결이 다른 도구다. 100일 챌린지에서 Feast를 만졌을 때 와닿지 않았던 이유를 적어 둔 적이 있다. 내가 해 온 MLOps는 학습 생산성 쪽이었다. 실험 재현성, 처리량, 연구자 생산성을 최적화하고, 데이터는 parquet을 배치로 한 번에 읽는다. 피처 저장소는 만든 모델을 실시간으로 굴리는 서빙 쪽에 있다. 지연 시간과 가용성을 최적화하고, 엔티티 키 하나로 단건을 빠르게 조회한다. Feast 문서도 자신을 “ML platform/MLOps teams with DevOps experience”가 실시간 모델을 프로덕션화하도록 돕는 도구로 소개하고, 가치를 학습과 서빙에 같은 피처를 일관되게 제공하는 것과 시점 정합(point-in-time) 조인으로 데이터 누수를 막는 것에 둔다.
이미지 입력 모델에는 이 전제가 성립하지 않는다. 피처 저장소는 “엔티티마다 시간에 따라 바뀌는 피처 표”가 있어야 하는데, 인지 모델의 입력은 프레임 자체다. Feast 문서에서 이미지가 등장하는 곳은 CLIP 임베딩을 벡터 저장소에 넣는 GenAI 절뿐이다. 그렇다고 배울 이유가 없다는 것은 아니다. 플라이휠의 학습 트리거 구간에서 “프레임 단위 메타데이터를 조회 가능한 저장소에 둔다”는 요구는 피처 저장소의 오프라인 저장소와 레지스트리가 푸는 문제와 닮았고, 차량 상태나 주행 맥락처럼 엔티티 키(차량, 도로 구간)로 조회할 값이 생기면 서빙 축의 도구가 필요해진다. 4.2절 실습은 이 도구가 무엇을 전제하는지를 확인하는 자리로 삼으려 한다.
Kubeflow Pipelines
KFP는 학습 트리거 구간의 검증 스텝을 둘 자리다. 5장 실습은 데이터 읽기, 피처 조회, 추론, 쓰기를 컴포넌트로 나눠 잇는 추론 파이프라인이지만, 같은 구조를 학습 파이프라인 앞에 두고 검증 스텝 하나를 더 넣으면 “통과하지 못하면 학습하지 않는다”가 코드가 된다. 다만 운영 조건이 둘 붙는다.
하나는 캐시다. KFP는 같은 컴포넌트에 같은 입력이면 이전 결과를 재사용한다. 4.1.2편의 검증에서 같은 인자로 두 번 제출했을 때 두 번째 run에는 실행 파드가 생기지 않았다. 입력 명세는 그대로인데 원본 데이터만 바뀐 데이터 수집·검증 단계는 캐시를 꺼야 한다.
다른 하나는 무게다. 100일 챌린지 때 KFP를 보며 “Kubeflow가 굉장히 무거운데, 그 무게가 기능이 아니라 조립에서 온다”는 생각을 한 적이 있다. 실제 KFP 고유 로직은 API 서버 하나이고 나머지는 Argo Workflows, ML Metadata, MySQL과 그 접착제다. KFP가 Argo 위에 DSL과 아티팩트 추적, 메타데이터 저장소를 얹은 층이라는 관계는 GenAI on K8s 11.4에서 정리했다. 이번에 kind에 올린 standalone도 Deployment 14개였다. 이미 Argo Workflows를 운영하는 조직이라면 KFP 대신 Argo의 아카이브와 MLflow 조합이 더 가볍다는 것이 당시 판단이었고, 지금도 크게 다르지 않다. 파이프라인과 run이 CRD가 아니라 API 서버의 DB 레코드라는 점도 운영에 영향을 준다. 파이프라인 등록은 GitOps가 아니라 CI가 API를 호출하는 명령형 배포가 된다. 선언형 도구가 ML 워크로드의 어느 영역까지 맞는지는 MLOps와 GitOps에서 학습 Job을 Argo CD에 올려 보며 고민한 적이 있다.
5장 실습에서 확인하고 싶은 질문은 셋이다. 컴포넌트가 모델 레지스트리를 조회하는 경로가 파드 안에서 성립하는지, 캐시를 켠 채 데이터만 바뀌면 무슨 일이 생기는지, 그리고 이 무게가 학습 생산성 축의 플랫폼에서 무엇으로 정당화되는지다.
이 시리즈에서 확인할 것
이 글의 판단은 운영 경험과 문헌에서 나온 것이라, 남은 편의 실습에서 확인할 것을 적어 둔다.
| 편 | 확인할 것 |
|---|---|
| 4.1.2편 | kind 위 KFP standalone·SeaweedFS·MLflow 호스트 프로세스 구성. KFP 캐시 동작과 standalone의 구성 요소 수 |
| 4.1절 | MLflow 3에서 데이터셋 정보와 모델 등록이 “어떤 데이터로 학습했나”에 답하는 범위 |
| 4.2절 | Feast가 전제하는 엔티티·피처 표와 시점 정합 조인. Redis 온라인 스토어의 위치 |
| 5장 | KFP 컴포넌트에서 레지스트리와 객체 저장소에 닿는 경로. 검증 스텝을 넣을 자리와 캐시 설정 |
데이터 플라이휠의 두 구간 가운데 이 시리즈가 직접 건드리는 것은 모델 승격 구간의 재료(MLflow 레지스트리)와 학습 트리거 구간의 자리(KFP 스텝)다. 신호(drift 감지)와 승격 규칙은 도구 밖의 일이고, 책도 그 부분은 뒤의 모니터링 장에서 다룬다. drift 통계 측정과 자동 재학습 흐름의 개요는 GenAI on K8s 11.6에 정리돼 있다.
정리
이번 주차의 도구와 유스케이스를 따라가는 동안 내가 운영하는 플랫폼의 데이터가 계속 겹쳐 보였고, 거기서 나온 질문이 “비전 데이터는 EDA를 어떻게 하나”였다. 쓰고 나니 질문은 이번 주차 내용을 내 자리에서 어떻게 받아들일지로 옮겨 갔다. 책의 EDA와 피처 등록을 내 데이터에 적용하려면 두 가지가 먼저 정해져야 한다. 학습을 거는 사람이 지금 눈으로 확인하는 것 가운데 무엇을 먼저 잴 수 있게 만들 것인가, 그리고 등록된 모델을 넘기는 기준을 어떤 지표와 평가셋으로 적을 것인가. 두 질문은 플라이휠에서 사람의 판단이 끼어드는 두 구간과 그대로 겹친다. 픽셀에는 요약 통계가 의미 없지만 메타데이터와 기하에는 적용되고, 그 값을 잴 수 있게 모으는 일이 학습 트리거 구간의 전제라는 것이 이 글에서 확인한 내용이다.
2주차 도구는 그 판단을 기록하고 실행할 자리를 준다. MLflow는 승격의 재료를, KFP는 검증 스텝의 자리를, Feast는 “어떤 전제가 성립해야 피처 저장소가 의미를 갖는가”라는 대조군을 준다. 판단 자체는 도구에 들어 있지 않으니 데이터를 보는 사람과 플랫폼을 만드는 사람이 같이 적어야 한다. 환경 구성에서 겪은 것은 4.1.2편에 있고, 다음 편부터는 책의 노트북과 파이프라인을 따라가며 그 자리가 실제로 어떻게 생겼는지 확인한다.
참고 링크
- Machine Learning Platform Engineering — Manning
- 머신러닝 플랫폼 엔지니어링 — 책만
- MLOps: Continuous delivery and automation pipelines in machine learning — Google Cloud
- Hidden Technical Debt in Machine Learning Systems — Sculley et al., NeurIPS 2015
- Karpathy의 CVPR 2021 Workshop on Autonomous Driving 키노트 영상 · 강연 정리 — Dynamically Typed
- Data engine — Voxel51 Glossary
- AI 딥다이브 4회: 산업 AI는 어떻게 새 지식을 계속 배우는가 — Superb AI
- Maximize AI Agent Performance with Data Flywheels — NVIDIA Developer Blog
- Improving the Intra-class Long-tail in 3D Detection via Rare Example Mining — Waymo
- Scalable Active Learning for Object Detection — NVIDIA
- nuScenes · Waymo Open Dataset · BDD100K
- ISO 34503:2023 — Specification for operational design domain
- FiftyOne Brain · Lightly selection · Encord Active · Scale Nucleus · Cleanlab Datalab
- FineWeb · What's In My Big Data? · DataComp
- Feast 문서 · Feast GenAI(벡터 저장소)
댓글남기기