[Kubernetes] 쿠버네티스 스케줄링 - 2. 프로세스와 선점
Kubernetes › 스케줄링·MLOps › 자원 관리·스케줄링·개념
시리즈 · 쿠버네티스 스케줄링 (3 / 7)·← 이전 편·다음 편 →
TL;DR
- 스케줄러는 3개의 큐(Active / Backoff / Unschedulable)로 파드를 관리하며, Active Queue에 있는 파드만 스케줄링을 시도한다.
- 파드 하나의 처리는 Scheduling Cycle과 Binding Cycle로 나뉜다(1편 - Scheduling Framework). 정상 경로의 extension point 순서는 PreEnqueue → QueueSort → PreFilter → Filter → PreScore → Score → NormalizeScore → Reserve → Permit → PreBind → Bind → PostBind이며, PostFilter는 이 순서에 끼어 있는 단계가 아니라 PreFilter에서 파드가 거절되었거나 Filter에서 모든 노드가 탈락했을 때만 분기하는 실패 경로다.
- Filter는 부적합 노드를 탈락시키고(리소스, 배치 규칙, 볼륨 등), Score는 통과 노드에 점수를 매겨 NormalizeScore로 0~100에 맞춘 뒤 가중 합산하여 최적 노드를 선택한다. 필터링에서 적합 노드가 하나뿐이면 Score 단계(PreScore 포함)를 건너뛰고 그 노드를 바로 선택한다.
- 하나의 플러그인이 여러 extension point에 등록될 수 있다. v1.32 기준
NodeResourcesFit과NodeAffinity는 PreFilter·Filter·PreScore·Score 네 곳,VolumeBinding은 여섯 곳에 등록된다. - 큐의 재시도 효율화를 위해 EnqueueExtension과 QueueingHint가 2단계 필터링으로 동작한다. 플러그인이 “의미 있는 이벤트”를 선언하고, 콜백 함수가 구체적 이벤트 인스턴스의 관련성을 판단하여 불필요한 재시도를 최소화한다.
- 선점(Preemption): 모든 노드가 부적합할 때, PostFilter 단계에서 낮은 우선순위 파드를 축출하여 공간을 확보한다. 선점이 동작하려면
PriorityClass가 정의되어 있어야 한다. 선점은 victim을 Delete API로 삭제하는 것이므로PodDisruptionBudget은 best-effort로만 존중된다. nominatedNodeName은 선점 후 다른 파드가 해당 공간에 끼어드는 것을 방지하는 예약 마커다. 스케줄러는 다음 사이클에서 이 노드를 가장 먼저 시도하지만, 해당 노드에 반드시 스케줄링된다는 보장은 없다.
들어가며
1편에서 스케줄링의 기본 개념, 스케줄링 대상, 그리고 kube-scheduler를 이루는 Scheduling Framework·플러그인·프로필의 관계를 알아보았다. 이번 글에서는 그 구조 위에서 파드 하나가 실제로 처리되는 순서를 따라간다.
- 스케줄러 큐: 3개 큐(Active / Backoff / Unschedulable)의 역할과 파드 이동 메커니즘
- 전체 Extension Point: Scheduling Cycle과 Binding Cycle의 모든 extension point와 각 단계의 역할, 큐 재시도 메커니즘(EnqueueExtension, QueueingHint)
- 스케줄링 플러그인: 각 extension point에 등록되는 기본 플러그인(v1.32 기준) 목록과 동작 원리
- 선점 메커니즘: PriorityClass 기반의 선점이 동작하는 방식, 내부 동작 순서,
nominatedNodeName의 역할과 한계
스케줄러가 어떤 단계를 거쳐 노드를 선택하는지, 모든 노드가 부적합할 때 어떻게 선점이 동작하는지를 이해하면, 파드가 Pending 상태에 빠졌을 때 원인을 빠르게 좁혀 나갈 수 있다. 실제 파드에서 실패 지점을 확인하는 절차는 6편 - 스케줄링 실패 진단에서 다룬다.
스케줄링 프로세스
kube-scheduler는 Scheduling Framework라는 플러그인 기반 아키텍처로 동작한다. 프레임워크는 여러 extension point를 정의하고, 각 extension point에 플러그인을 등록하여 스케줄링 로직을 구성한다. 하나의 플러그인이 여러 extension point에 동시에 등록될 수 있다. 프레임워크·플러그인·프로필의 관계와 설계 배경은 1편 - kube-scheduler 구조에서 다뤘다. 여기서는 파드가 큐에 들어와 바인딩되기까지를 순서대로 따라간다.
스케줄러 큐
스케줄러는 내부적으로 3개의 큐를 운영하며, Active Queue에 있는 파드만 꺼내서 스케줄링을 시도한다. 큐 관리 자체도 스케줄러가 담당한다. 스케줄러 내부의 Scheduling Queue 컴포넌트가 새 파드 감지(Watch), 타이머 기반 Backoff Queue 확인, 클러스터 이벤트에 따른 Unschedulable Queue 처리, 스케줄링 실패 시 적절한 큐로의 이동 등을 모두 수행한다.
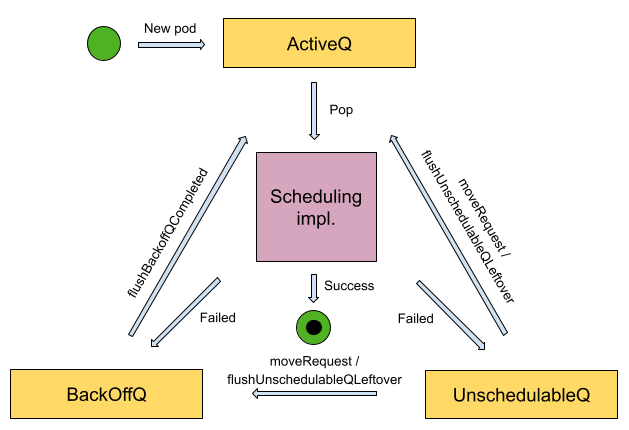
| 큐 | 자료구조 | 역할 | 주로 관측되는 실패 | Active Queue 복귀 조건 |
|---|---|---|---|---|
| Active Queue | Heap (우선순위 순) | 즉시 스케줄링을 시도할 파드 | - | - |
| Backoff Queue | Heap (백오프 만료 시각 순) | 짧은 간격으로 재시도할 파드 | 바인딩 실패, 내부 오류, 백오프가 남은 상태에서의 이벤트 복귀 | 지수 백오프 타이머 만료 시 (1초 → 2초 → 4초 → … 최대 10초) |
| Unschedulable Queue | Map | 클러스터 상태가 바뀌어야 스케줄링 가능한 파드 | Filter 탈락 전반 (리소스 부족, nodeSelector 불일치, taint/toleration 불일치, PV 미존재, GPU 타입 없음) | 클러스터 이벤트 발생 시 (노드 추가/변경, PV/PVC 생성, 파드 삭제, 리소스 증가) |
위 “주로 관측되는 실패” 열은 결과를 기준으로 묶은 것이다. 스케줄러 내부의 실제 분기 기준은 실패의 성질이 아니라 ① 플러그인이 reject한 것인지 내부 오류인지 ② 스케줄링 도중 도착한 이벤트에 대한 QueueingHint 판정이다. 리소스 부족처럼 “일시적”으로 보이는 실패도 기본적으로는 Unschedulable Queue로 간다. 이 판정 메커니즘은 아래 EnqueueExtension과 QueueingHint에서 다룬다.
Active Queue에서 파드를 꺼내는 순서는 우선순위 기반이며, 동일한 우선순위의 경우 큐에 들어온 순서(FIFO)를 따른다. Backoff Queue는 백오프 만료 시각이 가장 빠른 파드가 맨 위에 온다.
Unschedulable Queue는 업스트림 코드에서
unschedulablePods라는 맵으로 구현되어 있어 풀(pool)이라고도 불린다. 이 시리즈에서는 큐로 통일해 부른다.
Unschedulable Queue의 복귀 조건이 “클러스터 이벤트”라는 것은, 파드 쪽 설정을 고쳐서는 풀리지 않는 상태가 있다는 뜻이다. 노드 디스크가 차서 disk-pressure taint가 붙은 경우가 그렇다. 디스크를 비워 taint가 걷히는 노드 변경이 일어나야 복귀하므로, 그때까지는 재시도가 전부 실패한다(3편 - 노드 압박과 스케줄링, 실제 사례는 MinIO 트러블슈팅).
Active Queue 진입 경로
파드가 Active Queue에 들어오는 경로는 세 가지다.
- 신규 파드: API Server에 대한 Watch를 통해
spec.nodeName이 비어 있는 파드를 감지 - Backoff Queue에서 복귀: 지수 백오프 타이머가 만료된 파드. 즉시 재시도하면 스케줄러에 불필요한 부하가 걸리므로, 실패를 반복할수록 재시도 간격을 늘린다(값은 위 표 참고).
- Unschedulable Queue에서 복귀: 클러스터 이벤트가 발생하여 스케줄링 조건이 달라진 경우. 노드 추가/변경, PV/PVC 생성, 파드 삭제 등이 이에 해당한다.
백그라운드 고루틴과 Move Request
큐 간 파드 이동은 두 가지 백그라운드 고루틴과 Move Request 메커니즘에 의해 이루어진다.
백그라운드 고루틴 (주기 고정, 설정 불가)
| 고루틴 | 실행 주기 | 역할 |
|---|---|---|
flushBackoffQCompleted |
1초 | 백오프 타이머가 만료된 파드를 Backoff Queue → Active Queue로 이동 |
flushUnschedulablePodsLeftover |
30초 | Unschedulable Queue에 podMaxInUnschedulablePodsDuration(기본 5분)보다 오래 머문 파드를 Active Queue 또는 Backoff Queue로 이동 (이벤트에 의해 이동되지 못한 잔류 파드 처리) |
여기서 30초는 검사 주기이고, 이동 대상을 판정하는 체류 기준은 5분이다. 두 값을 혼동하지 않아야 한다.
flushUnschedulablePodsLeftover는 안전망 역할이다. 정상적으로는 클러스터 이벤트에 의한 Move Request가 Unschedulable Queue의 파드를 이동시키지만, 이벤트를 놓치거나 매칭되지 않은 파드가 영원히 갇히는 것을 방지한다. 최악의 경우 파드가 약 5분 30초(5분 초과 체류 + 다음 검사 주기 30초)까지 Unschedulable Queue에 머물 수 있다.
Move Request
클러스터 이벤트(노드 추가/변경, 파드 삭제, PV/PVC 생성, Service 변경 등)가 발생하면 스케줄러가 Move Request를 발행하여 Unschedulable Queue의 파드를 Active Queue 또는 Backoff Queue로 이동시킨다. 스케줄링이 실패한 시점과 Move Request 발행 시점이 같은 스케줄링 사이클이면, 해당 파드는 Unschedulable Queue가 아닌 Backoff Queue로 직접 이동하여 더 빠르게 재시도된다.
스케줄링 루프
이 구조에 의해, 클러스터 내에서는 다음과 같은 스케줄링 루프가 반복된다.
Active Queue에서 파드 꺼냄
    ↓
스케줄링 시도
    ├─ 성공 → Bind (큐에서 제거)
    └─ 실패 → 실패 유형에 따라 Backoff Queue 또는 Unschedulable Queue로 이동
                  ↓
              조건 충족 시 Active Queue로 복귀
                  ↓
                (반복)
스케줄링 프로세스의 구체적인 단계(Filter, Score, PostFilter)와 실패 유형별 큐 이동 규칙은 아래 프로세스 결과와 큐 이동 요약에서 다룬다.
모든 Extension Point
전체 extension point를 순서대로 정리한다.
PreEnqueue
파드가 내부 Active Queue에 추가되기 전에 호출된다. 모든 PreEnqueue 플러그인이 Success를 반환해야 파드가 Active Queue에 진입할 수 있다. 하나라도 실패하면 파드는 Unschedulable Queue에 보관되며, 스케줄링을 시도하지 않는다. 다만 이 파드들은 “시도했다가 실패한” 파드와 구분되어 메트릭상 gated로 따로 집계된다(6편 - 파드가 어느 큐에 있는지 판별).
PreEnqueue는 파드가 Active Queue에 진입하려 할 때마다 호출된다. 새 파드의 최초 진입뿐 아니라, Backoff Queue에서의 복귀, Unschedulable Queue에서의 복귀 시에도 거친다. “애초에 스케줄링 대상이 될 자격이 있는가”를 판단하는 진입 조건이다.
| 시나리오 | PreEnqueue 거치나? |
|---|---|
| 새 파드 생성 → 최초 진입 | O |
| Backoff Queue → Active Queue 복귀 | O |
| Unschedulable Queue → Active Queue 복귀 | O |
대표 사용 사례는 Scheduling Gate다. 파드에 spec.schedulingGates가 설정되어 있으면 SchedulingGates 플러그인이 Success를 반환하지 않아 Active Queue에 진입할 수 없다. 외부 컨트롤러가 gate를 제거해야 비로소 스케줄링이 시작된다. Scheduling Gate의 구체적인 사용법은 3편 - Scheduling Gate에서 다룬다.
EnqueueExtension과 QueueingHint
PreEnqueue와 달리 KubeSchedulerConfiguration의 plugins에 대응하는 필드가 없는 내부 인터페이스다. 플러그인이 구현해 두면, 그 플러그인이 켜진 extension point에서 reject한 파드의 재시도 판단에 쓰인다. 큐에서 reject된 파드의 재시도를 효율적으로 관리하기 위한 메커니즘이다.
앞서 본 것처럼 파드는 여러 단계에서 reject될 수 있고, reject된 파드는 Unschedulable Queue에 머문다. 문제는 이 파드를 언제 다시 꺼낼지 판단하는 기준이다.
- 문제: Filter나 Reserve 등의 단계에서 플러그인이 파드를 reject하면, 해당 파드는 Unschedulable Queue로 들어간다. 그런데 이 파드를 언제 다시 꺼내서 스케줄링을 시도해야 할까? 기준이 없다면, 클러스터에서 아무 변화(노드 라벨 변경, 새 파드 삭제 등)가 생길 때마다 모든 unschedulable 파드를 다시 시도해야 한다. 불필요한 재시도 폭증을 초래한다.
- 해결:
EnqueueExtension인터페이스를 구현하면, 플러그인이 “나한테 의미 있는 이벤트가 뭔지”를 선언할 수 있다.
파드를 reject할 수 있는 인터페이스(PreEnqueue, PreFilter, Filter, Reserve, Permit)를 구현하는 플러그인은 이 인터페이스도 함께 구현하는 것이 권장된다. reject할 수 있는 플러그인이기 때문에, “어떤 이벤트에서 재시도하는 게 의미 있는지”를 선언해 주는 것이다. 구현하지 않으면 기본 구현이 붙어 모든 클러스터 이벤트에서 재시도 대상이 되므로, 동작은 하지만 불필요한 재시도가 늘어난다.
EnqueueExtension만으로는 이벤트 타입까지만 필터링된다. 더 세밀한 판단을 위해 QueueingHint 콜백 함수가 존재한다. 둘이 합쳐서 2단계 필터링 메커니즘을 구성한다.
1단계: EventsToRegister() → "어떤 종류의 이벤트에 반응할지" (이벤트 타입 필터)
       예: Node 변경, Pod의 toleration 변경

2단계: QueueingHintFn() → "이 구체적 이벤트가 이 Pod에 의미 있는가?" (인스턴스 필터)
       예: "그 노드가 unschedulable에서 schedulable로 바뀌었나?"
구체적인 예로 NodeUnschedulable 플러그인을 보자. 이 플러그인은 cordon된 노드를 Filter에서 탈락시키므로, “노드의 cordon이 풀렸을 때”와 “파드에 toleration이 추가되었을 때”만 재시도하면 된다.
// NodeUnschedulable 플러그인이 등록하는 이벤트 (개념적으로 정리)
func (pl *NodeUnschedulable) EventsToRegister(_ context.Context) ([]fwk.ClusterEventWithHint, error) {
    return []fwk.ClusterEventWithHint{
        // 노드가 변경되면 → cordon이 풀렸는지 확인
        {Event: ..., QueueingHintFn: pl.isSchedulableAfterNodeChange},
        // 파드의 toleration이 변경되면 → unschedulable taint를 tolerate하게 됐는지 확인
        {Event: ..., QueueingHintFn: pl.isSchedulableAfterPodTolerationChange},
    }, nil
}

// 2단계: 이 구체적인 노드 변경이 의미가 있는가
func (pl *NodeUnschedulable) isSchedulableAfterNodeChange(...) (fwk.QueueingHint, error) {
    // unschedulable → schedulable로 바뀐 경우에만 재시도할 가치가 있다
    if originalNode.Spec.Unschedulable && !modifiedNode.Spec.Unschedulable {
        return fwk.Queue, nil
    }
    return fwk.QueueSkip, nil  // 그 밖의 노드 변경은 무관하다
}
노드에 라벨이 하나 붙는 것 같은 무관한 변경에는 반응하지 않는다.
QueueingHint 반환값은 두 가지다.
| 반환값 | 의미 | 결과 |
|---|---|---|
Queue |
스케줄 가능성이 생겼을 수 있음 | 큐로 이동 (백오프가 남아 있으면 Backoff Queue를 경유) |
QueueSkip |
이 이벤트는 무관함 | Unschedulable Queue에 그대로 둠 |
백오프를 거칠지 말지는 힌트가 결정하지 않는다. 힌트는 “재시도할 가치가 있는가”만 답하고, Backoff Queue를 경유할지는 큐가 파드의 백오프 잔여 시간을 보고 판단한다.
QueueingHint는 v1.28에 도입되었고 초기에는 반환값이 세 가지(
QueueImmediately,QueueAfterBackoff,QueueSkip)였으나, v1.29에서 현재의 두 가지로 정리되었다. v1.34부터 stable이다.
정리하면, 앞의 스케줄러 큐 절에서 “클러스터 이벤트 발생 시 Unschedulable Queue에서 Active Queue로 복귀”라고 설명한 동작의 내부 구현이 바로 이 EnqueueExtension + QueueingHint 메커니즘이다.
Sort (QueueSort)
Active Queue 내에서 파드의 정렬 순서를 결정한다. Less(Pod1, Pod2) 함수를 제공하여 어떤 파드를 먼저 스케줄링할지 정한다. 한 번에 하나의 QueueSort 플러그인만 활성화할 수 있다. 기본 플러그인인 PrioritySort는 파드 우선순위 기준으로 정렬한다.
PreFilter
파드 또는 클러스터의 정보를 사전 처리하거나, 파드가 만족해야 하는 조건을 확인하는 단계다. PreFilter가 오류를 반환하면 Scheduling Cycle이 즉시 중단된다.
PreFilter는 사전 처리만 하는 단계가 아니다. 두 가지 결정권이 있다.
- 파드 자체를 reject: 예를 들어
VolumeBinding은 파드가 참조하는 PVC가 존재하지 않으면 여기서 reject한다. - 후보 노드 집합을 좁히기:
PreFilterResult를 반환해 Filter가 평가할 노드를 제한할 수 있다. v1.32 기준NodeAffinity가 이 방식을 쓴다 —matchFields로 노드 이름이 고정되면 해당 노드만 후보로 반환한다. 1편에서 다룬 DaemonSet의 스케줄러 위임이 정확히 이 최적화를 탄다 — 노드 하나만 평가하므로 전체 노드를 순회하지 않는다. (NodeName플러그인은 v1.32 기준 Filter만 구현한다.)
v1.27부터는 플러그인이 Skip 상태를 반환하여, 해당 플러그인의 Filter 실행을 건너뛸 수 있다(예: 파드에 nodeAffinity가 없으면 NodeAffinity 플러그인의 Filter를 Skip). 같은 버전에서 PreScore → Score 방향의 Skip도 도입되었다.
Filter
부적합한 노드를 탈락시키는 단계다. 각 노드에 대해 등록된 Filter 플러그인을 순차 실행하며, 하나라도 실패하면 해당 노드는 즉시 탈락한다. 모든 노드가 Filter에서 탈락하면 파드는 Unschedulable로 표시되고 PostFilter가 실행된다.
주요 특성은 아래와 같다.
- 노드 간 병렬 처리: 여러 노드에 대한 필터링을 동시에 수행한다.
- 대규모 클러스터 최적화: 클러스터 노드가 많을 경우 모든 노드를 평가하지 않고, 충분한 수의 적합 노드를 찾으면 나머지 노드 평가를 중단한다. 이 “충분한 수”를 결정하는 것이
percentageOfNodesToScore이며, 기본값과 계산식은 4편 - percentageOfNodesToScore에서 다룬다. 스케줄링 품질과 성능 사이의 트레이드오프다. - PreFilter Skip 최적화 (v1.27+): PreFilter 플러그인이
Skip상태를 반환하면, 해당 플러그인의 Filter 실행을 건너뛴다.
대표적인 Filter 플러그인은 다음과 같다(v1.32 기준). 배치 규칙에 해당하는 것들은 파드·노드 쪽에서 어떻게 설정하는지를 3편에서 다룬다.
| 분류 | 플러그인 | 체크 항목 |
|---|---|---|
| 이름 매칭 | NodeName | 파드 spec에 nodeName이 지정된 경우 해당 노드와 일치하는지(스케줄러 큐에는 nodeName이 빈 파드만 들어오므로 kube-scheduler에서는 사실상 항상 통과한다. 같은 판정을 kubelet admission이 재사용한다) |
| 노드 상태 | NodeUnschedulable | 노드가 Unschedulable로 마킹되어 있는지 (kubectl cordon 적용 여부) |
| 리소스 | NodeResourcesFit | CPU, Memory 등 리소스 충분 여부. requests 기준으로 판단하며, limits는 스케줄링 시 고려하지 않는다. GPU 등 extended resource(nvidia.com/gpu처럼 kubernetes.io 도메인 밖의 리소스 — 상세)는 limits만 설정하면 requests도 동일하게 자동 설정되므로 결과적으로는 같지만, 원리적으로는 항상 requests 기준 |
| 배치 규칙 | NodeAffinity | nodeSelector 라벨 일치 및 requiredDuringSchedulingIgnoredDuringExecution 조건 만족 여부 |
| 배치 규칙 | TaintToleration | 노드의 taint를 파드가 tolerate하는지 |
| 배치 규칙 | PodTopologySpread | 토폴로지 분산 규칙의 maxSkew 위반 여부 |
| 배치 규칙 | InterPodAffinity | 파드의 required podAffinity·podAntiAffinity, 그리고 이미 배치된 파드들의 required anti-affinity를 모두 만족하는지 |
| 볼륨 | VolumeBinding | 요청한 PVC/PV가 해당 노드에서 마운트 가능한지 |
| 볼륨 | VolumeRestrictions | 볼륨 제공자의 제한 사항 충족 여부 |
| 볼륨 | VolumeZone | 볼륨의 zone 요구 사항 충족 여부 |
| 볼륨 | NodeVolumeLimits | CSI(Container Storage Interface) 볼륨 수 제한 초과 여부 |
| 포트 | NodePorts | 요청한 hostPort가 해당 노드에서 이미 사용 중인지 |
참고: NodeAffinity와 InterPodAffinity의
preferredDuringScheduling조건은 Filter가 아닌 Score 단계에서 처리된다. Filter에서는required조건만 체크한다.
PostFilter
정상 흐름(Filter → Score → Bind)에서 벗어나, PreFilter에서 파드가 거절되었거나 Filter 단계에서 적합한 노드가 하나도 없을 때만 진입하는 실패 경로다. 소스 코드의 PostFilterPlugin 인터페이스 주석은 다음과 같이 설명한다.
PostFilter is called by the scheduling framework when the scheduling cycle failed at Prefilter or Filter
플러그인은 설정된 순서대로 실행되며(순차 실행), 첫 번째로 성공한 플러그인에서 종료된다(Early Exit). 성공한 플러그인이 nominatedNodeName을 설정하며, 파드당 하나의 후보 노드만 설정 가능하다.
v1.32 기준 in-tree 기본 플러그인은 DefaultPreemption 하나다. 커스텀 플러그인을 만들어 등록하는 것도 가능하며, 외부 프로젝트가 제공하는 것도 있다.
| 플러그인 | 제공 형태 | 동작 |
|---|---|---|
| DefaultPreemption | in-tree 기본 (v1.32) | Filter 탈락 사유가 선점으로 풀릴 수 있는(Unschedulable) 노드만 후보로 삼고, 임의의 시작점부터 선점을 시뮬레이션해 후보를 max(후보 노드 수 × 10%, 100)개 찾으면 멈춘 뒤 그중 단일 노드를 골라 victim을 축출한다(DefaultPreemptionArgs의 minCandidateNodesPercentage·minCandidateNodesAbsolute로 조정). 선택 기준은 아래 선점 절 참고 |
| PreemptionToleration | out-of-tree (kubernetes-sigs/scheduler-plugins) | victim 측면의 선점 정책을 커스터마이징한다 |
| CrossNodePreemption | out-of-tree (kubernetes-sigs/scheduler-plugins) | 여러 노드 조합을 평가하며, cross-node 제약(PodTopologySpread, AntiAffinity)을 고려하여 여러 노드에 걸쳐 victim을 축출할 수 있다 |
out-of-tree 플러그인은 기본 kube-scheduler 바이너리에 컴파일되어 있지 않다. KubeSchedulerConfiguration의 postFilter에 이름만 적으면 레지스트리에 없는 플러그인이라 스케줄러가 기동하지 못한다(1편 - 레지스트리와 프로필). 해당 플러그인을 넣은 커스텀 빌드 kube-scheduler를 배포해야 한다(1편 - 프로필과 별도 바이너리의 선택 기준).
nominatedNodeName이 설정된 파드는 다시 스케줄링 큐로 돌아가며, 추후 다시 스케줄링 프로세스를 거친다.
PreScore
Score 플러그인이 사용할 공유 상태를 생성하는 사전 처리 단계다. 노드를 탈락시키거나 파드를 reject하는 결정권은 없는 informational 성격의 단계이며, 오류를 반환하면 Scheduling Cycle이 중단된다.
CycleState캐시 패턴, 대표 플러그인(InterPodAffinity, NodeResourcesFit, TaintToleration)의 구체적인 PreScore 동작은 6편 - PreScore 역할에서 자세히 다룬다.
Score
Filter를 통과한 노드들 중 최적의 노드를 선택하는 단계다. 각 노드에 점수를 부여하고, 최종적으로 가장 높은 점수를 받은 노드에 파드를 배치한다.
스코어링 과정은 다음과 같다.
- Score: 각 Score 플러그인이 노드별 점수를 산출한다. 플러그인은 자체 범위의 값을 반환할 수 있다.
- NormalizeScore: 플러그인별로 점수를 0~100(
MinNodeScore~MaxNodeScore) 범위로 정규화한다. - 가중치 적용: 각 플러그인에 설정된 가중치(weight)를 곱한다. 가중치는
KubeSchedulerConfiguration에서 플러그인별로 설정할 수 있다. - 합산 및 선택: 모든 플러그인의 가중 점수를 합산하여 최고 점수 노드를 선택한다.
최고 점수 노드가 여러 개면 그중 하나를 균등 무작위로 고른다. 구현은 최고점 노드를 세어가며 1/N 확률로 후보를 교체하는 reservoir sampling 방식이다. 노드를 순번대로 돌아가며 고르는 것이 아니다.
라운드 로빈 방식이 쓰이는 곳은 따로 있다. Filter 단계에서 노드 평가를 시작하는 위치를 매 사이클 순환시켜, 앞쪽 노드에만 파드가 몰리는 것을 방지한다.
적합 노드가 하나뿐인 경우
Filter 단계에서 하나의 노드만 적합한 것으로 확인된 경우, 스케줄러는 PreScore·Score·NormalizeScore를 아예 호출하지 않고 그 노드를 바로 고른다(schedulePod의 len(feasibleNodes) == 1 분기). 경쟁할 노드가 없으니 점수를 매길 이유가 없기 때문이다. percentageOfNodesToScore와는 별개의 단축 경로다.
기본 Score 플러그인
대표적인 Score 플러그인은 다음과 같다(v1.32 기준, 기본 가중치 포함).
| 플러그인 | 기본 가중치 | 스코어링 기준 |
|---|---|---|
| TaintToleration | 3 | 파드가 tolerate하지 못하는 PreferNoSchedule taint가 적은 노드 선호 |
| NodeAffinity | 2 | preferredDuringScheduling 조건에 부합하는 노드에 높은 점수 |
| PodTopologySpread | 2 | 토폴로지 분산이 균일한 배치에 높은 점수 |
| InterPodAffinity | 2 | 파드 간 preferredDuringScheduling 친화성 조건 반영 |
| NodeResourcesFit | 1 | 리소스 분산 전략에 따른 점수 (LeastAllocated / MostAllocated / RequestedToCapacityRatio) |
| NodeResourcesBalancedAllocation | 1 | CPU와 Memory의 사용 비율이 균형 잡힌 노드 선호 |
| ImageLocality | 1 | 파드에 필요한 컨테이너 이미지가 이미 존재하는 노드 선호 |
| VolumeBinding | 1 | 볼륨 용량 기반 스코어링. 기본 상태에서는 동작하지 않는다 — scorer가 feature gate 활성 시에만 생성되므로, 꺼져 있으면 PreScore가 Skip을 반환하고 점수에 기여하지 않는다 |
가중치 변경 이력: v1.23에서 도입된
v1beta3API부터TaintToleration이 3,NodeAffinity/InterPodAffinity가 2로 상향되었다(PodTopologySpread는 그 이전v1beta2에서 이미 2였고, 나머지는 1이었다). 이는 배치 규칙(taint, affinity, topology)이 리소스 분산보다 스케줄링 결정에 더 중요한 요소라는 판단을 반영한 것이다. 이 가중치 값은 v1.32에서도 동일하다.
참고:
NodeResourcesFit은 Filter와 Score 양쪽에 등록되는 대표적인 플러그인이다. Score에서의 기본 전략은LeastAllocated(리소스를 고르게 분산)이며,MostAllocated(노드를 채우는 방향)로 변경할 수 있다. 전략별 점수 공식과 계산 예시는 4편 - NodeResourcesFit 스코어링 전략에서 다룬다.
NormalizeScore
Score 결과를 0~100 범위로 정규화하는 단계다. 같은 플러그인의 Score 결과만 정규화하며, Scheduling Cycle당 플러그인당 한 번 호출된다. 정규화 후, 각 플러그인에 설정된 가중치(weight)를 곱하고 모든 플러그인의 점수를 합산하여 최고 점수 노드를 선택한다.
Reserve
선택된 노드에 리소스를 예약하는 단계다. 실제 바인딩 전에 리소스를 예약하여, 스케줄러가 바인딩 완료를 기다리는 동안 다른 파드가 동일 리소스를 사용하는 것을 방지한다. Reserve와 Unreserve 두 메서드로 구성되며, Reserve 실패 시 또는 이후 단계 실패 시 모든 Reserve 플러그인의 Unreserve가 역순으로 호출된다.
Permit
Scheduling Cycle의 마지막 단계로, 파드의 바인딩을 승인(approve), 거부(deny), 또는 대기(wait)시킬 수 있다. 기본적으로는 즉시 승인된다.
- approve: 모든 Permit 플러그인이 승인하면 Binding Cycle로 진행
- deny: 하나라도 거부하면 파드가 큐로 돌아가고, Reserve 플러그인의 Unreserve가 호출됨
- wait: 타임아웃 내에 승인되지 않으면 deny로 전환
PreBind (Binding Cycle)
파드가 바인딩되기 전에 필요한 작업을 수행한다. 예를 들어, VolumeBinding 플러그인이 네트워크 볼륨을 프로비저닝하고 마운트하는 작업이 여기서 이루어진다. 하나라도 실패하면 파드는 큐로 돌아간다.
Bind (Binding Cycle)
파드를 노드에 실제로 바인딩하는 단계다. 기본 플러그인 DefaultBinder는 Binding 오브젝트를 만들어 파드의 binding 서브리소스에 POST한다. spec.nodeName을 직접 PATCH하는 방식이 아니다 — 파드 생성 후 spec.nodeName을 수정하는 요청은 API Server가 거부한다.
POST /api/v1/namespaces/default/pods/my-pod/binding
{
  "apiVersion": "v1",
  "kind": "Binding",
  "metadata": { "name": "my-pod" },
  "target": { "apiVersion": "v1", "kind": "Node", "name": "worker-node-1" }
}
API Server가 이 요청을 처리하면서 spec.nodeName을 설정하고 PodScheduled: True 조건을 기록한다. spec.nodeName이 설정되면 해당 노드의 Kubelet이 파드를 감지하고 실행을 시작한다. Bind 실패 시(API Server 통신 오류, 그 사이 다른 주체가 먼저 바인딩해 409 Conflict가 난 경우 등) 파드는 Backoff Queue로 이동한다. Binding은 노드 상태를 보지 않으므로, NotReady 노드로의 바인딩은 실패하지 않는다.
1편의 수동 스케줄링이 “스케줄러의 Bind 단계만 직접 실행하는 것과 같다”고 한 것은, 바로 이 동일한 API 호출을 사람이 직접 보내는 것이기 때문이다.
설정된 순서대로 Bind 플러그인이 호출되며, 하나가 처리하면 나머지는 건너뛴다.
PostBind (Binding Cycle)
파드가 성공적으로 바인딩된 후 호출되는 정보성 단계다. Binding Cycle의 마지막이며, 관련 리소스 정리 등에 사용된다.
Extension Point별 동작 규칙 요약
각 extension point에서 복수 플러그인이 어떻게 동작하고, 실패 시 어떤 일이 발생하는지를 정리한다.
| Extension Point | 복수 플러그인 | 실패 시 동작 |
|---|---|---|
| QueueSort | 정확히 1개만 허용 | — |
| PreFilter | 순서대로 전부 호출 | 하나라도 실패 → 사이클 중단 |
| Filter | 노드별로 순서대로 호출 | 하나라도 실패 → 해당 노드 탈락 |
| PostFilter | 순서대로 호출 | 첫 번째 성공 → 나머지 스킵 |
| Score | 전부 호출 후 가중합 | 실패 시 사이클 중단 |
| Reserve | 순서대로 전부 호출 | 하나라도 실패 → 이전 것들 Unreserve 역순 롤백 |
| Permit | 순서대로 전부 호출 | 하나라도 거부 → 사이클 중단 |
| PreBind | 순서대로 전부 호출 | 하나라도 실패 → Unreserve 롤백 |
| Bind | 순서대로 시도 | 첫 번째로 성공한 플러그인만 실행 (나머지 스킵) |
대부분의 extension point는 등록된 플러그인을 모두 실행(AND 조건 또는 합산)하지만, QueueSort와 Bind는 “하나만 동작해야 한다”는 공통점이 있다. 다만 그 제약의 메커니즘이 다르다.
- QueueSort — 등록 자체가 1개로 제한:
Less(Pod1, Pod2)로 전체 순서(total ordering)를 결정하는 비교 함수다. 비교 함수가 2개 존재하면 순서가 모순될 수 있으므로, 단일 비교 기준만 허용된다. - Bind — 복수 등록 가능, 실행은 1개만 (Chain of Responsibility): 여러 Bind 플러그인을 등록할 수 있지만, “파드를 Node에 묶는 API 호출”은 한 번만 이뤄져야 하므로 첫 번째로 처리하겠다고 한 플러그인만 실행되고 나머지는 스킵된다.
각 extension point가 “노드를 탈락시킬 수 있는가 / 파드를 reject할 수 있는가”로 재분류한 결정권 관점은 6편 - Extension Point 결정권 분류에서 다룬다.
기본 플러그인과 Extension Point 매핑
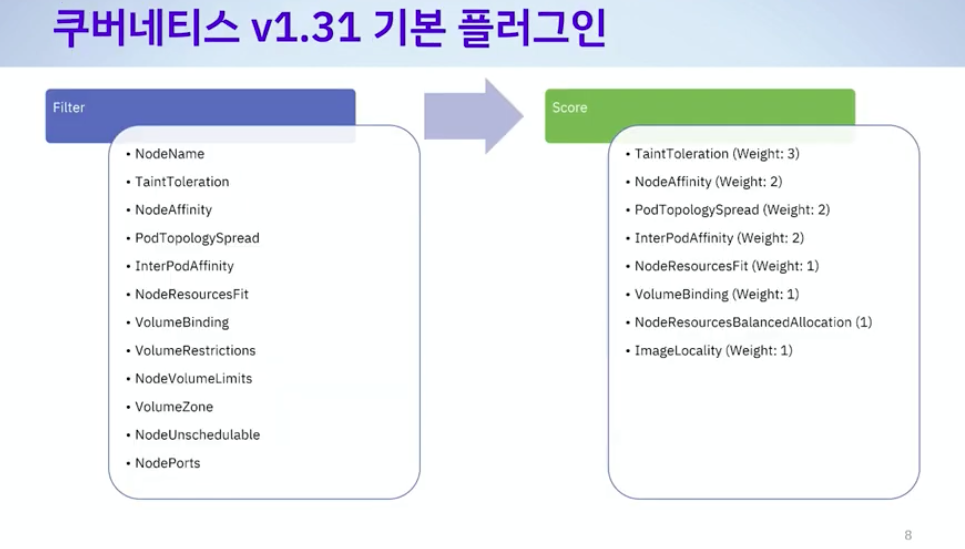
v1.32 기준 기본 활성화된 플러그인이 어떤 extension point에 등록되어 있는지 전체 매핑이다. 하나의 플러그인이 여러 extension point에 걸쳐 동작하는 것을 확인할 수 있다.
| 플러그인 | Extension Points | 설명 |
|---|---|---|
| SchedulingGates | preEnqueue | spec.schedulingGates가 남아 있으면 큐 진입 차단 |
| PrioritySort | queueSort | 파드 우선순위 기반 큐 정렬 |
| NodeName | filter | spec.nodeName 지정 시 해당 노드 매칭 |
| NodeUnschedulable | filter | cordon 상태 노드 제외 |
| NodePorts | preFilter, filter | hostPort 충돌 확인 |
| NodeResourcesFit | preFilter, filter, preScore, score | 리소스 충분 여부 및 분산 전략 |
| NodeAffinity | preFilter, filter, preScore, score | nodeSelector 및 nodeAffinity 평가 |
| TaintToleration | filter, preScore, score | taint/toleration 평가 |
| PodTopologySpread | preFilter, filter, preScore, score | 토폴로지 분산 제약 |
| InterPodAffinity | preFilter, filter, preScore, score | 파드 간 affinity/anti-affinity |
| VolumeBinding | preFilter, filter, preScore, reserve, preBind, score | PVC/PV 바인딩 및 프로비저닝 |
| VolumeRestrictions | preFilter, filter | 볼륨 제공자별 제한 확인 |
| VolumeZone | preFilter, filter | 볼륨 zone 요구 사항 확인 |
| NodeVolumeLimits | preFilter, filter | CSI 볼륨 수 제한 확인 |
| NodeResourcesBalancedAllocation | preScore, score | CPU/Memory 균형 배치 |
| ImageLocality | score | 이미지 캐시 존재 여부 |
| DefaultPreemption | postFilter | 기본 선점 로직 |
| DefaultBinder | bind | 기본 바인딩 (Binding 오브젝트 생성) |
클라우드 벤더 전용 볼륨 제한 플러그인(
EBSLimits,GCEPDLimits,AzureDiskLimits,CinderLimits)은 과거에 존재했으나 v1.32에서 모두 제거되었다. 현재는 CSI 기반의NodeVolumeLimits가 이 역할을 대신한다. 제거된 이름을plugins의enabled나pluginConfig에 명시해 둔 설정은 스케줄러 기동을 실패시키므로(disabled에만 남은 경우는 조용히 무시된다), v1.32 이상으로 업그레이드할 때 확인이 필요하다.
Filter와 Score 양쪽에 등록되는 플러그인에 주목할 필요가 있다. 예를 들어:
- NodeResourcesFit: Filter에서는 “리소스가 충분한가”를 확인하고, Score에서는 “충분한 노드들 중 어디가 더 적합한가”를 평가
- TaintToleration: Filter에서는 “taint를 tolerate할 수 있는가”를 확인하고, Score에서는 파드가 tolerate하지 못하는
PreferNoScheduletaint가 적은 노드에 높은 점수 - NodeAffinity: Filter에서는
required조건만 확인하고, Score에서는preferred조건을 점수에 반영 - InterPodAffinity: Filter에서는 required affinity·anti-affinity(기존 파드의 anti-affinity 포함)를 확인하고, Score에서는 preferred affinity·anti-affinity를 점수에 반영
각 플러그인이 extension point별로 구체적으로 무엇을 하는지는 6편 - 기본 플러그인 해부에서 분해한다. 기본 비활성화된 플러그인도 그곳에서 다룬다.
프로세스 결과와 큐 이동 요약
앞의 스케줄러 큐 절에서 스케줄러가 큐 관리 역할을 담당한다고 했는데, 스케줄링 프로세스의 결과에 따른 큐 간 파드 이동도 모두 스케줄러가 담당한다.
| 프로세스 결과 | 이동 대상 큐 |
|---|---|
| Filter 통과 → Score → Bind 성공 | 스케줄링 완료 (큐에서 제거) |
| Filter 통과 → Bind 실패 (일시적 문제) | Backoff Queue |
| Filter 전체 실패 → PostFilter 선점 성공 | Unschedulable Queue (일반적) |
| Filter 전체 실패 → PostFilter 실패 | Unschedulable Queue |
선점에 성공한 경우를 오해하기 쉽다. PostFilter가 선점에 성공해도 그 스케줄링 시도 자체는 실패로 끝난다. victim이 아직 종료되지 않았으므로 지금 당장 배치할 수는 없기 때문이다. 파드는 다른 실패와 마찬가지로 큐로 돌아가고, nominatedNodeName만 별도로 기록된다. 이후 victim이 실제로 삭제되는 이벤트가 오면 QueueingHint 판정을 거쳐 Active Queue로 복귀하고, PreFilter부터 프로세스를 다시 밟는다.
선점 성공은 큐 선택에서 특별 대우를 받지 않는다. 다른 실패와 똑같이 AddUnschedulableIfNotPresent를 타고, 목적지는 “이 파드의 스케줄링 사이클이 도는 도중에 도착한 클러스터 이벤트가 있었는가”로 갈린다.
큐 목적지 결정 규칙 (v1.32 기준)
SchedulerQueueingHints가 기본 활성화된 v1.32 기준이다. 목적지는 두 함수가 순서대로 정한다.
1단계 — determineSchedulingHintForInFlightPod: 이 파드의 스케줄링 사이클이 도는 도중에 도착한 클러스터 이벤트들을, 이 파드를 떨어뜨린 플러그인들의 QueueingHint에 물어본다.
| 판정 | 조건 |
|---|---|
queueSkip |
사이클 중 도착한 이벤트가 없거나, 있어도 전부 무관하다고 판정 |
queueAfterBackoff |
관련 있는 이벤트가 있었음 (또는 떨어뜨린 플러그인이 아예 없는 내부 오류) |
queueImmediately |
PendingPlugins가 즉시 재시도를 요구 |
2단계 — requeuePodViaQueueingHint: 판정과 백오프 잔여 시간으로 큐를 고른다.
| 판정 | 백오프 잔여 | 목적지 |
|---|---|---|
queueSkip |
— | Unschedulable Queue |
queueAfterBackoff |
남아 있음 | Backoff Queue |
queueAfterBackoff |
끝남 | Active Queue |
queueImmediately |
— | Active Queue |
즉 갈 수 있는 곳은 세 갈래다.
선점 성공은 왜 거의 항상 Unschedulable Queue인가
- 선점 파드는 Filter 플러그인에 의해 떨어진 상태라
UnschedulablePlugins가 비어 있지 않다. 내부 오류 분기(queueAfterBackoff)에 해당하지 않는다 - victim은 graceful termination period를 받는다. PostFilter가 Delete를 호출해도 파드가 실제로 사라지는 이벤트는 그 짧은 사이클 안에 도착하지 않는다 → 사이클 중 관련 이벤트 없음 →
queueSkip
Backoff나 Active로 가려면 그 짧은 사이클 동안 관련 이벤트가 도착해야 하는데, 선점 시나리오에서는 드물다.
게이트가 꺼져 있으면 규칙이 다르다
SchedulerQueueingHints는 v1.28에 도입되었지만 v1.32에서야 기본 활성화되었다(v1.28.0~v1.28.4는 기본 활성이었다가 v1.28.5 패치에서 기본 비활성으로 바뀌었고, v1.29~v1.31은 기본 비활성). 꺼져 있으면 구버전 경로를 타며 기준이 더 단순하다 — 사이클 중 move request를 받았거나(moveRequestCycle >= podSchedulingCycle) 떨어뜨린 플러그인이 없으면 Backoff Queue, 그 외에는 Unschedulable Queue다. 결론은 같다.
Active Queue로 복귀하는 조건을 정리하면 다음과 같다.
- Backoff Queue: 백오프 타이머 만료 시(스케줄러가 주기적으로 확인)
- Unschedulable Queue: 관련 클러스터 이벤트 발생 시(EnqueueExtension과 QueueingHint 판정을 통과한 경우)
이 모든 과정에서 파드는 Pending 상태를 유지하며, 스케줄링에 성공해 바인딩되고 컨테이너가 시작되어야 비로소 Running 상태가 된다. 큐 구조와 큐 간 이동 조건에 대한 자세한 내용은 스케줄러 큐 절을 참고한다.
실전 사례: GPU 1개뿐인 노드에
nodeSelector로 고정 배치한 Deployment를 업데이트할 때, 기본값(maxSurge: 1,maxUnavailable: 0)이 적용되면 새 파드를 먼저 생성하려 하지만, GPU가 이미 점유 중이라 Filter에서 탈락하고, 같은 우선순위라 선점도 불가하여 Unschedulable Queue에 갇히는 교착 상태가 발생한다. 기존 파드가 종료되어 GPU 리소스가 해제되는 클러스터 이벤트가 발생해야 복귀할 수 있다. 경위는 Deployment 재배포 실패 시리즈 1편부터, 교착의 분석은 3편 - Deadlock에서 다룬다.
선점
공식 문서에서는 이렇게 설명한다.
Pods can have priority. Priority indicates the importance of a Pod relative to other Pods. If a Pod cannot be scheduled, the scheduler tries to preempt (evict) lower priority Pods to make scheduling of the pending Pod possible.
즉, 우선순위가 더 높은 파드를 위해 더 낮은 우선순위 파드를 종료하는 것이다. “선점”이라는 표현이 해당 파드가 직접 리소스를 빼앗는 것처럼 들리지만, 실제 동작은 낮은 우선순위 파드를 종료시켜 공간을 확보한 후, 높은 우선순위 파드가 그 공간에 스케줄링되는 방식이다. 선점한 파드에는 nominatedNodeName이 설정된다.
선점이 동작하는 조건
우선순위에 따라 결정한다는 것이 중요하다. 즉, 선점이 이루어지기 위해서는 우선순위가 있어야 한다.
-
priorityClass 리소스를 정의해야 함
--- apiVersion: scheduling.k8s.io/v1 kind: PriorityClass metadata: name: high-priority value: 1000000 globalDefault: false # true로 설정하면 priorityClassName 미지정 파드의 기본값으로 사용됨 (클러스터당 1개만 가능) preemptionPolicy: PreemptLowerPriority # PreemptLowerPriority: 낮은 우선순위 파드 선점 가능 / Never: 선점하지 않음 description: "High priority pods" --- apiVersion: scheduling.k8s.io/v1 kind: PriorityClass metadata: name: low-priority value: 1000 globalDefault: false description: "Low priority pods" -
기존 파드와 우선순위 대상 파드에 해당 priorityClass가 적용되어 있어야 함
apiVersion: v1
kind: Pod
metadata:
  name: nginx
  labels:
    env: test
spec:
  containers:
  - name: nginx
    image: nginx
    imagePullPolicy: IfNotPresent
  priorityClassName: high-priority
대부분 파드를 그 자체로 띄우지 않으므로, Deployment와 같은 리소스 컨트롤러에 우선순위를 적용한다. 같은 리소스 컨트롤러에서 생성된 파드는 같은 우선순위를 갖는다. 실제 프로덕션 환경에서는 서로 다른 워크로드 간 우선순위 차이를 적용해 선점을 활용한다.
| 높은 우선순위 | 낮은 우선순위 | 비고 |
|---|---|---|
| 프로덕션 환경 파드 | 개발/테스트 환경 파드 | |
| 핵심 서비스 | 배치 작업 | |
| 상시 서비스 | ML 학습 작업 | 학습 작업이 서비스보다 낮은 우선순위면 서비스를 선점할 수 없다. preemptionPolicy: Never의 쓰임은 아래 참고 |
| 시스템 컴포넌트 | 사용자 워크로드 | system-cluster-critical |
preemptionPolicy의 방향을 혼동하기 쉽다. 낮은 우선순위 쪽에 preemptionPolicy: Never를 붙이면, 그 파드는 다른 파드를 선점하지 않지만 자신은 여전히 선점당할 수 있다. 공식 문서의 표현은 다음과 같다.
Pods with
preemptionPolicy: Neverwill be placed in the scheduling queue ahead of lower-priority pods, but they cannot preempt other pods.
Non-preempting pods may still be preempted by other, high-priority pods.
선점은 자신보다 낮은 우선순위 파드만 대상으로 한다. 따라서 서비스보다 낮은 우선순위의 학습 작업은 preemptionPolicy와 무관하게 서비스를 밀어낼 수 없고, 학습 작업에 Never를 붙여 막히는 것은 학습보다 더 낮은 우선순위 파드(개발·테스트 등)에 대한 선점뿐이다. 공식 문서가 드는 Never의 용례는 반대 방향으로, 큐에서는 먼저 스케줄링되되 실행 중인 작업은 선점하지 않아야 하는 높은 우선순위 작업이다. 학습 작업에 높은 우선순위와 Never를 함께 주면 큐에서는 앞서고, 실행 중인 파드는 밀어내지 않는다. 그리고 Never는 “선점당하지 않게” 하는 설정이 아니다. 학습이 선점당하지 않게 하려면 학습 작업의 우선순위 값 자체를 올려야 한다.
마지막 행의 system-cluster-critical은 쿠버네티스가 기본 제공하는 PriorityClass로, 클러스터 운영에 필요한 컴포넌트에 쓰도록 예약되어 있다(system-node-critical이 더 높다).
리소스가 제한적인 클러스터에서는 이러한 우선순위 설정이 서비스 안정성 확보를 위해 필수적이다. 예를 들어, ML 서비스에서 긴급한 추론 요청이 들어왔을 때 학습 워크로드보다 높은 우선순위를 부여하거나, 권한이 다른 사용자 간 학습 작업의 우선순위를 차등 적용하는 등의 방식으로 활용할 수 있다.
선점의 내부 동작
DefaultPreemption 플러그인이 PostFilter에서 수행하는 작업을 순서대로 보면 다음과 같다.
1. 노드별 선점 가능성 시뮬레이션
시뮬레이션 대상은 Filter 탈락 사유가 선점으로 풀릴 수 있는(Unschedulable) 노드뿐이고, 위 표본 수만큼 후보를 찾으면 중단한다. 각 후보 노드에 대해 “이 노드에서 preemptor보다 낮은 우선순위 파드를 전부 제거하면 preemptor가 들어갈 수 있는가”를 확인한다. 공식 문서의 표현은 다음과 같다.
A Node is considered for preemption only when the answer to this question is yes: “If all the Pods with lower priority than the pending Pod are removed from the Node, can the pending Pod be scheduled on the Node?”
답이 아니오면 그 노드는 후보에서 제외된다.
2. 최소 victim 집합 계산
후보 노드에서 낮은 우선순위 파드를 전부 제거한 상태에서 시작해, 우선순위가 높은 것부터 하나씩 되돌려 넣으면서 여전히 Filter를 통과하는지 재검사한다. 그래서 낮은 우선순위 파드가 전부 죽는 것이 아니다.
Preemption does not necessarily remove all lower-priority Pods. If the pending Pod can be scheduled by removing fewer than all lower-priority Pods, then only a portion of the lower-priority Pods are removed.
3. 후보 노드 중 하나 선택
여러 노드가 선점 후보가 되면 다음 기준을 순서대로 적용한다.
| 순서 | 기준 |
|---|---|
| 1 | PodDisruptionBudget 위반 수가 가장 적은 노드 |
| 2 | victim 중 최고 우선순위가 가장 낮은 노드 |
| 3 | victim들의 우선순위 합이 가장 작은 노드 |
| 4 | victim 개수가 가장 적은 노드 |
| 5 | 최고 우선순위 victim의 시작 시각이 가장 늦은 노드 |
| 6 | 위 기준으로도 동률이면 첫 번째 노드 |
PodDisruptionBudget(PDB)은 자발적 중단으로 동시에 내려갈 수 있는 파드 수의 상한을 정하는 오브젝트다. 선점은 PDB를 위반하지 않는 조합을 우선 고르지만, 다른 후보가 없으면 위반하면서도 선점한다. 공식 문서도 “respecting PDB is best effort”라고 명시한다. 선점은 Eviction API가 아니라 Delete API로 victim을 삭제하므로, PDB가 강제되지 않는다.
4. 예약 마커 설정과 victim 삭제
preemptor의 status.nominatedNodeName에 선택된 노드를 기록하고, victim들을 삭제한다. victim은 graceful termination period를 받으므로 즉시 사라지지 않는다.
5. preemptor는 큐로 복귀
victim이 종료되기를 기다리는 동안 스케줄러는 다른 파드를 계속 스케줄링한다. victim이 실제로 사라지면 preemptor가 Active Queue로 복귀해 스케줄링 프로세스를 처음부터 다시 밟는다.
선점과 종료 사이의 시간 간격을 줄이려면 낮은 우선순위 파드의 graceful termination period를 짧게 두는 방법이 있다. 다만 이것은 해당 워크로드가 종료 처리에 필요한 시간을 줄이는 것이므로, 워크로드 특성을 보고 판단해야 한다.
여기서 중요한 점은, 선점이 victim을 다른 노드로 “옮기는” 것이 아니라는 것이다. victim은 삭제되고, victim의 컨트롤러가 새 파드를 만들고, 그 새 파드가 스케줄링을 처음부터 다시 받는다. 6편에서 보듯 이미 바인딩된 파드의 배치를 바꾸는 방법은 삭제 후 재생성뿐이고, 선점도 이 원칙을 따른다.
nominatedNodeName이 하는 일
PostFilter 단계 이후, nominatedNodeName이 설정된 파드는 스케줄링 큐로 돌아가 다시 필터링, 스코어링 등 원래 스케줄링 프로세스를 거친다. 그렇다면 nominatedNodeName의 역할은 무엇인가?
역할은 두 가지다.
1. 끼어들기 방지
victim 파드가 종료되는 동안 다른 낮은 우선순위 파드가 그 공간을 차지하는 것을 막는다. 스케줄러는 nominated 파드보다 우선순위가 같거나 낮은 파드를 평가할 때 nominated 파드가 해당 노드에서 실행 중인 것처럼 계산하므로(Filter를 nominated 파드를 넣은 상태와 뺀 상태로 두 번 돈다), 그 리소스는 이미 예약된 것으로 취급된다. 더 높은 우선순위 파드에게는 이 예약이 보이지 않는다.
이것이 없으면 아래와 같은 문제가 발생한다.
- 높은 우선순위 파드 P가 선점 성공
- victim 파드 축출 시작
- 파드 P는 큐로 돌아가 대기
- 그 사이 다른 파드가 끼어 들어서 victim이 비운 공간을 차지
- 파드 P는 영원히 기다림
2. 재시도 시 우선 탐색
스케줄러는 다음 사이클에서 nominated node를 다른 노드보다 먼저 시도한다.
The scheduler always tries the “nominated Node” before iterating over any other nodes.
다만, nominatedNodeName이 설정된 파드더라도 nominated node에 항상 스케줄링된다는 보장은 없다.
Please note that Pod P is not necessarily scheduled to the ‘nominated Node’.
보장이 깨지는 경로는 두 가지다.
| 경로 | 결과 |
|---|---|
| victim이 종료되기를 기다리는 동안 다른 노드가 비는 경우 | 스케줄러가 그 다른 노드에 P를 배치할 수 있다. 결과적으로 nominatedNodeName과 최종 spec.nodeName이 다를 수 있다 |
| P보다 더 높은 우선순위 파드가 도착하는 경우 | 스케줄러가 그 노드를 새 파드에게 줄 수 있다. 이때 스케줄러는 P의 nominatedNodeName을 지운다 — P가 다른 노드에서 다시 선점을 시도할 수 있게 하기 위해서다 |
선점의 한계
선점이 동작하지 않거나 의도와 다르게 동작하는 경우가 있다.
낮은 우선순위 파드에 대한 inter-pod affinity
preemptor가 그 노드의 낮은 우선순위 파드에 podAffinity를 걸고 있으면, 그 파드를 제거하면 affinity 조건이 깨진다. 이 경우 스케줄러는 그 노드에서 선점을 하지 않고 다른 노드를 찾는다. 공식 문서는 inter-pod affinity를 같거나 높은 우선순위 파드에만 걸 것을 권고한다.
cross-node 선점은 하지 않는다
zone 단위 anti-affinity처럼, 다른 노드의 파드를 제거해야 이 노드에 배치할 수 있는 상황이 있다. 스케줄러는 이런 cross-node 선점을 수행하지 않는다.
In order to schedule Pod P on Node N, Pod Q can be preempted, but scheduler does not perform cross-node preemption. So, Pod P will be deemed unschedulable on Node N.
여러 노드에 걸친 선점이 필요하면 앞에서 본 out-of-tree CrossNodePreemption 플러그인 같은 것을 고려해야 한다.
그룹 단위 선점은 지원되지 않는다
선점은 파드 하나를 위해 파드 여러 개를 종료시킬 수 있지만, 종료 대상이 다른 그룹 워크로드(예: 분산 학습 작업)의 일부라면 그 그룹의 남은 파드는 의미 없이 자원을 점유한 채로 남는다. 그룹을 단위로 선점하는 job-level preemption은 v1.32 기본 플러그인에 없다(1편 - 프로필과 별도 바이너리의 선택 기준). 이후 버전에서는 워크로드 단위 선점(KEP-5710)이 v1.36 alpha로 들어왔고, v1.37에서 GenericWorkload 게이트(beta, 기본 비활성)로 합쳐졌다(5편).
QoS는 고려되지 않는다
선점 대상 선택에서 QoS 클래스(Guaranteed / Burstable / BestEffort)는 판단 기준이 아니다. 우선순위와 QoS는 서로 직교하는 기능이다.
정리
이 글에서 다룬 핵심 내용을 정리한다.
- 스케줄러는 3개의 큐로 파드를 관리한다. Active Queue에서만 스케줄링을 시도하고, 실패 시 Backoff Queue 또는 Unschedulable Queue로 분류한 뒤, 조건 충족 시 Active Queue로 복귀시킨다.
- 정상 경로는 PreEnqueue → QueueSort → PreFilter → Filter → PreScore → Score → NormalizeScore → Reserve → Permit → PreBind → Bind → PostBind다. PostFilter는 이 순서에 포함되지 않고, PreFilter에서 파드가 거절되었거나 Filter에서 모든 노드가 탈락했을 때만 분기하는 실패 경로다.
- Filter는 부적합 노드를 탈락시키고, Score는 최적 노드를 선택한다. Filter에서는
requests기준으로 리소스를 판단하며,required조건만 체크한다. Score에서는preferred조건과 리소스 분산 전략 등을 반영하여 점수를 산출하고, NormalizeScore로 0~100에 맞춘 뒤 가중 합산한다. 동점이면 균등 무작위로 고른다. - 하나의 플러그인이 여러 extension point에 등록될 수 있다. v1.32 기준
NodeResourcesFit과NodeAffinity가 PreFilter·Filter·PreScore·Score 네 곳,VolumeBinding이 여섯 곳에 등록된다. Score 가중치는TaintToleration(3),NodeAffinity/PodTopologySpread/InterPodAffinity(2), 나머지(1)다. - 큐 재시도는 EnqueueExtension + QueueingHint로 효율화된다. 플러그인이 “의미 있는 이벤트 타입”을 선언하고(1단계), 콜백이 “이 구체적 이벤트가 이 파드에 관련 있는가”를 판단한다(2단계). 반환값은
Queue와QueueSkip두 가지이며, 백오프 경유 여부는 큐가 결정한다. - 선점은 PriorityClass 기반으로 동작한다. 우선순위가 정의되지 않으면 선점은 발생하지 않는다. victim 노드 선택은 PDB 위반 최소부터 시작하는 6단계 기준을 따르고, victim은 Delete API로 삭제되므로 PDB는 best-effort로만 존중된다.
nominatedNodeName은 예약 마커일 뿐, 보장이 아니다. 끼어들기를 방지하고 다음 사이클에서 우선 탐색되지만, 다른 노드가 먼저 비거나 더 높은 우선순위 파드가 도착하면 결과가 달라진다.- 선점에도 한계가 있다. 낮은 우선순위 파드에 affinity를 걸면 선점하지 않고, cross-node 선점은 수행하지 않으며, 그룹 단위 선점은 v1.32 기본 플러그인에 없다.
앞의 큐 구조와 함께 이해하면, 파드가 왜 Pending 상태에 빠지는지, 어떤 조건에서 빠져나올 수 있는지를 체계적으로 파악할 수 있다. 3편에서는 스케줄링 제어 설정(Scheduling Gate, nodeSelector, Node Affinity, Taints/Tolerations 등)을 다룬다.
파드 단위 처리의 한계와 PodGroup 스케줄링은 5편에서, Extension Point의 결정권 분류와 PreScore 역할 등 Scheduling Framework 내부 동작은 6편에서 자세히 다룬다.
참고 링크
- Scheduling Framework - Kubernetes 공식 문서
- Pod Priority and Preemption - Kubernetes 공식 문서
- 파드 Scheduling Readiness - Kubernetes 공식 문서
- Specifying a Disruption Budget for your Application - Kubernetes 공식 문서
- Scheduler Performance Tuning - Kubernetes 공식 문서
- kubernetes-sigs/scheduler-plugins
- Scheduling queue in kube-scheduler - kubernetes/community
이 글을 참조하는 글
- [Kubernetes] Kubernetes Deployment 재배포 실패 원인과 해결 - 1. Deployment 업데이트 전략
- [Kubernetes] Kubernetes Deployment 재배포 실패 원인과 해결 - 2. 분석 및 해결
- [Kubernetes] 쿠버네티스 스케줄링 - 0. 스케줄링 일반 개념과 쿠버네티스
- [Kubernetes] 쿠버네티스 스케줄링 - 1. 개념과 kube-scheduler 구조
- [Kubernetes] 쿠버네티스 스케줄링 - 3. 스케줄링 제어
- [Kubernetes] 쿠버네티스 스케줄링 - 4. 스케줄러 설정과 최적화
- [Kubernetes] 쿠버네티스 스케줄링 - 5. 파드 단위 스케줄링의 한계와 Gang Scheduling
- [Kubernetes] 쿠버네티스 스케줄링 - 6. Extension Point 심화와 스케줄링 실패 진단
댓글남기기